
Heute veröffentlichen wir Command A+ Open-Source. Ein Mixture-of-Experts (MoE)-Modell, Command A+ ist ein effizientes, vielseitiges und privat einsetzbares LLM, das für hochleistungsfähige agentische Aufgaben mit minimalem Rechenaufwand konzipiert ist.
Entstanden aus einem Jahr der Implementierung von North mit unseren Kunden, übertrifft es jede vorherige Generation in der Command-Reihe und vereint deren Funktionen in einem einzigen skalierbaren Modell.
Command A+ ist ab sofort unter einer Apache 2.0 Lizenz frei verfügbar und treibt damit Coheres Mission voran, souveräne KI-Technologie zur Realität zu machen. Entwickler erhalten direkten Zugriff auf Agentenfunktionen auf Enterprise-Niveau – von Experimenten über die Bereitstellung bis hin zu produktiven Workflows.
Besuchen Sie Hugging Face, um die Weights – in mehreren nahezu verlustfreien Quantisierungen verfügbar – herunterzuladen und unsere Implementierungsanleitungen zu lesen. Für eine dedizierte, verwaltete Inferenzumgebung können Sie Command A+ in Model Vault bereitstellen.
Snapshot
| Model | command-a-plus-05-2026 |
|---|---|
| License | Apache 2.0 |
| Architecture | Sparse / MoE |
| Model size | 218B total; 25B active |
| Context length | 128K input context; 64K max generation |
| Input modalities | Text, image, tool use |
| Output modalities | Text, reasoning, tool use |
| Languages | Supports 48 languages. Full list |
| Optimized for | Reasoning, agentic workflows, RAG, multilingual, multimodal document processing |
| Supported frameworks | vLLM, Transformers |
| Hardware (minimum) | 1× B200 @ W4A4 2× H100s @ W4A4 |
Northwards
Im vergangenen Jahr war North – Coheres integrierter Corporate Workspace zum Erstellen und Bereitstellen von Agentic-KI – die treibende Kraft hinter vielen unserer Innovationen. Dabei hatten wir uns zum Ziel gesetzt, ein einheitliches Modell für Kunden zu entwickeln, das die Bereitstellung vereinfacht, lokal ausgeführt werden kann und Funktionen aus der gesamten Command-Familie zusammenführt.
Die Arbeit zahlt sich bereits aus. Lesen Sie, wie unsere Kunden North nutzen, um ihre Prozesse zu transformieren.
Souveräne KI ist jedoch viel mehr als nur Cohere. Ingenieuren Modelle an die Hand zu geben, die sie selbst ausführen, kontrollieren und anpassen können, ist die größte Herausforderung, vor der diese Generation der KI steht.
Wir haben Command A+ für die Praxis und Entwickler optimiert – mit Unterstützung für Low-Bit-Quantisierung, effiziente Inferenz und Integration in offene Inferenz-Frameworks. KI-Unabhängigkeit für alle.
Wir sind gespannt darauf, was die Community damit erschafft.
Command, konsolidiert
Command A+ übertrifft frühere Command-A-Modelle in zentralen Aspekten von Unternehmensanwendungen, darunter multimodales Verständnis, Retrieval, langfristige Planung und komplexe Schlussfolgerungen.
| Command A+ | Command A | Command A Reasoning | Command A Vision | Command A Translate | |
|---|---|---|---|---|---|
| Size | 218B A25B | 111B | 111B | 112B | 111B |
| Reasoning | — | — | — | ||
| Multimodal | — | — | — | ||
| Tool use | — | — | |||
| Multilingual | 48 | 23 | 23 | 6 | 23 |
Bild 2: Vergleich der Fähigkeiten von Command A+ mit anderen Modellen in der Command A Familie.
Im Vergleich zu Command A Reasoning stiegen die 𝜏²-Bench-Telecom-Werte von 37 % auf 85 %, wobei die agentische Codierleistung bei Terminal-Bench Hard von 3 % auf 25 % anstieg. Auch bei nicht-agentischem Reasoning, der Befolgung von Anweisungen und anderen Code-Generierungsaufgaben wurden Verbesserungen erzielt.
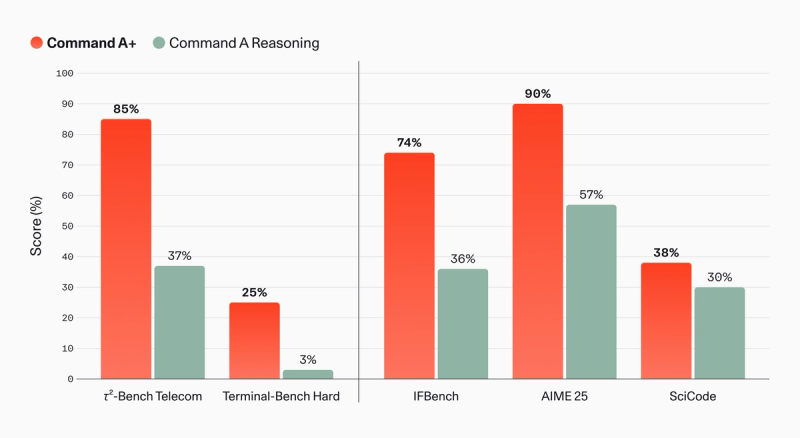
Image 3: Performance for Command A+ and Command A Reasoning on a range of popular open-source benchmarks. See footnote for further details. 1
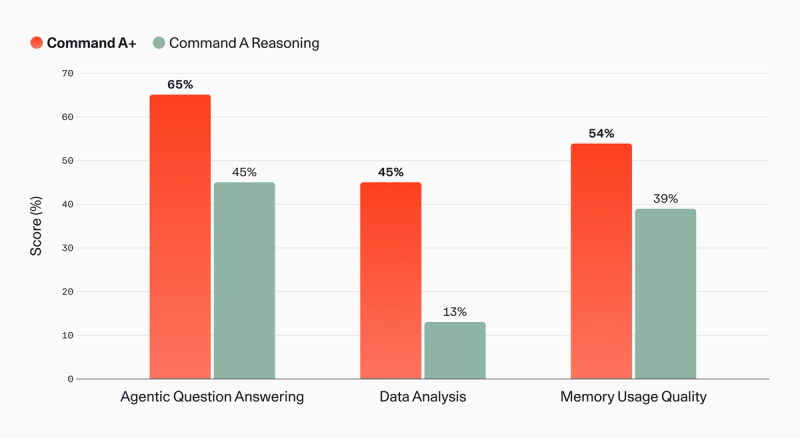
Command A+ liefert in North-Anwendungen starke Ergebnisse, was seine ursprünglichen Designziele widerspiegelt. Die Genauigkeit bei der agentischen Beantwortung von Fragen und die Qualität der Tabellenanalyse verbesserten sich im Vergleich zu Command A Reasoning um 20 % bzw. 32 %. Die Gedächtnisleistung – die Fähigkeit von North, über Gespräche und gespeicherte Daten hinweg logisch zu schließen – erreichte mit Command A+ 54 % im Vergleich zu 39 % mit Command A Reasoning.
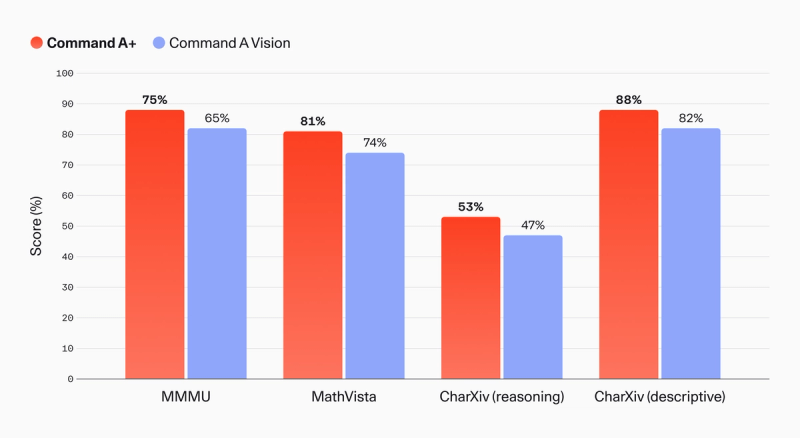
Für multimodales Verständnis und Schlussfolgerungen erreichte Command A+ 63 % bei MMMU Pro und 75,1 % bei MMMU (im Vergleich zu 65,3 % für Command A Vision beim Letzteren). MathVista-Ergebnisse stiegen von 73,5 % auf 80,6 %, und CharXiv-Schlussfolgerungen verbesserten sich von 46,9 % auf 52,7 %, was breite Fortschritte in Aufgaben zum Verständnis von Dokumenten widerspiegelt.
Command A+ erweitert die mehrsprachige Funktionalität erheblich, indem es die Sprachabdeckung von 23 auf 48 Sprachen ausweitet und Verbesserungen bei der maschinellen Übersetzung und mehrsprachigen Schlussfolgerungen erzielt.
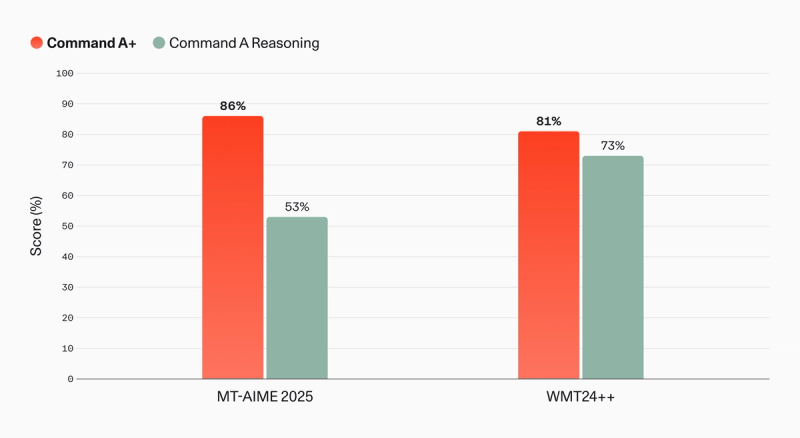
Image 6: comparison of multilingual performance for Command A+ and Command A Reasoning. MT-AIME 2025 is an internal translation of AIME-2025 — an English-language mathematics benchmark — evaluated for Arabic, Japanese, and Korean. WMT24++ is a widely used public benchmark, evaluated here for xCOMETxl. 2
Command A+ erreichte einen Wert von 37 im Artificial Analysis Intelligence Index, übertraf damit andere führende Open-Source-Modelle und unterstrich seine Stärke als universelles Modell für unternehmensinterne Agenten-Workflows [3].
Effizienz im großen Maßstab
Effizienz ist eine zentrale Einschränkung bei der Bereitstellung von KI in Unternehmen. Sie bestimmt, ob ein Sprachmodell praktisch im großen Maßstab eingesetzt werden kann, indem sie die benötigte Rechenleistung, den Speicherbedarf, die Latenz, den Stromverbrauch und die Infrastruktur beeinflusst, die für eine zuverlässige und kosteneffektive Bereitstellung erforderlich sind.
Wir haben Command A+ so konzipiert, dass es äußerst hardwareeffizient ist. Das Modell ist ab sofort auf Hugging Face in 16-Bit (BF16), 8-Bit (FP8) und 4-Bit (W4A4) Quantisierungen erhältlich, wobei die Qualitätsunterschiede kaum wahrnehmbar sind. In der Praxis ermöglicht dies den Einsatz von Command A+ auf nur zwei NVIDIA H100s oder einer einzelnen NVIDIA Blackwell GPU, ohne nennenswerte Qualitätsverluste.
Command A+ ist auch unser bisher schnellstes Modell mit insgesamt 218 Mrd. und 25 Mrd. aktiven Parametern im Vergleich zur 111 Mrd. dichten Architektur von Command A Reasoning. Bei gleicher Quantisierung und gleichzeitiger Ausführung liefert es bis zu 63 % mehr Output-Tokens pro Sekunde (TOPS) und reduziert die Time To First Token (TTFT) um bis zu 17 %. Die W4A4-Quantisierung trägt zu einer zusätzlichen Geschwindigkeitssteigerung von 47 % und einer weiteren Latenzreduzierung von 13 % bei.
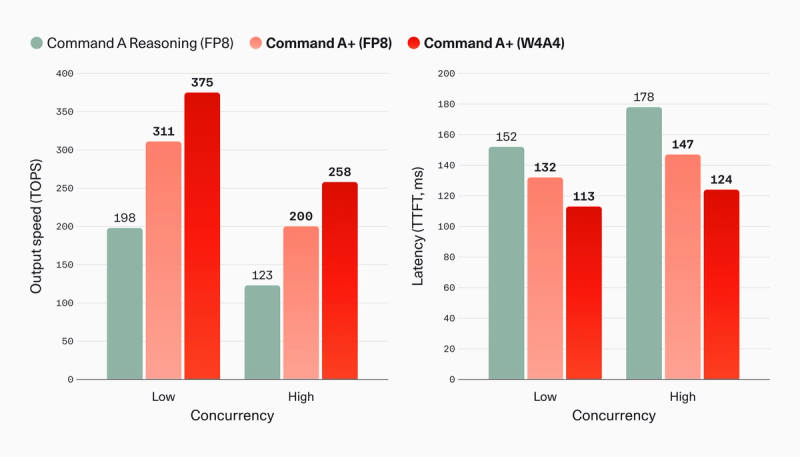
Image 7: Speed and latency of Command A+ compared with Command A Reasoning under different concurrencies and model quantizations. TOPS = tokens per second received while the model is generating tokens (ie. after the first chunk has been received from the API). TTFT = time to first token received, in seconds, after API request sent. 4
Wir setzen auch auf spekulatives Decoding, um die Textgenerierung zu beschleunigen, ohne die Ausgabequalität zu beeinträchtigen. Unser Ansatz ist speziell für die MoE-Architektur des Modells optimiert und ermöglicht eine zusätzliche 1,5- bis 1,6-fache Beschleunigung der Inferenz bei Text- und multimodalen Eingaben. Mehr zu unserer Arbeit erfahren Sie hier.
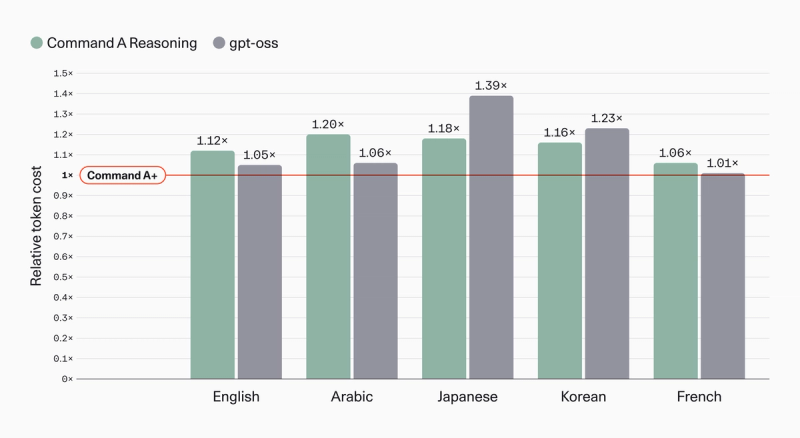
Command A+ ist das erste Modell, das unseren neuesten Tokenizer nutzt und so erhebliche Verbesserungen bei der Komprimierung gegenüber seinem Vorgänger bietet. Es werden weniger Token benötigt, um dieselbe Antwort zu generieren, was einen Hauptfaktor für Inferenzkosten reduziert. Bemerkenswert ist, dass diese Vorteile auch für wichtige nicht-europäische Sprachen gelten, die beim Training von Tokenizern oft unterrepräsentiert sind. Die Tokenisierungseffizienz verbesserte sich um 20 % für Arabisch, 16 % für Koreanisch und 18 % für Japanisch.
Fujitsu ist überzeugt, dass die Mixture-of-Experts-Architektur von Command A+ und seine starke agentische Leistung hervorragend zu unserem Engagement passen, innovative, souveräne KI-Lösungen über Takane und die Kozuchi Enterprise AI Factory bereitzustellen. Wir freuen uns darauf, seine Fähigkeiten zu nutzen, um die sichere, skalierbare KI-Einführung für unsere Kunden zu beschleunigen.
Vivek Mahajan
Corporate Executive Officer, Corporate Vice President, CTO, verantwortlich für Systemplattformen
Fujitsu Limited
Was kommt als Nächstes?
Fortschritte bei souveräner KI erfordern heute gleichzeitige Innovationen in drei Bereichen: Leistung, Sicherheit und Kosten. Bei Cohere investieren wir in alle drei Bereiche – sowohl in unsere Modelle als auch in die domänenspezifischen Funktionen, die North antreiben.
Das bedeutet eine Verbesserung von logischem Denken, multimodalem Verständnis und Programmierleistung, während sichergestellt wird, dass die Modelle weiterhin vollständig in den Umgebungen der Kunden ausgeführt werden können. Das Ziel sind nicht nur stärkere Benchmarks, sondern Systeme, die unternehmensweite Transformationen unter realen Betriebsbedingungen unterstützen können.
Wir haben diesen Ansatz bereits auf unsere anderen Modellfamilien angewendet – darunter Embed, Rerank und Transcribe – und dabei State-of-the-Art-Performance bei effizienter, kostengünstiger Inferenz erreicht.
Erste Schritte
Command A+ ist ab sofort auf Hugging Face sowie über Model Vault verfügbar. Sie können das Modell auch kostenlos in unserem Space testen oder mit einem Cohere API-Schlüssel.
Besuchen Sie unsere Dokumentation, um detaillierte Modellspezifikationen, Bereitstellungsanleitungen und Cookbooks zu finden.
1 𝜏²-Bench Telecom evaluated using standard settings and user simulation from [Barres et al. 2025]. Terminal-Bench Hard evaluated using Terminus-2 harness following the methodology of Artificial Analysis. AIME 2025 is evaluated on the official 2025 set of 30 questions, each question being repeated 10 times. The score is the pass@1 over this 300 sample dataset. IFBench is for single turn, loose evaluation mode and the score reported corresponds to prompt accuracy over 1470 samples corresponding to 294 unique prompts repeated five times. Scicode evaluated using 65 test problems which includes 288 subproblems. We prompt each subproblem with the 'scientist-annotated background' following the methodology of Artificial Analysis.
2 MT-AIME was translated from English using Command A Translate. WMT24++ score is the average of 50 varieties: all supported languages, including ar_EG, ar_SA, pt_BR, pt_PT, zh_CN, zh_TW from the original WMT24++ test set. Serbian is evaluated with an internal transliteration to the Cyrillic script. Irish and Maltese are internally-created translations of WMT24++.
3 To train the Command A+ model efficiently at scale, we leveraged NVIDIA’s CUDA-X ecosystem (CUTLASS, cuBLAS, TE and NCCL) for high-performance computation, kernel optimization, and multi-GPU communication.
4 All models were measured on a single NVIDIA HGX B200 node (8 x GPUs), using vLLM with tensor parallelism (TP=8), against LiveCodeBench. Prompts were ~3K tokens with an 8K max output length.