Rerank 5 ist da: Schärfere Suche, weniger Token. Jetzt mit Context Focus.
Mehr erfahrenPlattform
Modelle
Bereitstellung
Nach Branche
Erkundungen
Initiativen
Ressourcen
Rerank 5 ist da: Schärfere Suche, weniger Token. Jetzt mit Context Focus.
Mehr erfahrenRERANK
Rerank leitet nur die relevantesten Dokumente an Ihre RAG-Pipeline und Agenten-Workflows weiter – reduziert Token-Nutzung, minimiert Latenz und steigert die Genauigkeit.
Geschätzt von Branchenführern und Entwicklern weltweit


Von der Verbesserung der Antwortqualität bis hin zur Bereitstellung hochwertiger Eingaben für KI-Agenten – Rerank ermöglicht präzises Retrieval-Ranking im Unternehmensmaßstab.
Steuern Sie KI-Agenten mit schlankeren, relevanteren Kontexten – minimieren Sie Trace-Bloat und verbessern Sie die Aufgabenabarbeitung.
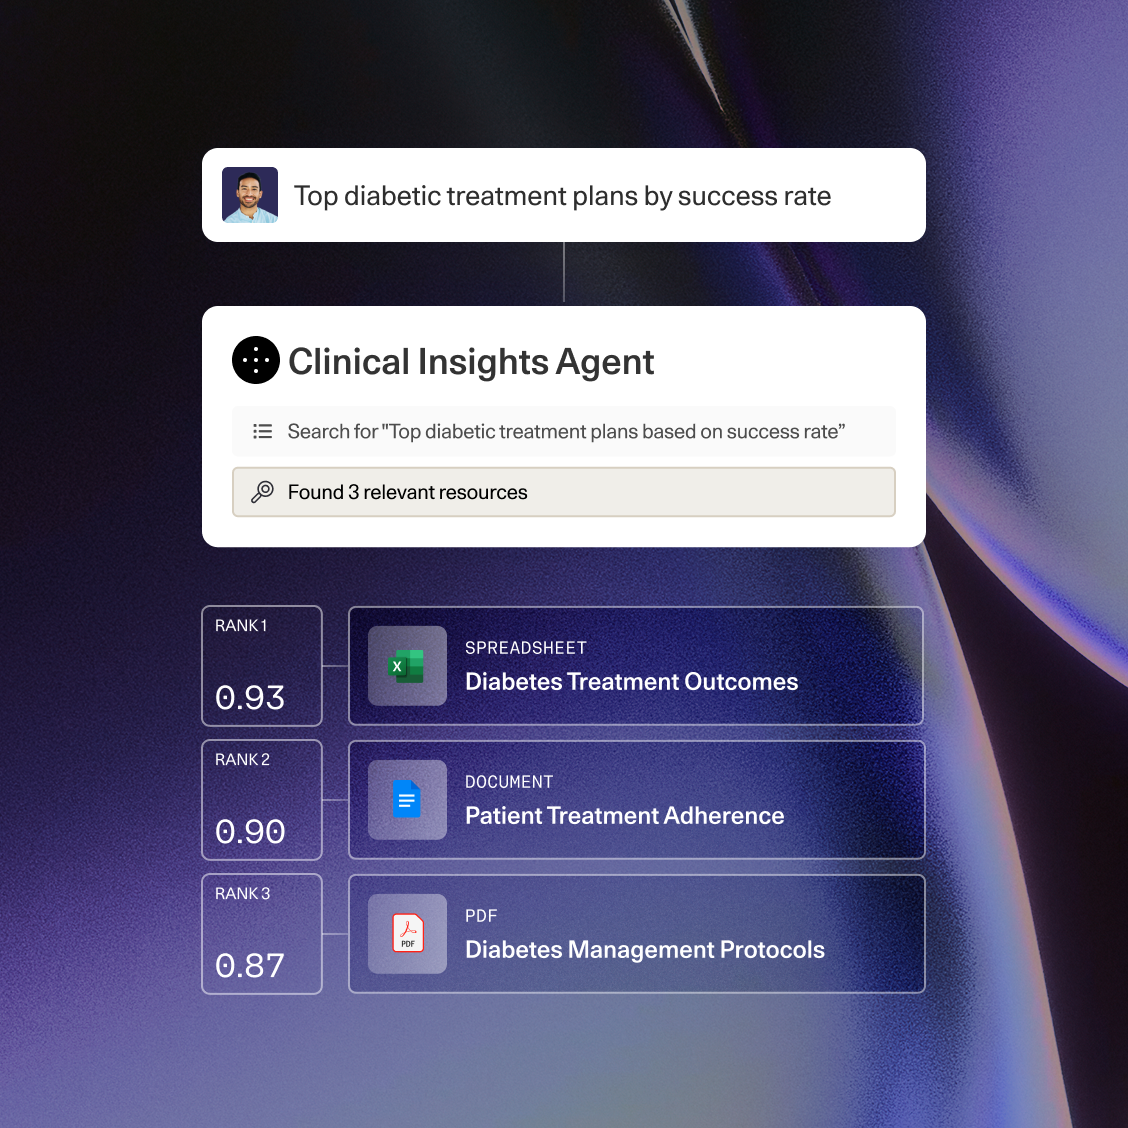
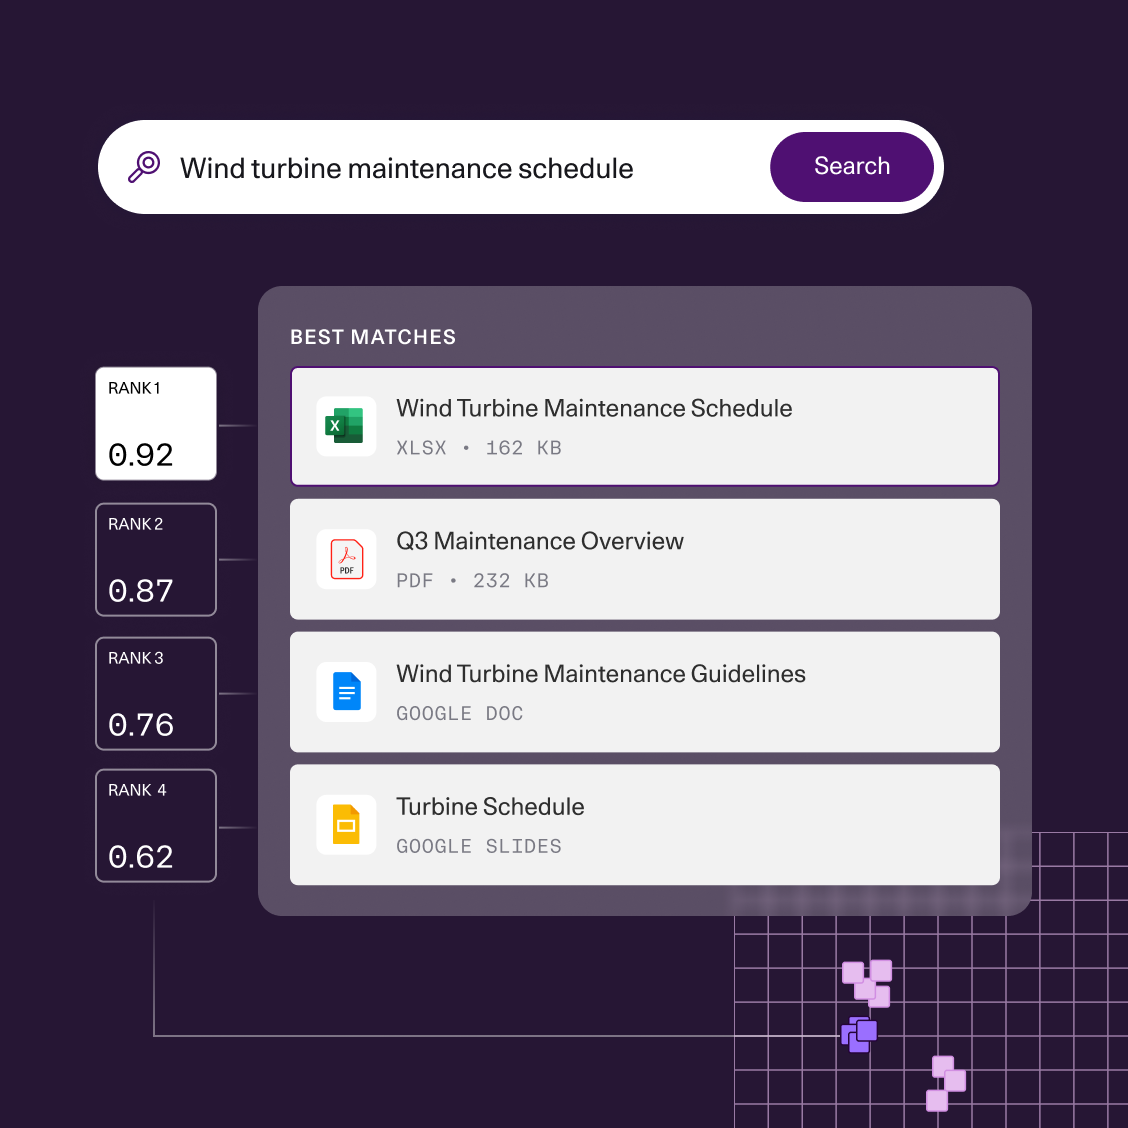
Rerank passt sich den Unwägbarkeiten realer Suchanfragen und Daten an – mit schnellen, präzisen und stets relevanten Ergebnissen.
Vergleicht Abfrage und Dokument direkt – für bessere Ergebnisse bei komplexen, ungenauen Suchanfragen.
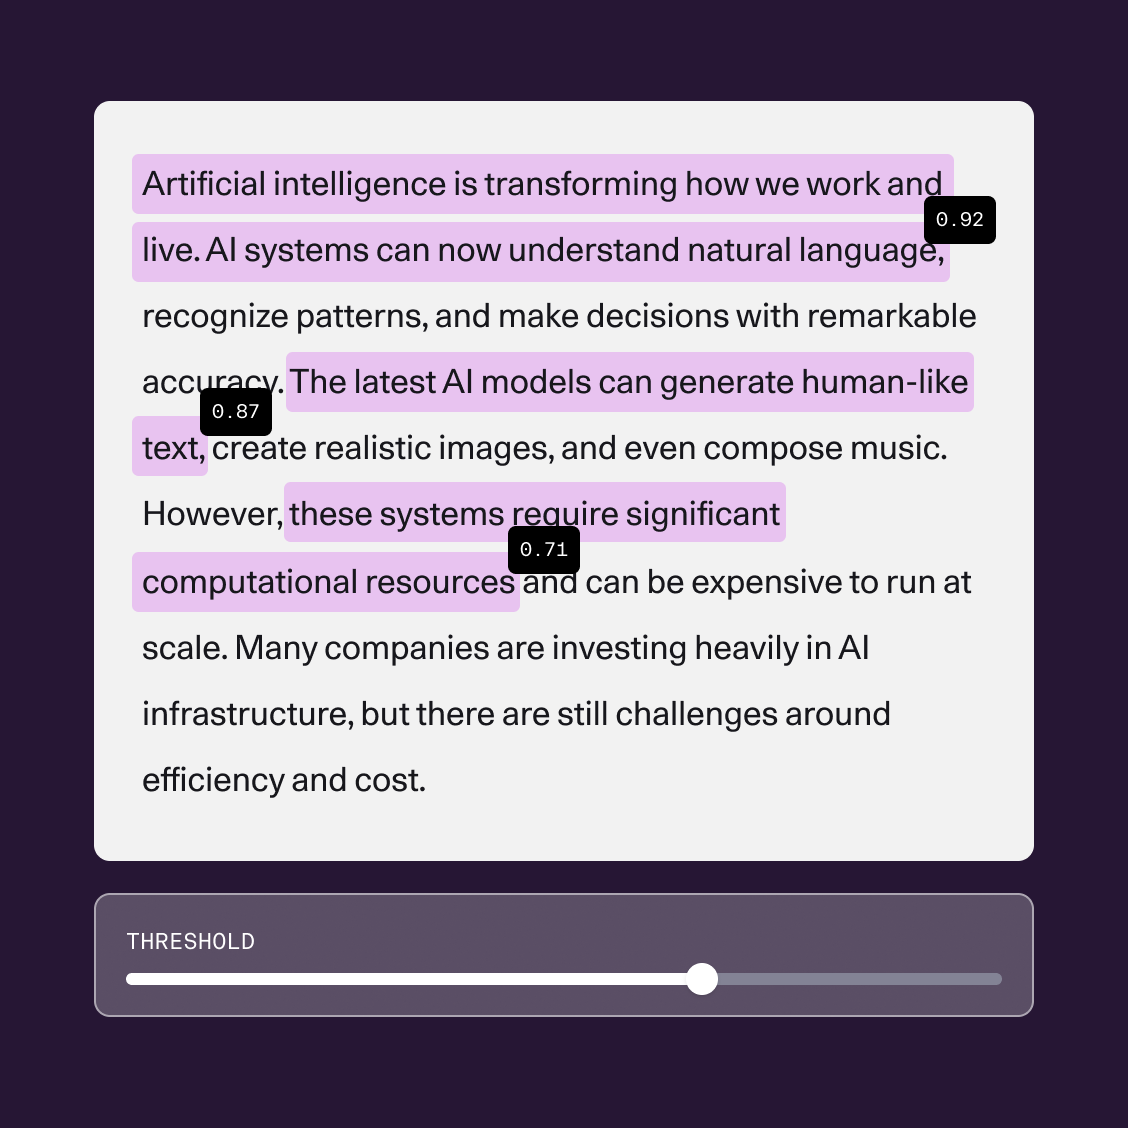
Senden Sie Ihrer KI nur die Informationen, die sie benötigt, und reduzieren Sie so Token-Kosten und Störgeräusche. Relevante Textabschnitte werden zusammen mit Dokumentenbewertungen in derselben Rerank-Anfrage zurückgegeben – ohne zusätzliches Modell oder Pipeline-Schritt. Legen Sie Schwellenwerte fest, um die Textmenge zu steuern, oder heben Sie Abschnitte hervor, damit Nutzer:innen sehen, warum ein Ergebnis übereinstimmt.
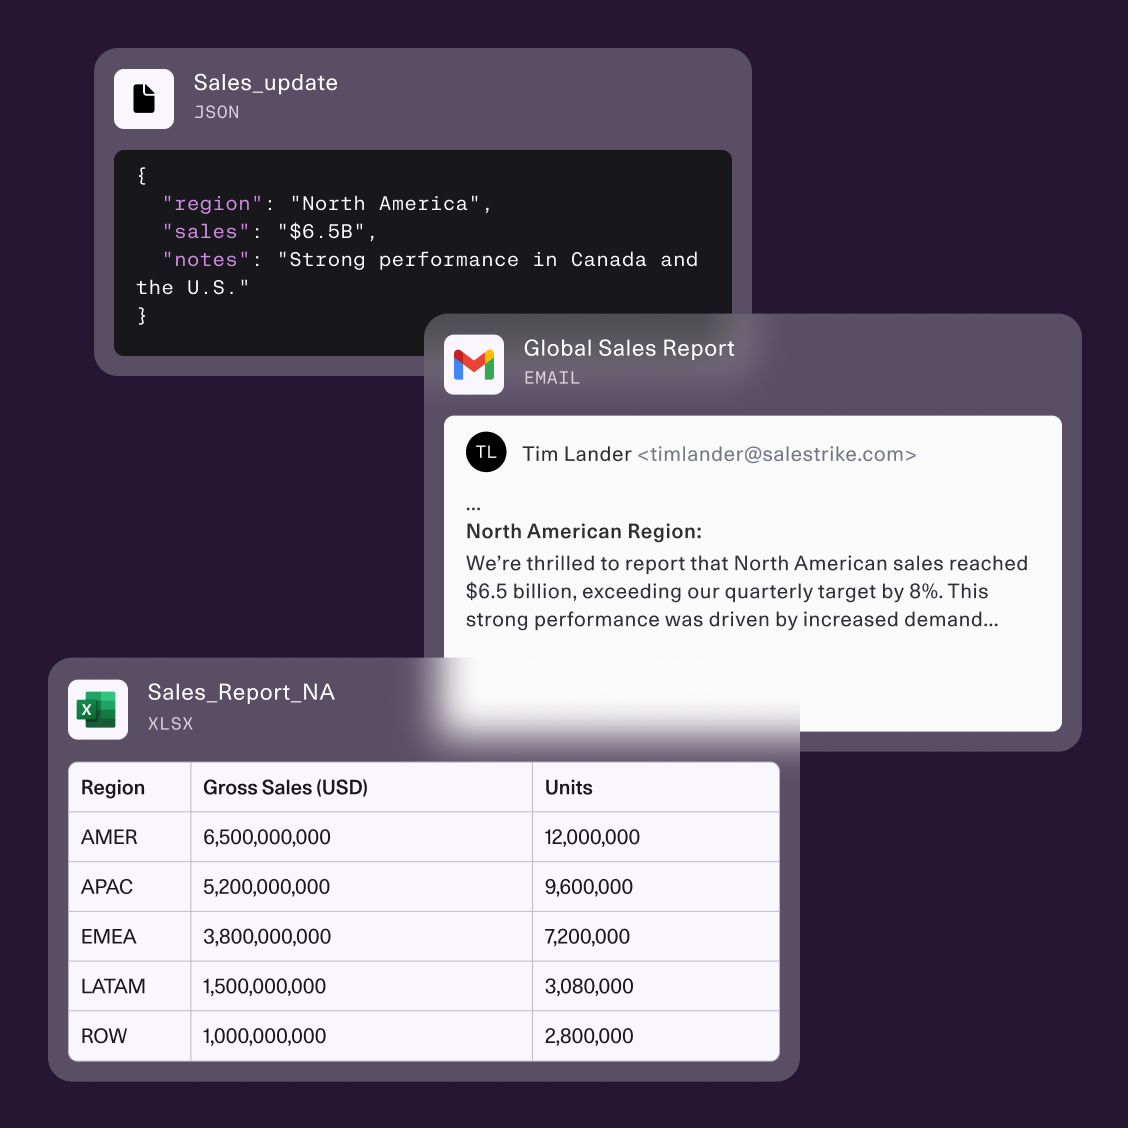
Relevante Ergebnisse in über 100 Sprachen und visuell reichhaltigen oder halbstrukturierten Formaten finden – einschließlich E-Mails, Tabellen, JSON und Code.
Erfahren Sie, wie Rerank die Präzision unserer Workplace-KI-Tools North und Compass erhöht.

Mit Command, Compass, Embed und Rerank als Basis vereint North sichere KI-Agenten, erweiterte Suchfunktionen und führende generative KI – alles an einem Ort.
Mehr erfahren

Schöpfen Sie das Potenzial Ihrer Daten mit einem intelligenten Such- und Entdeckungssystem aus, das keine Kompromisse bei der Sicherheit eingeht.
Mehr erfahren
— VP of Engineering, Nebius
Rerank 5 ist das neueste Reranking-Modell von Cohere. Es wird nach Ihrer bestehenden Schlüsselwort-, Vektor- oder hybriden Suche eingesetzt, ohne erneutes Indizieren, und stellt die relevantesten Ergebnisse an erste Stelle.
Ein Reranker ist die zweite Stufe einer Suchpipeline. Nachdem die Erststufen-Suche eine Auswahlliste erstellt hat, liest der Reranker die Abfrage zusammen mit jedem Ergebnis und ordnet sie neu an, sodass die relevantesten zuerst kommen.
Ja, wenn Genauigkeit wichtig ist. Rerank 5 liest die Abfrage und jedes Ergebnis zusammen, sodass Details erfasst werden, die bei der Vektorsuche übersehen werden können, wie z. B. Zahlen, Daten und Negationen.
Das ist langsamer und kostet mehr. Die Rangfolge von 100 Ergebnissen mit einem LLM erfordert mehrere aufeinanderfolgende Aufrufe, und jeder irrelevante Token, den Sie senden, kostet Geld und kann die Antwortqualität mindern. Rerank erledigt die Aufgabe in einem Aufruf.
Pro ist am genauesten und eignet sich für komplexe Abfragen und Fachdokumente. Fast ist auf Geschwindigkeit und Volumen ausgelegt, z. B. für interaktive Suche und Agents, und übertrifft dennoch viele führende Marktalternativen.
Context Focus ist eine optionale Funktion von Rerank 5, die die relevantesten Passagen in jedem Dokument in demselben Aufruf zurückgibt. Durch das Senden nur dieser Passagen an Ihr LLM werden Token mit minimalem Qualitätsverlust reduziert.
Die Bewertungen von Rerank 5 bedeuten in etwa dasselbe für alle Abfragen, sodass eine Schwelle überall funktioniert. Verwenden Sie sie, um schwache Übereinstimmungen zu entfernen, einen Assistenten sagen zu lassen „Ich weiß es nicht“ oder eine andere Suche auszulösen.
RCP-nDCG@10 ist die Methode von Cohere zur Bewertung der 10 besten Suchergebnisse und das Metrik, das zur Bewertung von Rerank 5 und Embed 5 verwendet wird. Standard-nDCG berücksichtigt nur die Dokumente im Antwortschlüssel eines Benchmarks. RCP-nDCG bewertet stattdessen jedes Ergebnis anhand derselben Relevanzkriterien und wurde mit menschlichen Blindurteilen validiert.
Sprechen Sie mit unserem Team, um zu erfahren, wie Rerank Ihnen helfen kann, die Ergebnisqualität zu verbessern, die Systemlast zu reduzieren und semantische Suche in die Produktion zu skalieren.