
Für viele Unternehmen aus verschiedenen Branchen hat sich der Einsatz von Künstlicher Intelligenz von einem reinen Experiment zu einer notwendigen Investition entwickelt. Ihre Digitalisierungsstrategien wachsen mit den KI-Innovationen. Dennoch verstehen viele Unternehmen die wirtschaftlichen Grundlagen dessen, was sie beim Kauf von KI-Technologien erhalten, nicht vollständig. Dies kann zu einem finanziellen Risiko werden, da KI-Arbeitsabläufe in ihrem Umfang zunehmen und zu einem festen Bestandteil der Geschäftstätigkeit werden.
Bei Cohere verstehen wir die Herausforderungen unserer Kunden im Zusammenhang mit den Gesamtkosten der KI-Eigentümerschaft (KI-TCO) und den strategischen Entscheidungen, wann KI-Technologie im Eigenbesitz genutzt werden soll und wann sie gemietet werden sollte – KI-Eigentum ist nicht einheitlich. In diesem Beitrag gehen wir sowohl auf die abgerechneten als auch auf die versteckten Kosten der Nutzung von KI in Ihrem Unternehmen ein und zeigen, wie Sie Ihre KI-Eigentumsstrategie angehen können.
Um mit dem Cohere-Vertrieb in Kontakt zu treten und Ihre Gesamtkosten für KI zu ermitteln sowie Möglichkeiten zur Senkung dieser Kosten zu besprechen, kontaktieren Sie uns.
So werden KI-Kosten berechnet
Die sichtbaren Kosten von KI werden in der Regel in Tokens angegeben. Tokens sind die Textfragmente, die ein Modell sowohl liest als auch generiert. Tokens fallen bei jeder Eingabe, Antwort, jedem abgerufenen Dokument, Agentenschritt, Tool-Aufruf, jeder Schleife und jedem Wiederholungsversuch an. Doch die Token-Preise sind nur ein Teil der Kosten – wenn auch der sichtbarste und unvorhersehbarste, da sich der KI-Einsatz bei effektiver Implementierung in einem Unternehmen stark skaliert.
Die größere Frage ist jedoch nicht, was ein Anbieter pro Million Token berechnet, sondern welche Kosten entstehen, wenn KI zu einem unverzichtbaren Bestandteil der Geschäftstätigkeit wird und im Unternehmen betrieben, gesichert und skaliert werden muss. Hier liegt die zentrale Herausforderung des KI-Einsatzes für Organisationen.
AI-Gesamtkosten steigen mit der Nutzung
Heute steigen die Gesamtkosten der Eigentümerschaft, da Unternehmens-KI zu einer der größten betrieblichen Ausgaben wird. Gartner prognostiziert, dass die weltweiten Ausgaben für KI bis 2026 2,52 Billionen US-Dollar erreichen werden, was einem jährlichen Anstieg von 44 % entspricht und hauptsächlich durch die Infrastruktur getrieben wird. Dies gewinnt an Bedeutung, da die Einführung von KI zunimmt, weil KI-Reife und Nutzung zu mehr Inferenz, längeren Kontextfenstern, mehr agentischen Schritten, erhöhten Retrieval-Anfragen und einer höheren Nachfrage nach Geschwindigkeit führen.
Eine Antwort auf dem Bildschirm kann eine Kette von Modellaufrufen, Dokumentensuchen, Tool-Aufrufen und Validierungsschritten darstellen – und diese Schritte sind nicht in der Infrastruktur oder Modellrechnungen versteckt.
Schichten des KI-Eigentums: Mieten und Besitz von Infrastruktur
Da KI zu einem Standardkostenfaktor für Unternehmen wird, müssen diese verstehen, was sie genau erwerben: Tokens, Latenz, Durchsatz, Auslastung, Datenkontrolle und die Fähigkeit, Ausgaben vorherzusagen. Unternehmen, insbesondere Finanzverantwortliche und diejenigen, die KI-Transformationsprojekte begleiten, müssen sich auf die Variablen konzentrieren, die Kosten treiben und gleichzeitig Kontrolle gewährleisten.
Unternehmen, die KI profitabel skalieren, sind nicht diejenigen, die am meisten ausgeben, sondern diejenigen, die herausfinden, welche KI-Fähigkeiten sie selbst bereitstellen und welche sie mieten sollten – und die Disziplin entwickeln, diese zu unterscheiden. Unternehmen, die alles mieten, kommen letztlich zu derselben Erkenntnis, wenn die Kosten untragbar werden oder die Kontrolle schleichend verloren geht.
Die versteckten Kosten von KI
Token-Ökonomie ist der naheliegende Ausgangspunkt, da sie erklärt, warum sich die Ausgaben für KI von denen für herkömmliche Software unterscheiden. Bei klassischem Cloud-Computing lassen sich Kosten auf bekannte Einheiten zurückführen: Server, Speicher, Bandbreite und Zeit. KI führt eine volatilere Recheneinheit ein.
Ein Token ist klein, aber die darauf aufbauenden Systeme sind es nicht. Eine einzelne Benutzeranfrage kann eine lange Eingabeaufforderung, ein großes Kontextfenster, mehrere Schlussfolgerungsschritte, diverse Tool-Aufrufe und eine ausgefeilte Endantwort auslösen. Der Benutzer erlebt eine Interaktion; das Unternehmen bezahlt für die gesamte Kette.
Deshalb können KI-Kosten steigen, ohne dass sich das Produkt sichtbar ändert. Teams erweitern möglicherweise den Kontext, um bessere Antworten zu erhalten, fügen Retrieval-Funktionen hinzu, um Halluzinationen zu reduzieren, integrieren Agent-Schleifen für komplexe Aufgaben oder leiten Anfragen an größere Modelle weiter – alles sinnvolle Entscheidungen, die in Kombination die Kostenprofile jedoch dramatisch verändern.
Betrachtung des gesamten KI-Systems
Der häufige Fehler besteht darin, den Token-Preis als Einheitskalkulation zu betrachten. Das ist er nicht. Die Gesamtkosten des Eigentums sind das System, das den Token erzeugt. Die relevanten Fragen sind weiter gefasst:
- Wie viele Token verbraucht eine Aufgabe?
- Wie viele Modellaufrufe stecken hinter einer Benutzeraktion?
- Welches Modell übernimmt jeden Schritt und wie wird weitergeleitet?
- Wie viel Kontext wird übergeben?
- Wie oft versucht das System es erneut?
- Welche Latenz erfordert das Unternehmen?
- Wird die bezahlte Infrastruktur tatsächlich genutzt?
Ein Großteil davon wird von der Infrastruktur, aber auch von der Notwendigkeit angetrieben, dass Unternehmen an der Spitze der digitalen Innovation stehen müssen, um wettbewerbsfähig zu bleiben. Daher neigen Unternehmen dazu, die größten Modelle zu nutzen, die an der Spitze der kommerziell verfügbaren Innovation stehen. So hieß es beispielsweise in einer Ergebnispräsentation von Uber, dass „10 % des firmeneigenen Codes von autonomen Agenten erstellt werden“, was mit der Tatsache einherging, dass das Unternehmen sein AI-Budget für 12 Monate in nur vier Monaten aufbrauchte.
Schlagzeilen gab es zuhauf, aber die Herausforderung blieb: KI steigerte die Produktivität von Unternehmen, doch für Führungskräfte, die sich um Umsatzprognosen sorgen, darf Innovation nicht auf Kosten ungenauer Vorhersagen gehen.
Die Überraschung ist bereits auf allen Märkten sichtbar
Aktuelle Studien zeigen das Ausmaß unerwarteter AI-Infrastrukturkosten auf. Laut einem im Auftrag von DataRobot erstellten IDC InfoBrief vom
Dezember 2025, sahen sich 96 % der Unternehmen, die generative KI einsetzen, und 92 % der Unternehmen, die agentische KI nutzen, mit höheren als erwarteten Kosten konfrontiert. Diese weit verbreiteten Überschreitungen deuten darauf hin, dass aktuelle Planungsmodelle nicht mit der tatsächlichen Auslastung übereinstimmen. Gartner geht davon aus, dass KI in das „Tal der Enttäuschung“ eintreten wird, wobei die Hauptbarriere für die Skalierung die Unvorhersehbarkeit der Renditen und nicht mangelnde Ambitionen sein wird.
Eine McKinsey-Umfrage aus November 2025 unter fast 2.000 Organisationen in 105 Ländern ergab, dass zwar eine weit verbreitete Einführung von KI zu beobachten ist, aber nur etwa ein Drittel sie unternehmensweit skaliert und lediglich 5–6 % signifikante finanzielle Auswirkungen melden. Die Lehre daraus ist klar: Unvorhersehbare Ausgaben ohne klaren Mehrwert bestrafen ein schlechtes Kostenmanagement.
Prognosen und Governance bleiben eine Herausforderung. Eine Umfrage von Mavvrik und Benchmarkit aus dem Jahr 2025 ergab, dass 80 % der Unternehmen ihre Prognosen zur KI-Infrastruktur um mehr als 25 % verfehlen und fast 25 % sogar um mehr als 50 %. Nur 15 % liegen innerhalb von 10 % ihrer tatsächlichen Ausgaben. Darüber hinaus berichten 84 % der Unternehmen über einen Rückgang der Bruttomarge um 6 % oder mehr aufgrund der KI-Infrastruktur. Für Softwareunternehmen handelt es sich dabei um wiederkehrende Kosten und nicht um freiwillige Innovationsausgaben. Die wichtigste Erkenntnis ist, dass die begrenzte Transparenz die Verwaltung von KI-Kosten erschwert, insbesondere da nur etwa ein Drittel der Unternehmen über die On-Premise-KI-Ausgaben berichtet.
Weitere Kostenüberlegungen
Kosten sind nicht das einzige Problem. Wenn Regierungen die KI-Governance und -Standards verstärken und auf extern betriebene Modelle zurückgreifen, entstehen Risiken in Bezug auf Zugriff, Bedingungen und Verfügbarkeit. Das praktische Problem besteht darin, dass ein Modell, das nicht unter der Kontrolle des Unternehmens steht, im Wesentlichen eine gemietete Fähigkeit darstellt.
Derzeit steigen die Kosten für KI schneller als herkömmliche Technologieausgaben, treten oft später auf und folgen keinen vorhersehbaren Mustern. Selbst kleine Änderungen an der Agentenorchestrierung oder den Prompts können den Tokenverbrauch erheblich erhöhen. Kosten, die sich nicht zuordnen oder verwalten lassen, können nicht vollständig kontrolliert werden.
Kapital- und Betriebskosten von KI
Bei der Investition in KI-Systeme sind zwei unterschiedliche Kostenarten zu berücksichtigen: Kapital- und Betriebskosten. Kapitalausgaben umfassen Vermögenswerte, die ein Unternehmen besitzt, wie Chips, Server, Speicher und Netzwerkgeräte. Diese Investitionen sind oft physisch und mit hohen anfänglichen Kosten sowie einer Abschreibung über die Zeit verbunden. Betriebsausgaben beinhalten gemietete oder nutzungsbasierte Ressourcen wie Cloud-Instanzen, Tokens, Strom, Kühlung und Stellfläche. Während diese Betriebskosten leichter zu initiieren sind, werden sie im großen Maßstab erheblich.
Hauptkostentreiber in beiden Kategorien sind: Durchsatz (Tokens pro Sekunde), Einzelpreis (Kosten pro Million Tokens), Reaktionszeit (Zeit bis zum ersten Token) und vor allem die Auslastung. Die Auslastung ist der entscheidende Faktor, um zu bestimmen, ob der Besitz oder die Miete kosteneffizienter ist.
AI-Kosten durch effiziente Implementierung senken
Die Hardware bestimmt die maximale Kapazität, die tatsächliche Leistung hängt jedoch von der Effizienz des Modells ab und ist somit eine zentrale Variable für die Kostenvorhersage. Cohere-Modelle variieren in ihren Parametern und der Quantisierung, aber Ansätze wie das Routing von Token durch einen Teil der Modellparameter (Mixture-of-Experts- oder MoE-Methode) senken die Generierungskosten, ohne signifikante Leistungsverluste zu verursachen. Darüber hinaus können Modelle mit Low-Bit-Quantisierung die Durchsatzrate erhöhen und die Latenz reduzieren, was die Hardware-Auslastung maximiert.
Aus diesen Gründen ist das Modell-Routing, oder besser gesagt, die Auswahl des richtig dimensionierten Modells für eine bestimmte Aufgabe, wichtig, um die Kosten für die Modellinferenz zu senken. Diese Techniken sind unerlässlich, um eine kosteneffiziente Leistung auf eigener Hardware zu erreichen.
Dies ist der Grund, warum der reine Hardware-Preis allein ein schlechter Leitfaden für die Kosten ist. Laut NVIDIA, dessen Chips einen großen Anteil der weltweiten Inferenzleistung bereitstellen, ist nicht die theoretische Rechenleistung pro Dollar die entscheidende Metrik, sondern die tatsächlichen Kosten der Inferenz – insbesondere die Kosten pro erzeugtem Token. Nach eigener Aussage kostet ein günstigeres GPU, das weniger Token pro Sekunde liefert, am Ende mehr pro Token, nicht weniger. Die Verbesserungen über die Generationen hinweg sind groß: NVIDIA berichtet, dass seine Blackwell-Klasse-Systeme etwa 50 Mal mehr Token pro Megawatt als die vorherige Hopper-Generation liefern, wodurch die Kosten pro Token rund um das 35-fache gesenkt werden.
Um den Kompromiss konkret zu machen, stellen Sie sich einen kontinuierlich laufenden Kundensupport-Assistenten vor: sagen wir, eine halbe Million Anfragen pro Tag, einige Tausend Token pro Anfrage, einschließlich der Abrufe und Wiederholungsversuche hinter jeder Antwort. Über eine gemietete API laufen Nutzung und Kosten ununterbrochen weiter. Führen Sie dieselbe Arbeitslast auf eigenem Hardware-Equipment aus, kehrt sich die Kostenstruktur um. Die Hardware wird zu einer festen, abschreibungsfähigen Ausgabe, und jede zusätzliche Anfrage danach ist fast kostenlos. Unter einem bestimmten Volumen gewinnt die API, da ungenutzte Hardware reine Verschwendung ist; darüber hinaus setzt sich die KI-Eigentümerschaft durch und der Abstand vergrößert sich mit jedem Token.
Im Maßstab von Rechenzentren zeigt sich die Lücke in harten Zahlen. Eine Lenovo-Analyse aus dem Jahr 2026 wurde auf eigenen 8-GPU-Servern durchgeführt, die Modelle mit 70 bis 405 Milliarden Parametern bereitstellten – ein größerer Fußabdruck als das oben genannte Einzelbeispiel. Sie ergab, dass die amortisierten Kosten für die Generierung einer Million Token auf eigener H100-Hardware bei etwa 0,11 $ lagen, gegenüber etwa 0,89 $ für die entsprechende Cloud-Instanz und rund 2,00 $ für eine vergleichbare Frontier-API.
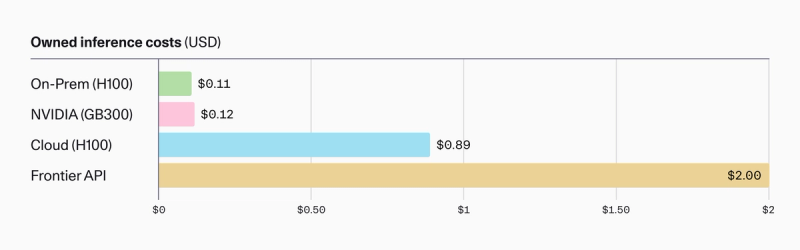
Das ist ein achtfacher Vorteil gegenüber gemieteter Cloud-Infrastruktur und sogar ein achtzehnfacher Vorteil gegenüber dem Kauf von API-Tokens. Bei kontinuierlicher Nutzung über fünf Jahre können die Einsparungen pro Server in die Millionen von Dollar gehen. Die gleiche Analyse ergab, dass sich ein Server mit 8 GPUs in weniger als vier Monaten amortisiert – allerdings nur im Vergleich zu den On-Demand-Cloud-Preisen, der teuersten Mietoption.
Zwei unabhängige Schätzungen, die mit unterschiedlichen Methoden ermittelt wurden, kommen für die selbstgehostete Inferenz auf ähnliche Werte. Lenovos ~0,11 $ basieren auf einem fünfjährigen Eigentumsmodell für H100s; NVIDIA gibt an, dass es auf seiner Flaggschiff-Plattform GB300 0,123 $ pro Million Token kostet. Dies wurde vom unabhängigen SemiAnalysis-Inferenzbenchmark InferenceX gemessen. Die Zahlen sind nicht direkt vergleichbar – die eine ist eine Abschreibung, die andere ein Inferenzbenchmark für neuere Chips –, aber wenn zwei Quellen für die selbstgehostete Ausgabe auf ähnliche Werte von ca. 0,11–0,12 $ kommen, während eine Cloud-Instanz etwa 0,89 $ und eine Frontier-API 2,00 $ kostet, ist das eine solidere Grundlage als jede der Zahlen für sich allein.
Zwei Dinge dämpfen diese Zahlen. Es handelt sich um Anbieterkosten, die auf der Hardware des Anbieters berechnet werden, sowie um absichtlich ausgelassene Speicher-, Ausgangs- und Unterstützungskosten auf der Cloud-Seite, sodass man sich vorstellen kann, dass die tatsächliche Spanne engerer ist als die Überschrift. Die selbe Vorsicht gilt auch für die Kosten pro Token selbst: Sie werden von NVIDIA berechnet und zeigen bequem NVIDIA-Chips, wobei Analysten anmerken, dass die Metrik in hoch optimierten, homogenen Umgebungen besser abschneidet als in ungeordneten Umgebungen in der realen Welt..
Und jede Zahl basiert auf einer anhaltend hohen Auslastung. Die gleiche Analyse zeigt, dass sich der Besitz eines 8-GPU-Systems bereits bei etwa vier Stunden Nutzung pro Tag als kostengünstiger erweist als die Miete eines solchen Systems. Die ehrliche Version des Arguments besagt nicht, dass die KI-Eigentümschaft immer gewinnt, sondern dass er bei durchgängigen Workloads eindeutig die Oberhand behält.
KI-Eigentum in der Praxis
In der Praxis bedeutet Eigentum, dass man die Wertschöpfungskette der Komponenten, von denen ein KI-System abhängt, besitzt oder maßgeblich kontrolliert: Rechenzentren, Chips und die Modellschicht, anstatt einem anderen Unternehmen für den Zugriff auf diese Komponenten über eine API zu bezahlen.
Ein Unternehmen kann seine Modelle besitzen, die Hardware aber mieten, Open Weights in einem Colocation-Rechenzentrum betreiben oder alle drei Komponenten als einen einzigen, nutzungsbasiert abgerechneten Service beziehen. Am äußersten Ende der Abhängigkeit steht die strategisch wichtigste Fähigkeit, auf die ein Unternehmen heute setzen kann: ein externes Modell auf fremden Chips in einem fremden Rechenzentrum, abgerechnet pro Token.
Und während Regierungen die KI-Regulierung und Exportkontrollen verschärfen, wird diese Abhängigkeit sowohl zu einem strategischen als auch finanziellen Risiko. Eine Fähigkeit, die von einem anderen Unternehmen oder Land neu bewertet, gedrosselt, veraltet oder eingeschränkt werden kann, ist letztlich nur gemietet – egal, wie viel dafür ausgegeben wird.
Die Kontrolle über die Modellbereitstellung gewährleistet Datensicherheit, schützt Prompts und feinabgestimmte Weights und ermöglicht vorhersehbare, amortisierte Kosten anstelle variabler, nutzungsbasierter Ausgaben. Eine KI-Strategie, die auf eigener Infrastruktur, effizienten Modellen und transparenter Kostenzuordnung basiert, wird für den Vorstand planbar und verteidigungsfähig, anstatt ein Kostenfaktor, der jedes Quartal neu bewältigt werden muss. Die Cloud bleibt unschlagbar in ihrem Kerngebiet: Trainingsspitzen, Experimente und unvorhersehbare Nachfrage. Doch die arbeitsintensive Inferenz, die langfristig die Kosten treibt, gehört zunehmend ins eigene Haus.
Um Ihre Gesamtkosten für KI zu ermitteln und Möglichkeiten zur Senkung zu besprechen, kontaktieren Sie noch heute unseren Cohere-Vertrieb.