
Compass est la plateforme de recherche de Cohere pour les développeuses et développeurs qui créent des applications d’IA à partir des données de leur entreprise. Elle met en avant les informations les plus pertinentes du corpus de votre entreprise pour les utiliser dans la génération augmentée par recherche (RAG), la recherche et les workflows d’agents. Compass entre maintenant en bêta privée en tant qu’offre gérée – Compass Cloud.
Compass a été conçu pour les développeuses et développeurs. Il fournit la base de récupération que les développeuses et développeurs peuvent configurer librement en fonction de leurs besoins en matière de données et de flux de travail. Au lieu d’assembler et d’exploiter eux-mêmes la pile, les équipes accèdent à Compass via ses API, son serveur MCP ou son Python SDK pour façonner l’expérience utilisateur finale souhaitée.
Jusqu’à présent, Compass a principalement alimenté la récupération de données pour North, l’espace de travail pour agents d’entreprise de Cohere, y compris ses bibliothèques de documents et son écosystème MCP. Nous avons également intégré Compass dans des environnements auto-hébergés hautement sécurisés pour des partenaires d’industries réglementées dont les charges de travail ne peuvent pas être externalisées vers le SaaS.
La demande des clients pour une option gérée a été claire et constante : les équipes veulent les capacités de recherche de Compass, parmi les meilleures du marché, mais beaucoup ne veulent pas la surcharge opérationnelle liée à l’auto-hébergement.
Nous avons entendu ces demandes. Compass Cloud élargit Compass à un marché plus large. Il permet à Cohere de gérer l’ensemble du pipeline et l’inférence du modèle, afin que nos clients puissent se concentrer encore plus sur le développement. Parallèlement, les déploiements auto-hébergés restent disponibles pour les projets soumis à des contraintes de confidentialité.
Nous collaborons avec un nombre limité d’équipes d’entreprise en tant que partenaires bêta. Intéressé(e) ? Demandez l’accès.
Compass résout des problèmes non résolus dans la recherche d'entreprise
La recherche et la récupération se sont améliorées, mais la performance des entreprises n’est plus définie par la pertinence et la latence pour une seule requête. Alors que la récupération devient une infrastructure clé pour l’IA générative et les agents, trois évolutions changent les exigences :
- Économie des jetons : Chaque résultat non pertinent transmis à un modèle consomme des jetons et occupe un espace de contexte limité. Une récupération plus précise crée des entrées plus petites et de meilleure qualité, réduisant les coûts d'inférence et le temps nécessaire pour accomplir une tâche. La récupération est l'un des leviers de coût les plus efficaces disponibles pour les entreprises aujourd'hui.
- Modèles d’accès agentiques : Les agents peuvent émettre des dizaines de requêtes pour accomplir une seule tâche, reformuler des demandes et parcourir plusieurs sources. Dans ces boucles à sauts multiples, la latence s’accumule, la pertinence peut dériver et les autorisations doivent être appliquées à chaque étape. La récupération doit donc fonctionner de manière fiable sur des séquences de requêtes générées par machine, et non uniquement sur des recherches en une seule fois.
- Un système de recherche fragmenté : Les pipelines de production combinent souvent des systèmes distincts pour l’ingestion, l’indexation, le reclassement, le contrôle d’accès et l’orchestration. Différents middlewares et sources de vérité obligent les équipes à consacrer beaucoup d’efforts à l’intégration plutôt qu’à la qualité de la recherche.
Compass a été conçu pour répondre à chacun de ces besoins : 1) en fournissant un contexte pertinent et contrôlé pour les charges de travail génératives ; 2) en prenant en charge les applications de recherche conventionnelles et agentiques ; et 3) en consolidant le stack de récupération de base dans une plateforme d'entreprise intégrée.
Recherche et récupération full-stack
Compass regroupe le traitement et la récupération de documents en un seul service configurable. Les équipes peuvent accéder à une interface unique au lieu d’intégrer et d’exploiter des services distincts.
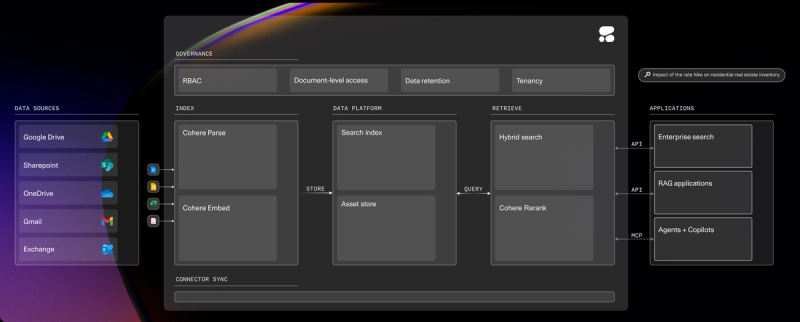
Communauté : Accédez à des connecteurs prêts à l’emploi pour vos espaces de partage de fichiers et de stockage dans le cloud, tels que SharePoint, OneDrive et Google Drive. Accédez rapidement au contenu dont vous avez besoin grâce à la compatibilité quasi universelle des données de Compass — multilingue, multimodale et indépendante du format de fichier.
Analyse :Transformez des documents complexes en données structurées et interrogeables. Compass transforme les fichiers d’entreprise multimodaux en contenu prêt pour l’IA, en appliquant la bonne stratégie d’analyse à chaque document et en n’utilisant le traitement par vision que lorsque cela apporte de la valeur, ce qui réduit l’utilisation inutile des modèles.
Embed : Capturez le sens et la terminologie exacte. Compass génère des représentations denses et éparses, afin que la recherche puisse correspondre à la fois à l’intention sémantique et au langage spécifique au domaine dans le texte et le contenu multimodal.
Index :Conservez vos fichiers sources, votre contenu analysé et vos embeddings sous forme d’enregistrements distincts, afin de pouvoir adopter un nouveau modèle d’embedding sans avoir à explorer et télécharger à nouveau le même contenu. Au moment de la recherche, ils se trouvent dans un même index avec leurs métadonnées, ce qui réduit la nécessité de synchroniser chaque système.
Récupération : Combinez des stratégies de recherche en une seule requête. La recherche sémantique, la recherche par mots-clés et la recherche par vecteurs peuvent fonctionner de manière indépendante ou ensemble, en équilibrant exhaustivité et précision. Les autorisations sont appliquées lors de la récupération et non laissées à l'application.
Rerank: Envoyez des preuves plus solides au modèle. Le reranker de Cohere, parmi les meilleurs de sa catégorie, identifie les passages les plus pertinents d’un vaste ensemble de candidats, réduisant ainsi le contexte non pertinent et les jetons nécessaires à la génération.
Gouvernance : Appliquez un contrôle d'accès multi-locataire et des autorisations au niveau des documents lors de la récupération, afin que les applications n'aient pas à filtrer elles-mêmes les résultats. Dans Compass, les politiques de conservation font expirer automatiquement le contenu et empêchent les documents supprimés d'être resynchronisés.
Précision de recherche optimale
L’objectif principal de Compass est simple : améliorer la pertinence des informations mises en avant pour les applications de gestion des connaissances d’entreprise, qu’il s’agisse d’un pipeline RAG ou d’un agent autonome. Cette qualité repose sur les modèles de recherche et de traitement de documents de Cohere, parmi les meilleurs de la catégorie, ainsi que sur la recherche hybride de Compass : récupération lexicale, éparse et dense, puis reclassement.
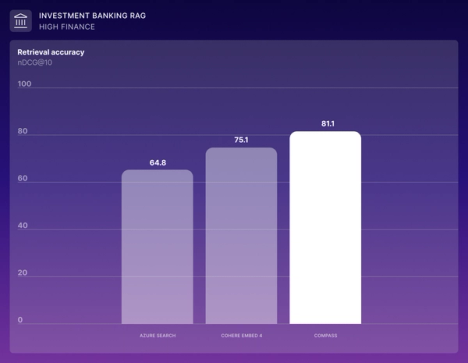
Le graphique ci-dessous illustre un exemple de gain de précision par rapport à une infrastructure de recherche traditionnelle ou autonome sur une charge de travail RAG représentative dans le secteur financier : intégrer une requête, récupérer des supports de présentation à partir d’un index et noter les résultats les plus pertinents. Sur High Finance, un benchmark de banque d’investissement créé par Cohere, Compass a obtenu une amélioration de 14 à 16 points par rapport à Azure Search (passant de 64,8 à 81,1). Un écart de cette ampleur peut faire la différence entre une réponse insatisfaisante et une excellente réponse pour l’utilisateur final.
Concevez selon vos conditions
Les utilisateurs peuvent améliorer leurs performances de recherche avec Compass Cloud de deux manières clés, selon la façon dont ils souhaitent intégrer la récupération dans leur application :
- API Compass : Idéale pour les équipes qui développent des applications RAG et de recherche personnalisées. Utilisez les API Compass pour vous intégrer directement aux modèles et aux composants de recherche qui alimentent Compass, ce qui donne aux développeuses et développeurs plus de contrôle sur la façon dont le contenu est représenté, recherché, classé et intégré dans leur application.
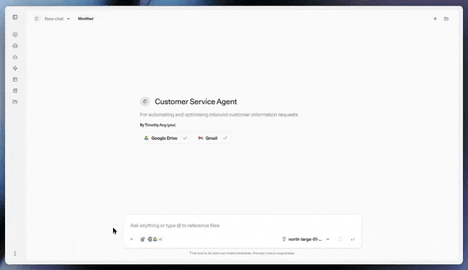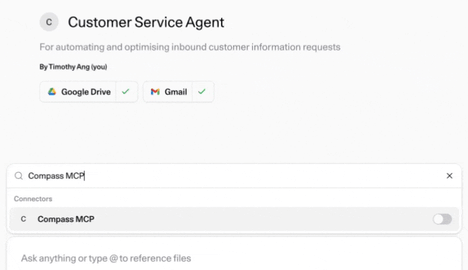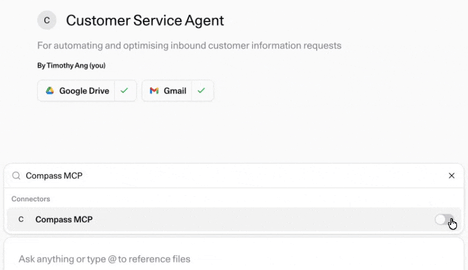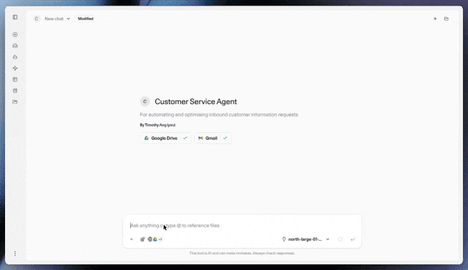
- Model Context Protocol (MCP) : Idéal pour la récupération agentique. Compass est livré avec un serveur MCP dédié et versionné de manière indépendante qui expose la récupération sous forme d’outils réutilisables via une norme ouverte. Les clients compatibles avec le MCP peuvent découvrir et appeler directement ces outils, ce qui rend Compass portable sur les frameworks d’agents sans intégration personnalisée pour chacun d’eux.
La récupération agentique est une approche émergente à l'intersection des grands modèles linguistiques et de la récupération d'informations. Plutôt que de s'appuyer sur une seule étape de récupération de requête et de réponse, un agent peut décider quoi chercher, rechercher des informations pertinentes, évaluer les résultats et affiner sa recherche avant de répondre.
Cela est particulièrement utile pour les tâches qui ne peuvent pas être résolues avec une seule recherche. Grâce au serveur MCP Compass, les agents peuvent progressivement affiner le corpus de récupération, réduisant ainsi le contexte inutile et rendant les tâches de récupération complexes plus rapides et plus efficaces en termes de jetons.
Accès anticipé
Nous ouvrons cette version bêta privée aux équipes qui développent des applications axées sur la recherche et l’autonomie.
Les participants à la version bêta bénéficient d’un accompagnement personnalisé de l’équipe technique, d’un accès anticipé au déploiement dans le cloud et d’une influence directe sur la feuille de route. Demander l’accès.
Nous organisons également une session en direct le 8 octobre sur X avec les responsables de l'ingénierie et des produits de Cohere pour discuter de l'avenir de la recherche d'entreprise.