









Wichtige Mitwirkende: Manoj Govindassamy, Maxime Brunet, Jeremy Pekmez, Inna Shteinbuk, Elliott Choi
Cohere führt Model Vault ein – eine dedizierte, vollständig isolierte SaaS-Plattform, die es Kunden ermöglicht, Cohere-Modelle sicher, skalierbar und mit garantierter Performance auszuführen.
Model Vault vereint den reduzierten operativen Aufwand einer vollständig gemanagten SaaS-Lösung mit den Sicherheits- und Performance-Vorteilen des Self-Hosting. North-Nutzer betreiben ihre Anwendung innerhalb eines sicheren VPC und übertragen die wartungsintensive Modell-Inferenz sowie die Skalierung an ihr sicheres, cloudbasiertes Model Vault. Das Ergebnis: geringere Gesamtkosten und eine schnellere Einführung im Enterprise-Umfeld.
Model Vault markiert einen Meilenstein auf Cohere’s Weg, transformative KI zu liefern, die die realen Herausforderungen löst, denen Enterprise-Kunden heute gegenüberstehen. Lesen Sie weiter, um mehr über das Angebot zu erfahren, oder legen Sie jetzt los.
Der Kompromiss zwischen Komfort und Kontrolle
Im Kern der Enterprise-KI-Transformation steht eine fundamentale Herausforderung: Wie lässt sich die Geschwindigkeit und Skalierbarkeit der Einführung mit den Anforderungen an Infrastrukturkontrolle und Compliance einer etablierten, modernen Organisation in Einklang bringen?
Dies ist zunehmend ein Problem der Modell-Inferenz. Da Unternehmen Modelle in immer mehr Workflows, Teams und Produkte integrieren, löst die Inferenz schrittweise das Training als dominierende KI-Arbeitslast ab. McKinsey prognostiziert mittlerweile, dass die Inferenz bis zum Ende des Jahrzehnts den Großteil der KI-Rechenleistung ausmachen wird, selbst wenn die Kosten pro Einheit weiter sinken. Für Unternehmen verschiebt sich dadurch der Fokus von der Finanzierung punktueller Trainingsläufe hin zur Berücksichtigung der Inferenz – einer wiederkehrenden Kostenstelle, die direkt mit der steigenden Nutzung skaliert.
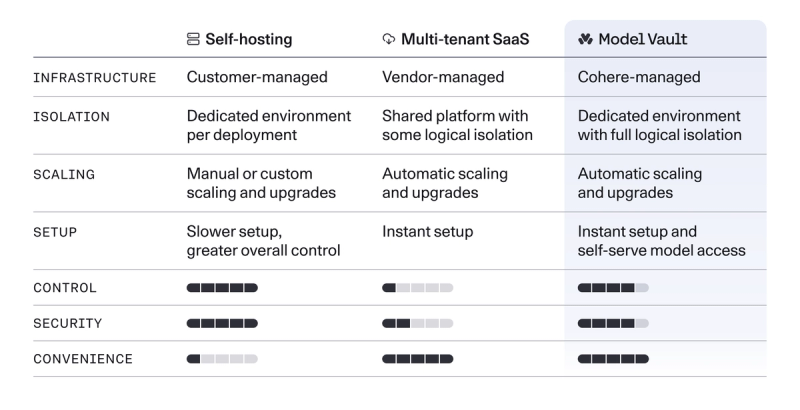
Für die meisten Unternehmen spiegeln die verfügbaren Bereitstellungsoptionen diese Spannung deutlich wider. Multi-Tenant-SaaS-Plattformen optimieren Geschwindigkeit und operative Einfachheit, indem sie Infrastrukturkosten auf mehrere Kunden verteilen. Allerdings führt der in Shared-Umgebungen inhärente Mangel an Workload-Isolierung zu Problemen wie „Noisy-Neighbor“-Effekten, erzwungenen Rate-Limits bei Spitzenlasten und unvorhersehbarer Latenz. Diese Plattformen schränken zudem oft die Konfigurierbarkeit der Modelle ein, bieten wenig Einblick in die Performance auf Workload-Ebene und genügen häufig nicht den Compliance-Standards hochregulierter Unternehmen.
Self-Hosted-Bereitstellungen – sei es On-Premises oder innerhalb eines kundenseitig verwalteten VPC – beheben viele dieser Einschränkungen, indem sie eine größere Kontrolle über Infrastruktur, Performance-Charakteristika und Sicherheitsgrenzen bieten. Die damit verbundene Kapital- und Betriebslast kann jedoch prohibitiv teuer sein, insbesondere für Teams, die eine Skalierung anstreben.
Mit North, Cohere’s Enterprise-Plattform zum Aufbau agentischer KI-Anwendungen, wird dieses Infrastrukturproblem noch dringlicher. Die Bereitstellung von Modellen erfordert weiterhin die Provisionierung und Verwaltung von Hardware, doch agentische Workloads sind per Design sprunghaft, vielschichtig und unvorhersehbar.
Ein neuer Rahmen für die skalierbare und sichere Bereitstellung von KI
Model Vault ist die neueste Ergänzung des Portfolios sicherer Bereitstellungsoptionen von Cohere. Die Lösung wurde entwickelt, um den Zielkonflikt zwischen Benutzerfreundlichkeit und Kontrolle zu lösen, indem die operativen Aufwände für die Modell-Inferenz in eine sichere, von Cohere verwaltete Cloud-Umgebung verlagert werden.
Das Ergebnis ist ein SaaS-Bereitstellungsmodell, das die Einschränkungen einer gemeinsam genutzten Infrastruktur – wie Ressourcenkonflikte und unvorhersehbare Performance – eliminiert und gleichzeitig die Geschwindigkeit, Elastizität und Benutzerfreundlichkeit beibehält, die für Multi-Tenant-SaaS-Lösungen typisch sind.
Um es klar zu sagen: Es gibt keinen universellen Bereitstellungsansatz, der für jede Organisation geeignet ist. Für einige Unternehmen bleiben Multi-Tenant-SaaS- oder selbstgehostete Bereitstellungen die richtige Wahl – abhängig von den internen Kompetenzen, der Datenstrategie und den regulatorischen Anforderungen. Branchen mit stark standardisierten Workflows können beispielsweise ihre Compliance-Anforderungen allein durch Zugriffskontrollen auf Anwendungsebene erfüllen und bevorzugen weiterhin gemeinsame SaaS-Plattformen.
Doch für viele Unternehmen ist das Infrastrukturmanagement zu einer wachsenden Hürde für den produktiven Einsatz von Agentic AI geworden. Sie möchten die Kapazitäten für die Modell-Inferenz skalieren, ohne den operativen Aufwand zu erhöhen. Model Vault wurde speziell für diese Teams entwickelt.
Entkopplung der Inferenz von der Entwicklung
Model Vault ist eine von Cohere verwaltete Lösung. Das bedeutet, dass wir die gesamte operative Verantwortung für die produktive Inferenz übernehmen: die Bereitstellung von Modellen, das Management von Upgrades und Abhängigkeiten, die Bereitstellung und Skalierung von Kapazitäten sowie die Gewährleistung von Performance und Verfügbarkeit. Wir bieten Model-Vault-Nutzern eine garantierte Verfügbarkeit von über 99,9 %, gestützt durch produktionsreife SLOs und Latenzwerte, die mit führenden Managed-AI/ML-Bereitstellungsplattformen mithalten oder diese übertreffen.
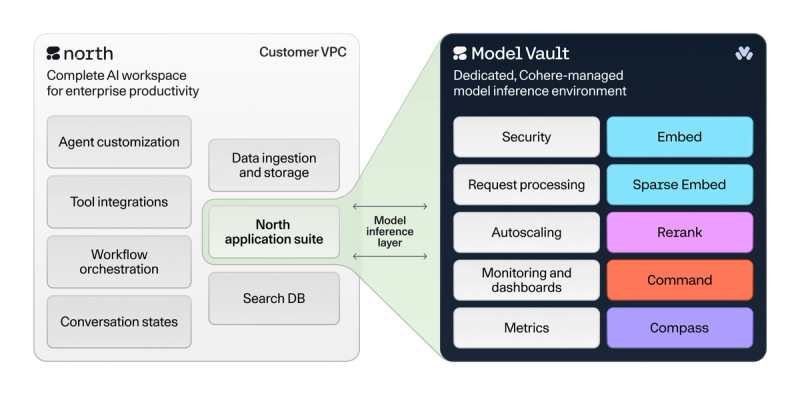
Dies senkt die Gesamtkosten (TCO) erheblich, da Kunden keine GPU-gestützte Inferenz-Infrastruktur mehr beschaffen, bereitstellen und betreiben müssen. North-Bereitstellungen können nun vollständig in CPU-only-Umgebungen laufen, während die rechenintensivsten ML-Infrastrukturaufgaben in Ihrem Model Vault ausgeführt werden.
Model Vault ermöglicht ML-Teams eine elastische Skalierung der Workloads, ohne dass Kapazitäten im Voraus zugewiesen werden müssen oder das Risiko ungenutzter GPUs besteht. Die Inferenzkapazität passt sich dynamisch der Nachfrage an und eliminiert so den Zielkonflikt zwischen Überdimensionierung für maximale Performance und Unterdimensionierung die Latenz und Verfügbarkeit beeinträchtigt.
Einfach gesagt: Model Vault übernimmt die operative Komplexität des Modell-Hostings, sodass Ihr wertvollstes Asset – Ihre Ingenieure – den Fokus darauf legen kann, Agentic-AI-Anwendungen von der Experimentierphase in den produktiven Einsatz zu überführen. Die Inferenz ist nicht Ihr Alleinstellungsmerkmal.
Dabei bleibt die unternehmerische Kontrolle dort erhalten, wo sie am wichtigsten ist. North-Kunden behalten die volle Hoheit über die Control Plane, einschließlich Agent-Logik, Workflow-Orchestrierung, Conversation-States, Datenspeicherung und Pipelines. Sie verfügen über volle architektonische Flexibilität bei der Entscheidung, welche Daten und Workloads sie On-Premise oder in ihren bestehenden VPCs hosten und welche durch Model Vault verwaltet werden.
Keine gemeinsame Nutzung. Keine Limits. Keine Überraschungen.
Model Vault wird als logisch isolierte virtuelle Private Cloud bereitgestellt. Es werden keine Infrastrukturkomponenten zwischen Kunden geteilt, was eine hohe Isolation für Performance, Zuverlässigkeit und Sicherheit gewährleistet. Dazu gehören dedizierte Network Load Balancer, Reverse-Proxys, Serving-Middleware, Inferenzserver sowie die zugrunde liegenden GPU-Beschleuniger.
Teams können Model Vault nun nutzen, um unbegrenzte Produktions-Workloads auszuführen, ohne um knappe Kapazitäten konkurrieren zu müssen. Die bereitgestellten Ressourcen sind exklusiv für Sie reserviert – es gibt keine Rate-Limits mehr zur Aufrechterhaltung der Plattformstabilität. Gleichzeitig skaliert Model Vault die Inferenzkapazität dynamisch gemäß anpassbarer Logik, sodass die Performance auch bei sprunghaft ansteigenden agentenbasierten Inferenzanfragen stabil bleibt.
In Echtzeit überwachen und optimieren
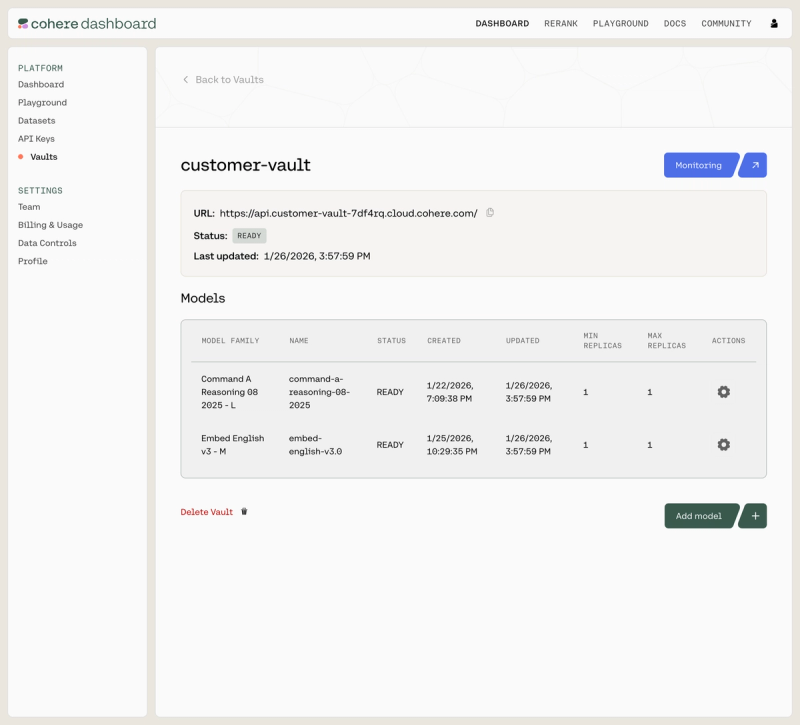
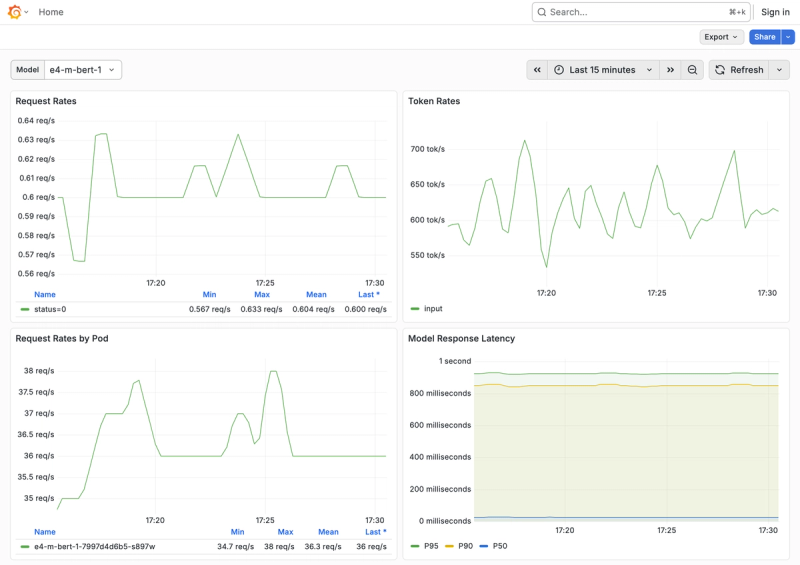
Model Vault bietet MLOps-Teams einzigartige Einblicke in das Verhalten von Inferenz-Workloads in der Produktion. Über ein dediziertes Echtzeit-Dashboard können Teams Request-Muster, Latenz, Token-Durchsatz und Ressourcenauslastung verfolgen, um Engpässe schnell zu identifizieren und die Effizienz, Vorhersehbarkeit sowie Performance kontinuierlich an steigende Anforderungen anzupassen.
Erste Schritte
Model Vault ist für eine schnelle und intuitive Inbetriebnahme mit minimalem manuellen Aufwand konzipiert. Es kann in Ihre bestehende North-Bereitstellung integriert werden oder als private Inferenzplattform für einzeln genutzte Cohere-Modelle dienen.
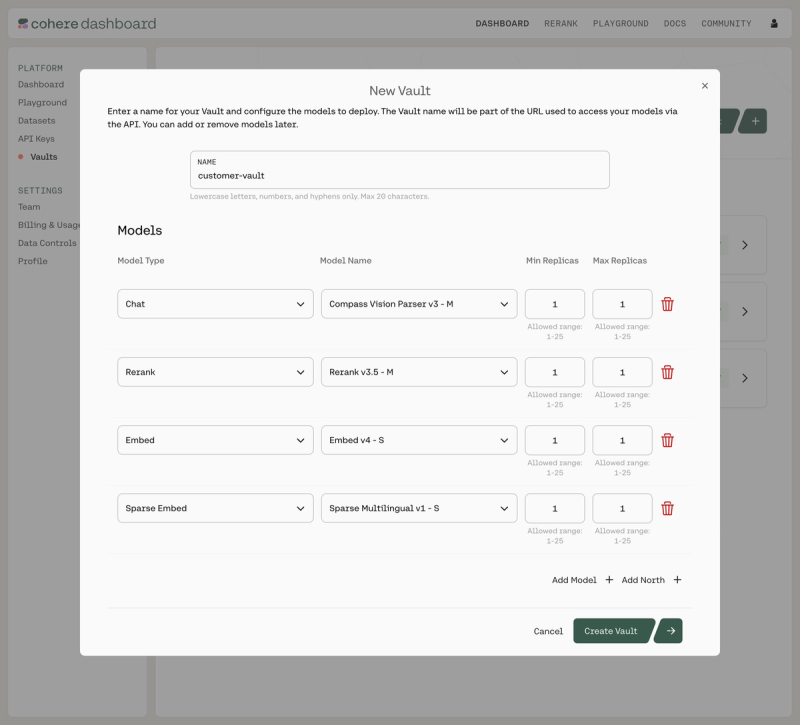
So erstellen Sie Ihren Model Vault in wenigen Minuten:
Ohne North:
- Rufen Sie dashboard.cohere.com auf. Erstellen Sie ein Konto und melden Sie sich an.
- Suchen Sie in der Seitenleiste nach „Vaults“ und wählen Sie dann „+ Neuer Vault“ aus.
- Vergeben Sie einen Namen für Ihren Vault.
- Wählen Sie Ihr Cohere-Modell sowie die Performance-Stufe aus.
- Legen Sie den gewünschten Bereich an Replikaten für jedes ausgewählte Modell fest. Dies definiert Ihre Skalierungsgrenzen.
- Bestätigen Sie die Erstellung Ihres Vaults.
Das war's! Ihre Infrastruktur ist bereitgestellt, und Sie erhalten sofort Ihre einzigartige Subdomain, den API-Endpunkt sowie Zugriff auf Ihr privates Monitoring-Dashboard.
Mit North:
- Befolgen Sie die oben genannten Schritte, um einen dedizierten Model Vault für Ihr Unternehmen einzurichten.
- Stellen Sie sicher, dass Sie die Modelle auswählen, die Sie für Ihre North-Bereitstellung benötigen.
- Sobald Sie Ihren API-Endpunkt haben, aktualisieren Sie das Helm-Chart in Ihrer North-Bereitstellung, sodass die gewünschten Modelle auf diesen Endpunkt verweisen.
- Nach der Einrichtung können Kunden die primären und sekundären Inferenz-Endpunkte für Command-Modelle in North direkt über die Admin-Oberfläche verwalten.
- Ihre North-Bereitstellung ist nun mit Model Vault konfiguriert.
Unterstützte Modelle
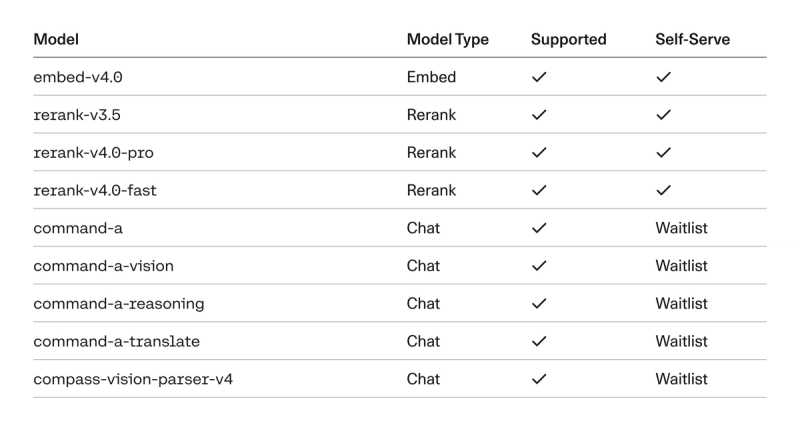
Model Vault unterstützt derzeit alle neuesten State-of-the-Art-Modelle von Cohere für Embeddings, Reranking und generative KI. Dazu gehören auch gebündelte Angebote für unsere North-Kunden (siehe Tabelle unten).
Darüber hinaus können Rerank- und Embed-Modelle, die die State-of-the-Art-Funktionen von Cohere für KI-gestützte Suche und Informationsabfrage ermöglichen, auch selbstständig über Ihren Model Vault genutzt werden. Das bedeutet einen bedarfsgerechten Zugriff für eine nahtlose Einrichtung und schnellere Experimente. Kunden, die einen selbstständigen Zugriff auf unsere Command-Modelle oder integrierte Modell-Bundles wünschen, können sich für die Warteliste anmelden.
Die Preispläne für Model Vault sind flexibel und können an die Arbeitslastanforderungen und Budgetvorstellungen Ihres Teams angepasst werden. Sprechen Sie mit einem unserer Experten, um die beste Lösung für Ihre Bedürfnisse zu finden.
Sie können zudem unsere Dokumentation mit detaillierten Schritt-für-Schritt-Anleitungen lesen sowie unsere Modellspezifikationen und Anleitungen zur Entwicklung agentischer KI-Anwendungen in North konsultieren.
Schnell entwickeln. Die Kontrolle behalten.
Beginnen Sie noch heute damit, sichere und leistungsstarke Unternehmens-KI mit Model Vault bereitzustellen. Jetzt starten.


