









本日、エンタープライズ向けの推論タスクに特化した当社最先端モデル「Command A Reasoning」を発表します。エージェント型ワークフローからエンドツーエンドのシステムまで、gpt-oss-120b、DeepSeek-R1 0528、Mistral Magistral Mediumを含む、同クラスの主要なプライベートデプロイ可能モデルを上回る性能を誇ります。
Command A Reasoningはエンタープライズのニーズに合わせて設計されており、極めて安全で効率的、かつスケーラブルなデプロイオプションを提供します。リソース消費を抑えたデプロイでは、単一のH100またはA100で動作し、コンテキスト長を128kまでサポートします。2つ以上のGPUを使用した低レイテンシ最適化デプロイでは、コンテキスト長が256kまで拡張可能です。この柔軟な構成により、組織は保有するハードウェアを最大限に活用できます。長いコンテキスト長を備えているため、ドキュメント中心のワークフローや複雑なマルチステップのエージェント型ユースケースに最適です。
ユーザーはトークン予算を設定することで、コンピューティングリソースの使用量を直接管理し、コストを制御できます。Command A Reasoningは、最高精度が求められるタスクに使用できるほか、効率性が最優先の場合は速度とスループットを重視した設定も可能であるため、推論専用モデルと非推論モデルを個別に維持する必要がなくなります。
Command A Reasoningは、安全なエージェント型AIプラットフォームであるNorthの基盤となるコア生成モデルです。これにより、組織は当社最強の推論モデルをバックエンドとして活用し、カスタムAIエージェントや自動化機能をオンプレミスで展開することが可能になります。
エンタープライズ推論タスクにおける優れたパフォーマンス
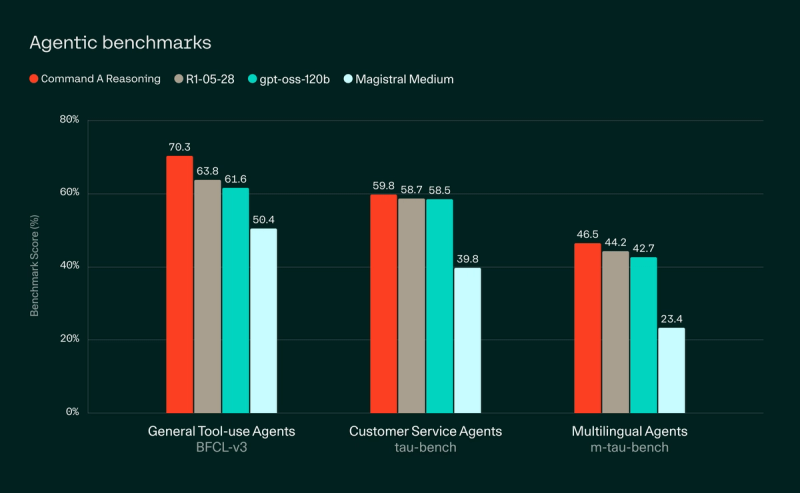
エージェント型および多言語推論ベンチマーク
Command A Reasoningは、主要なエージェント型ベンチマークにおいてトップクラスの結果を実現します。また、多様な主要ビジネス言語においても高い性能を発揮し、グローバル企業が一貫した品質のエージェントを活用することを可能にします。
卓越したディープリサーチエージェント
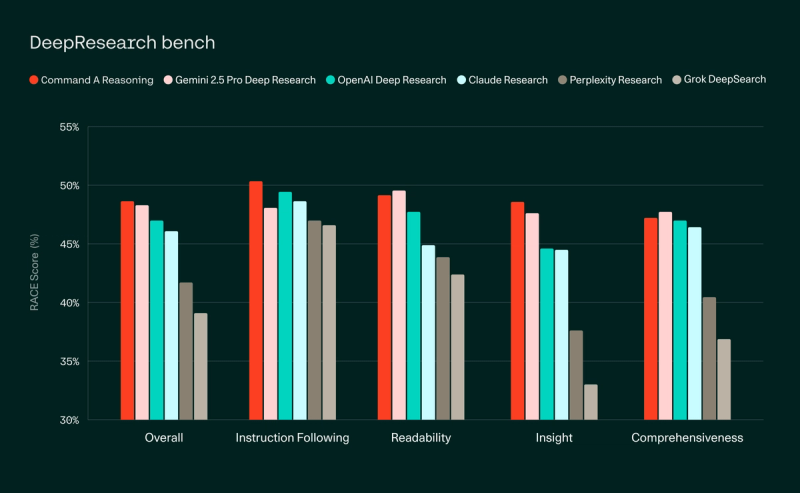
Command A Reasoningは、連鎖的または階層的なエージェントを組み込んだエンドツーエンドシステムを駆動し、タスク遂行に最適なツールを活用することに長けています。その好例がDeep Researchシステムであり、他の主要なAIラボの同等の機能を上回る性能を実現しています。
Deep Research は、単なるクイック検索では不十分な、複雑で深い洞察を必要とする問いに取り組むために設計されました。通常、従業員に数時間を要する詳細な根拠付きレポートを、わずか数分で作成します。当社のシステムは、Command A Reasoning を搭載したマルチエージェントアーキテクチャを採用しており、ユーザーのリクエストをより小さなリサーチトピックに分解します。その後、複数の AI エージェントが並行して動作し、多種多様なソースから情報を検索・分析します。最後に、システムが検証済みの知見を統合し、元のユーザーリクエストに直接答える、構造化された単一のレポートにまとめます。Deep Research は近日、North で利用可能になります。Northにて提供予定です。
Cohere のフラッグシップ・エンタープライズ AI プラットフォーム「North」の基盤技術
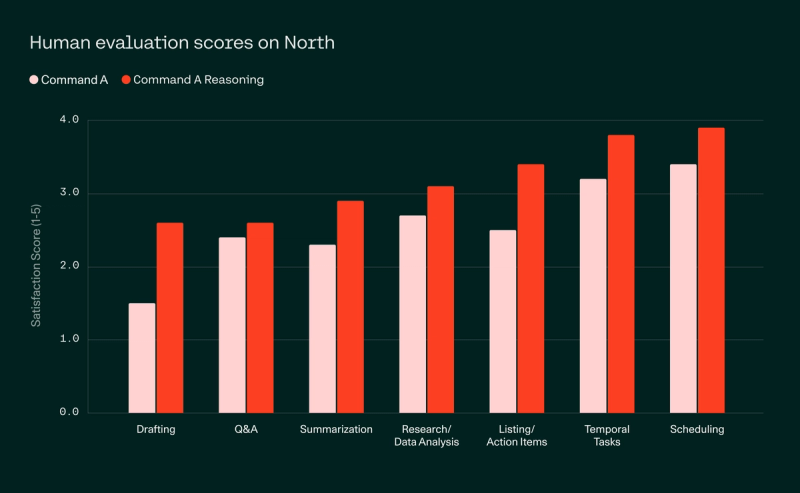
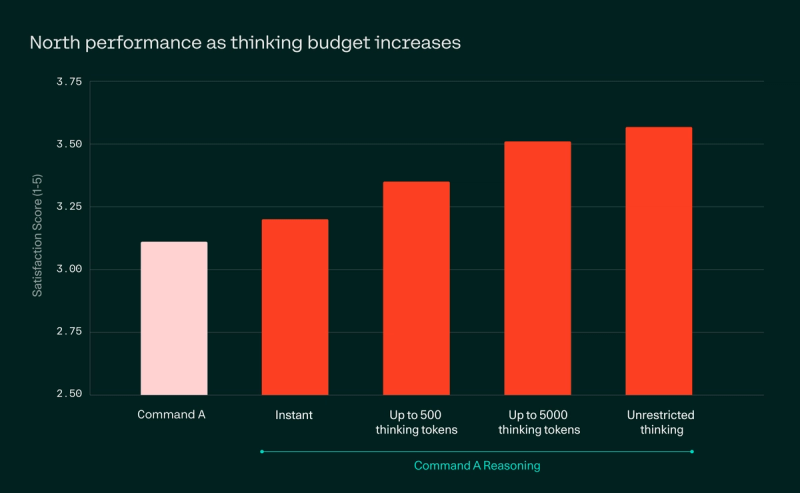
North により、データセキュリティを重視する企業は、自社インフラ内で大規模に AI エージェントと自動化機能を導入することが可能になります。業務上の代表的なタスクセットに対する人間による評価スコアにおいて、Command A Reasoning は一貫して Command A を上回っています。顧客にとって、これらの向上は、より信頼性の高いエージェントの実現、手動介入の削減、そして極めて正確で実用的な結果の提供を意味します。
エンタープライズ規模で求められる制御力と効率性
Command A Reasoning は、優れたパフォーマンス、高精度、そして拡張可能な効率性を兼ね備え、あらゆる業界におけるビジネスアプリケーションの可能性を広げます。ハードウェア要件が低いため、1 台の H100 または A100 によるプライベートデプロイメントでも実用的に運用可能です。
このモデルは、ユーザーが制御可能なトークン予算を通じて計算リソースの使用量とコストを最適化し、極めて重要な精度が求められるタスクと高スループットタスクの間でシームレスに調整を可能にします。これにより、推論用モデルと非推論用モデルを個別に用意する必要がなくなり、企業は GPU 効率を最大化し、リソースを動的に割り当てることができます。
North の内部評価では、推論予算を調整することで、推論を行わない効率的なレスポンスから、より高度な推論レベルによる詳細なレスポンスまで、パフォーマンスがスムーズに向上することが示されています。推論を無効にした状態であっても、Command A Reasoning は Command A を上回るパフォーマンスを発揮します。
ミッションクリティカルな環境でも安心の安全性
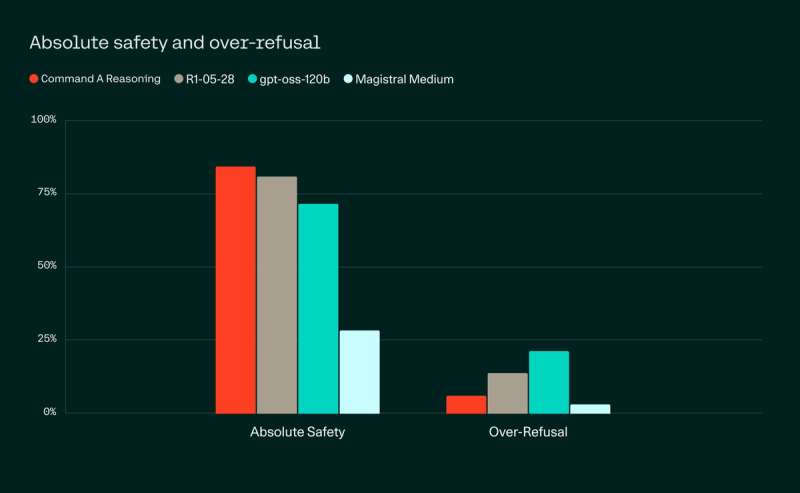
安全性は、Command A Reasoningを含むすべてのモデルのトレーニングと評価における基盤です。これは、モデルが正当なリクエストを過剰に拒否しないようにしつつ、オンライン上での有害かつ悪意のあるコンテンツの意図的な拡散を防ぐという、最適なバランスを実現することを意味します。私たちは、児童性的搾取および虐待(CSEA)、自傷行為、暴力とヘイト、性的コンテンツ、そして陰謀論という5つの主要領域に重点を置いています。
提供状況
Command A Reasoningは、本日より Cohereプラットフォームで利用可能であり、研究目的であれば Hugging Faceでも利用可能です。プライベートデプロイメントやオンプレミス導入にご興味がある場合は、カスタム価格について当社の 営業チームまでお問い合わせください。
「Cohereと提携し、彼らのCommand A ReasoningモデルをSAP Business Technology Platformの生成AIハブに統合できることを嬉しく思います。この強力なモデルは、SAPの生成AI機能を強化し、顧客、パートナー、開発者がそれぞれの独自の環境に合わせた革新的で安全なエージェントアプリケーションを構築できるようにします。共に、エンタープライズ向け推論タスクにおける新たな可能性を切り拓いていきます」 — SAP SE AI担当シニアバイスプレジデント兼グローバル責任者、ウォルター・サン博士
[1]すべてのモデルを、利用可能な中で最も高度な推論設定で実行しています。
BFCL では、Function Calling (FC) 設定を用いて Command-R-Reasoning を評価しています。競合他社については、公式 BFCL リーダーボードにスコアが掲載されている場合はそれを記載し、そうでない場合は公式 BFCL コードベースを使用してベンチマークを実施し、プロンプト評価および FC 評価設定のうち高い方のスコアを報告しています。
Taubench では、Command-R-Reasoning について 10 回の実行における pass@1 スコアの平均値を報告しています。競合他社については、公式に報告されている数値(R1-0528、GPT-oss)を可能な限り採用し、それ以外の場合は公式 tau-bench 実装に対して tool-use API を実行し、10 回の実行における pass@1 の平均値を報告しています。いずれの場合も、航空および小売の平均値を報告しています。
M-taubench では、すべてのモデルをテストし、小売および航空の両ドメインにおいて、日本語、韓国語、アラビア語、スペイン語、フランス語、英語の全言語で 10 回の実行を行い、平均スコアを報告しています。
[2]当社の Deep Research エージェントは階層型ウェブ検索エージェントであり、問題を複数のサブ問題に分解し、個別のサブエージェントを用いて再帰的に各問題を調査します。すべてのサブエージェントが完了すると、各サブエージェントの報告書を統合し、複数の反復改善ステップを経て最終報告書を生成し、その質を担保します。当社では、内部で開発したエージェントとウェブ検索機能を使用し、検索(Retrieval)、リランキング、検索拡張生成(RAG)、およびエージェントに関する専門知識を活かしています。競合モデルのスコアについては、DeepResearchBench リーダーボードのウェブサイトで公式の RACE 評価を彼らの英語版 Deep Research レポートに対して再実行し、RACE スコアを報告しています。
[3]アノテーターには、回答の質、適切性、正しさ、および応答速度などの側面をまとめた当社独自の包括的な評価基準に基づき、満足度スコアを評価するよう依頼しました。評価セット全体は 112 の質問で構成されており、各回答について 6 人のアノテーターが評価を行い、そのスコアを集計しています。
[4]この評価では、LlamaIndex を用いて既知の正解参照回答に基づいた自動正答率スコアを算出しています。


