









本日、迅速かつ安全で高品質なAIを必要とするエンタープライズ向けに最適化された、最先端の新しい生成モデル「Command A」を発表します。GPT-4oやDeepSeek-V3といった主要なプロプライエタリモデルやオープンウェイトモデルと比較して、Command Aは最小限のハードウェアコストで最大限のパフォーマンスを発揮します。プライベートデプロイメントにおいて、Command Aはビジネスに不可欠なエージェントタスクや多言語タスクにおいて優れた性能を発揮し、他のモデルが通常32基ものGPUを必要とするのに対し、わずか2基のGPUでデプロイ可能です。
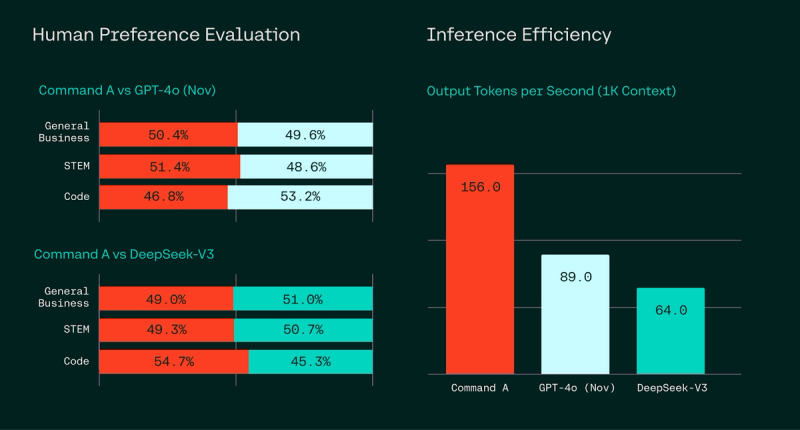
ビジネス、STEM、コーディングタスクにおける人間による直接比較評価では、Command Aはより大規模で低速な競合モデルを同等以上の性能で上回り、同時に優れたスループットと高い効率性を実現しています。人間による評価は、実際のエンタープライズデータと状況に基づいてテストを行うため、非常に重要です。
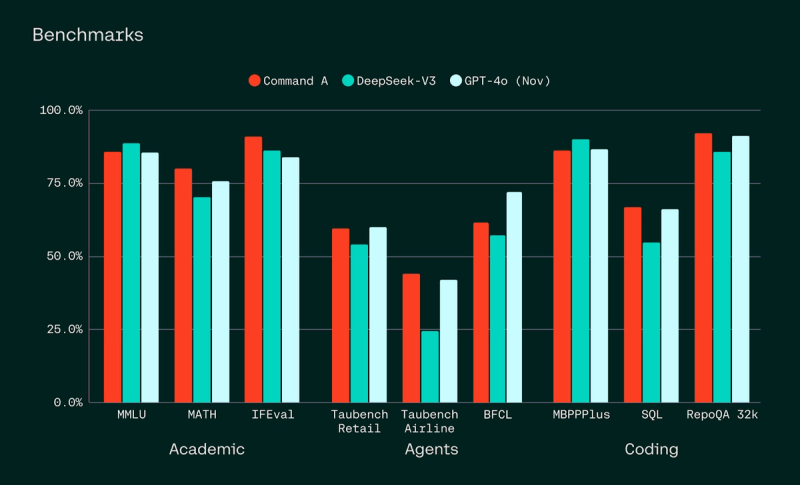
さまざまな標準ベンチマークにおいて、Command Aは指示への従順性、SQL、エージェントタスク、およびツールタスクで高い性能を発揮します。
拡張可能な効率性
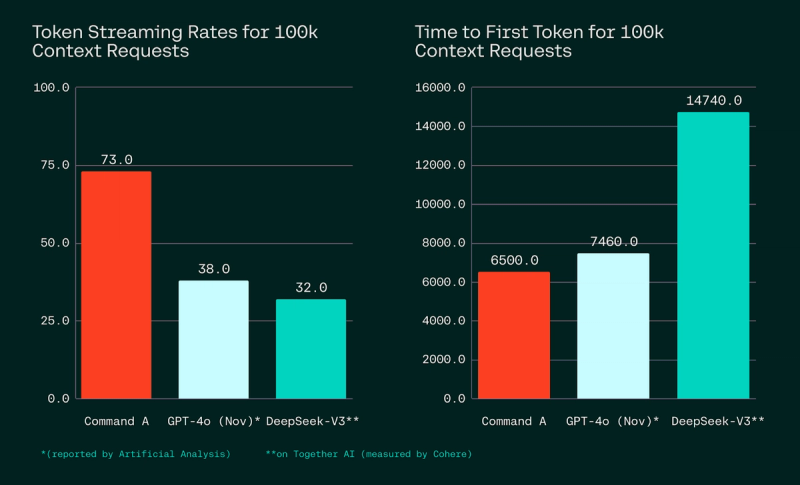
私たちは、Command Aを可能な限り効率的に構築することに注力し、同時に本番環境での運用効率も最大限に高めました。わずか2基のA100またはH100という最小限のリソースで動作するため、市場にある他の同等モデルよりもはるかに少ない計算リソースで済みます。これは特にプライベートデプロイメントにおいて重要です。
非現実的なほど巨大なモデルはレイテンシの悪化を招きます。単に正確な回答を迅速に得たい場合、Command Aが最適な選択肢です。実際、Command Aは最大156トークン/秒の速度でトークンを生成でき、これはGPT-4oの1.75倍、DeepSeek-V3の2.4倍に相当します。Command Aのプライベートデプロイメントは、APIベースのアクセスよりも最大50%コストを抑えることが可能です。
エンタープライズ対応の機能
私たちはビジネスニーズを念頭に置いてCommand Aを設計しました。256kというコンテキスト長(主要モデルの2倍)により、より長文のエンタープライズドキュメントを処理できます。その他の主要機能として、検証可能な引用を伴うCohereの高度なRAG(検索拡張生成)、エージェントによるツール利用、エンタープライズグレードのセキュリティ、そして強力な多言語性能が挙げられます。
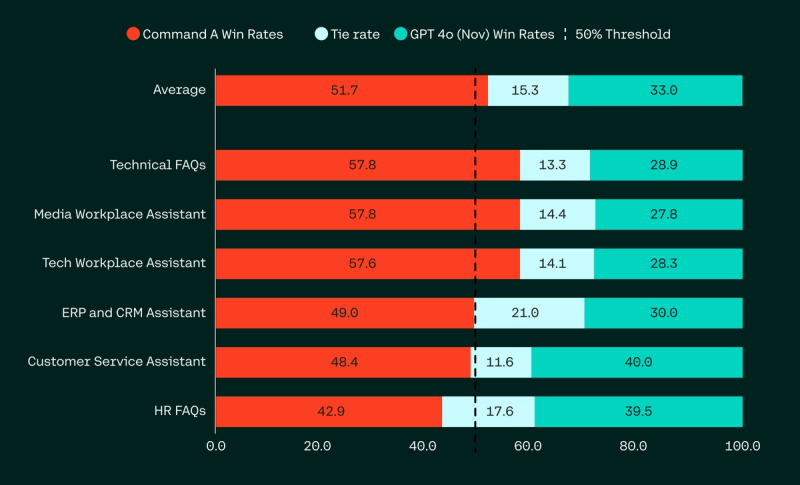
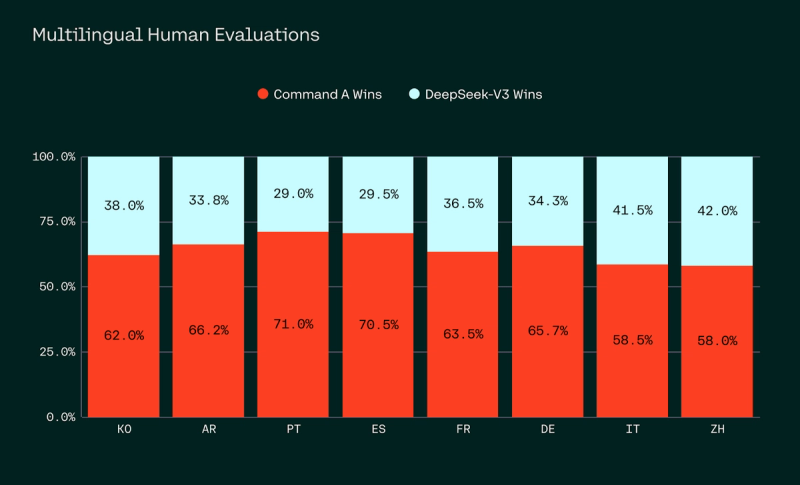
グローバル企業には、地域を越えた対応力が不可欠であることを私たちは理解しています。Command Aは、世界人口の大多数が話す23言語に対して、エンタープライズレベルのサポートを拡充しています。広範な人間による評価を実施した結果、多くのビジネスユースケースにおいて、ほとんどの言語でユーザーがDeepSeek-V3よりもCommand Aを強く好むことが分かりました。
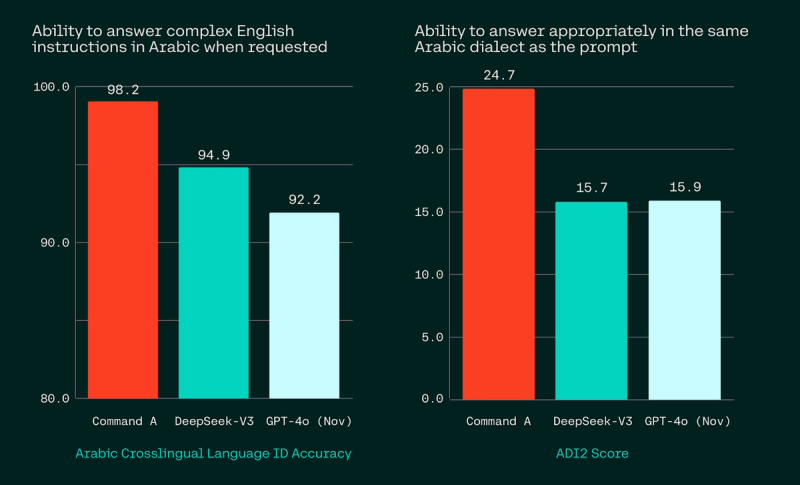
特に Command A は、指定された言語で一貫して回答を生成する能力において、GPT-4o や DeepSeek-V3 を大きく上回っており、例えばユーザーの使用しているアラビア語の方言で適切に回答することが可能です。
大規模な AI エージェントの実現
AI の性能は、入力されるデータの質に依存します。この点を踏まえ、Command A は貴社内部の情報に基づいた正確な回答を安全に提供します。実際、顧客はこれを用いて、拠点ごとの関連人事ポリシーの抽出、法規制の確認、長文の財務報告書の分析などのタスクを遂行しています。
次世代の Cohere モデルは、金融、ヘルスケア、製造、エネルギー、公共部門など、あらゆる業界の顧客向けに、多種多様な AI アプリケーションの基盤として活用される予定です。特に、これらのモデルは以下とシームレスに統合されます:North。これは、AI エージェントを通じて貴社データと人材の潜在能力を最大限に引き出すための、安全な AI エージェントプラットフォームです。当社の完全統合されたテクノロジースタックにより、顧客の固有のビジネスニーズに合わせた製品のフルカスタマイズが可能になります。
North は、CRM や ERP などのエンタープライズツールを安全に活用し、社内データベースや外部ウェブ検索サービスにも接続できます。これにより、企業のファイアウォール内で動作し、ユーザーに代わってタスクを実行するエージェントを構築することが可能です。
提供状況
Command A は現在 Cohere プラットフォームで利用可能であり、研究目的で Hugging Faceでも利用可能です。また、主要なクラウドプロバイダーでも間もなく提供される予定です。プライベート環境やオンプレミスでの導入をご希望の場合は、当社の 営業チームまでお問い合わせください。
[1]BFCL:2025年3月12日時点のBFCL-v3ベンチマークにおけるパフォーマンス。公開されているリーダーボードからスコアを引用し、ない場合は公式コードベースを用いた社内評価で算出しています。競合製品については、「prompted」または「function-calling」のいずれか高い方のスコアを記載しています。ここでは、多様な実環境におけるツール利用能力を測定する総合スコアを報告しています。
Taubench:Taubenchベンチマークにおけるパフォーマンス。公開リポジトリのリーダーボードからスコアを引用し、ない場合は公式コードベースを用いた社内評価で算出しています。ここでは、マルチターン顧客サポートのユースケースにおけるツール利用エージェントを評価する「Retail」および「Airline」タスクのpass@1スコアを報告しています。
Academic:一般知識(MMLU)、数学能力(MATH)、および指示従順性(IFEval)を網羅する学術ベンチマークにおけるパフォーマンス。Command-Aは、GPT-4oやDeepSeek-V3と同等か、あるいはそれ以上のパフォーマンスを発揮することが確認されています。
Coding:Command-Aは、特にSQLベンチマーク(BirdBench、Spider Dev、Spider Testの平均)で優れたパフォーマンスを示し、MBPPlus(Pythonプログラミング)のユースケースではGPT-4oと同等の水準に達していることが分かりました。さらに、長いコンテキストにおけるリポジトリレベルの質問回答(RepoQA)でも優れたパフォーマンスを発揮することが確認されています。


