









本日、Cohere For AIは、23の異なる言語をカバーする、最先端の多言語生成大規模言語モデル(LLM)研究ファミリー「Aya 23」のリリースを発表いたします。多言語研究への継続的な取り組みの一環として、80億および350億パラメータのAya 23モデルをオープンウェイトとして公開します。
The Aya 23 model family builds on Aya - an open science movement that brought together 3,000 collaborators from around the world to build the largest multilingual instruction fine-tuning dataset to-date and state-of-the-art massively multilingual model. Aya 101 covered 101 languages and is focused on breadth, for Aya 23 we focus on depth by pairing a highly performant pre-trained model with the recently released Aya dataset collection. The result is a powerful multilingual large language research model serving 23 languages, expanding state-of-the-art language modeling capabilities to nearly half of the world's population.
Aya 23は、Ayaモデルおよびデータセットの広範なファミリーとともに、機械学習コミュニティがマルチリンガルAI研究に取り組む手法にパラダイムシフトをもたらします。LLMやAI全般が世界の技術的状況を一変させる中で、既存モデルの言語制限により、多くのコミュニティがサポートを受けられない状況に置かれてきました。性能の高い言語モデルの多くは、わずか数言語にしか対応していません。Aya 23は、より多くの言語を第一級市民として扱えることを実証する最先端の研究に貢献し、このミッションに参画する研究者を支援するモデルをリリースするという私たちの取り組みの一環です。Aya 23は、Ayaモデルおよびデータセットの広範なファミリーとともに、機械学習コミュニティがマルチリンガルAI研究に取り組む手法にパラダイムシフトをもたらします。
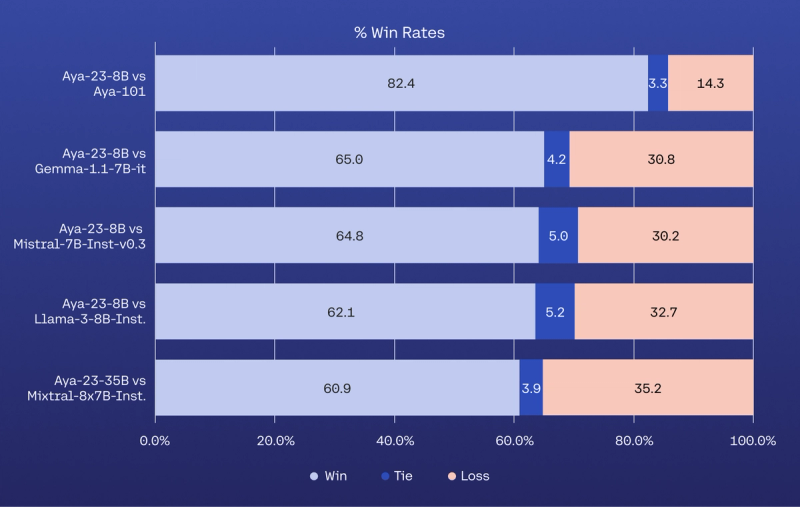
Aya 23 のパフォーマンスは、Aya-101 のような大規模な多言語オープンソースモデルや、一般的に利用されているオープンモデル(インストラクション・チューニング済み)の両者と比較して評価されています。350 億パラメータの Aya 23 は、対応するすべての言語においてベンチマークで最高の結果を達成し、80 億パラメータの Aya 23 はクラス最高の多言語性能を発揮します。このリリースを通じて、自然言語理解、要約、翻訳といった複雑なタスクにおいて、幅広い言語圏で優れた能力を実証します。
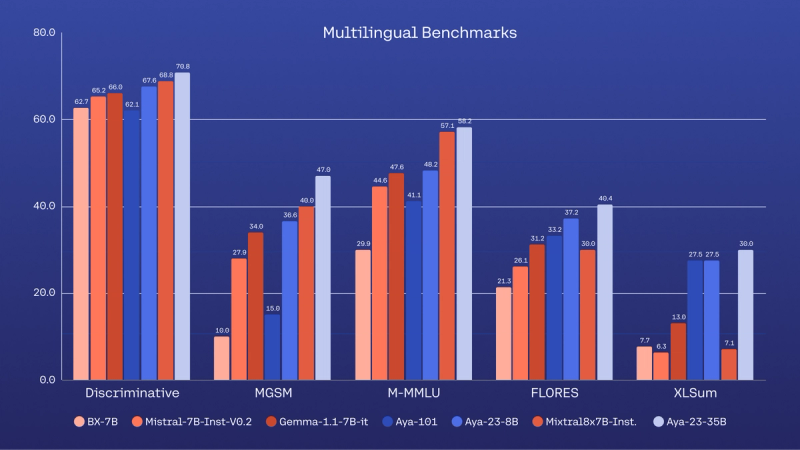
80 億パラメータ版の Aya 23 は、一般の開発者向けに、高効率で利用しやすい多言語リサーチモデルを開発するという当社のコミットメントを示すものです。モデルサイズが小さいため、計算リソースの要件を低減できます。これらはすべて、世界中の AI 研究者が最先端技術へのアクセスを民主化し、格差を解消するための重要な要素です。これは、当社ラボが継続的に取り組んでいる、大規模な効率性の追求という研究の一環です。当社の取り組みについて詳しくはこちらをご覧ください。こちら。
Aya 23は、基礎研究や安全性監査のための実験、探索、および開発に利用可能になりました。以下のページでこのモデルを体験いただけます:https://huggingface.co/spaces/CohereForAI/aya-23。
このモデルや、より広範なAyaプロジェクトの詳細については、こちらをご覧ください:https://cohere.com/research/aya。
また、複数の多言語NLPベンチマークにおける評価結果の完全なセットと生成品質の評価をまとめた、Aya 23に関する技術レポートも公開しています。


