









本日、Cohereの研究部門であるCohere For AIは、23言語にわたって優れた性能を発揮し、他の主要なオープンウェイトモデルを凌駕する高性能な多言語モデルファミリー「Aya Expanse」を発表いたします。
私たちは、多言語研究への継続的な取り組みの一環として、また多言語AIの限界を押し広げるため、KaggleとHugging Faceにて80億および320億パラメータのオープンウェイトモデルとしてAya Expanseをリリースします。80億パラメータモデルにより、世界中の研究者が画期的な成果をより容易に活用できるようになり、また320億パラメータモデルは、最先端の多言語性能を提供します。
Aya Expanseは、LLMにおける高品質な言語対応範囲を拡大するための重要なステップとなります。2年前にAyaイニシアチブを開始して以来、私たちは119カ国、3,000人以上の研究者と協力し、最先端の多言語研究を推進してきました。これには、5億1,300万件のデータ例を誇る史上最大規模の多言語データセットコレクションであるAyaコレクションのリリースや、多言語性能および安全性に関する重要な評価セットのリリースが含まれます。また、101言語をカバーする史上最も包括的な多言語モデルであるAya-101のリリースも行いました。
多言語研究の最前線
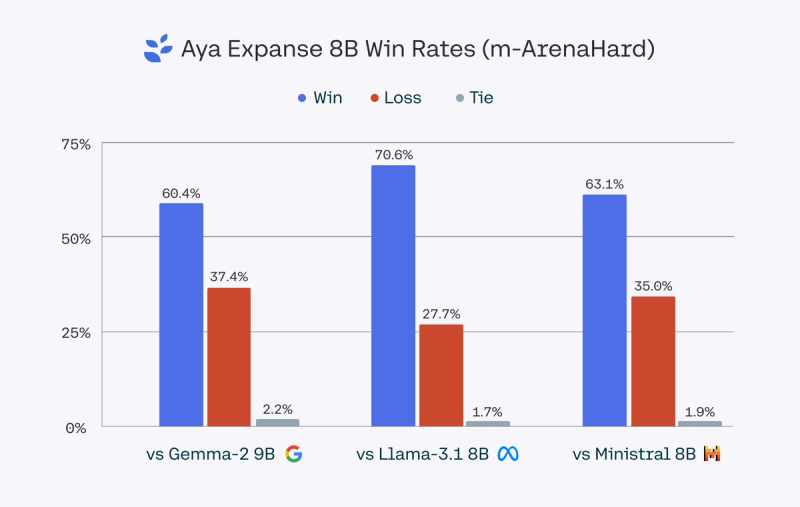
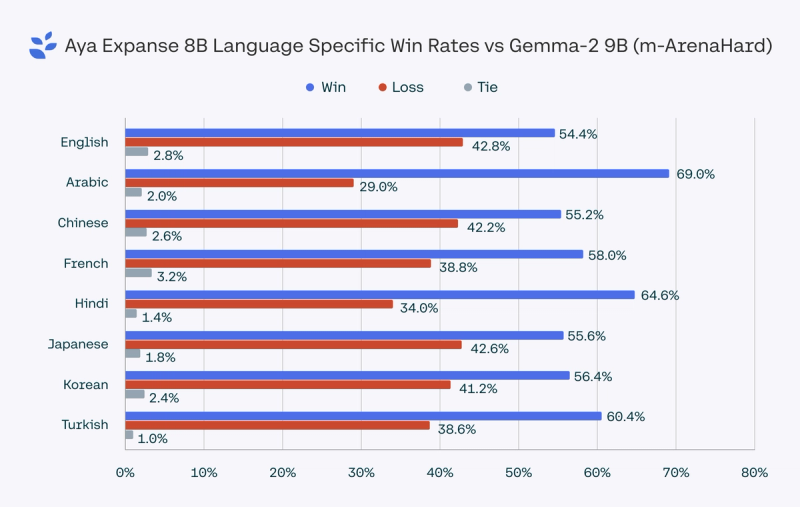
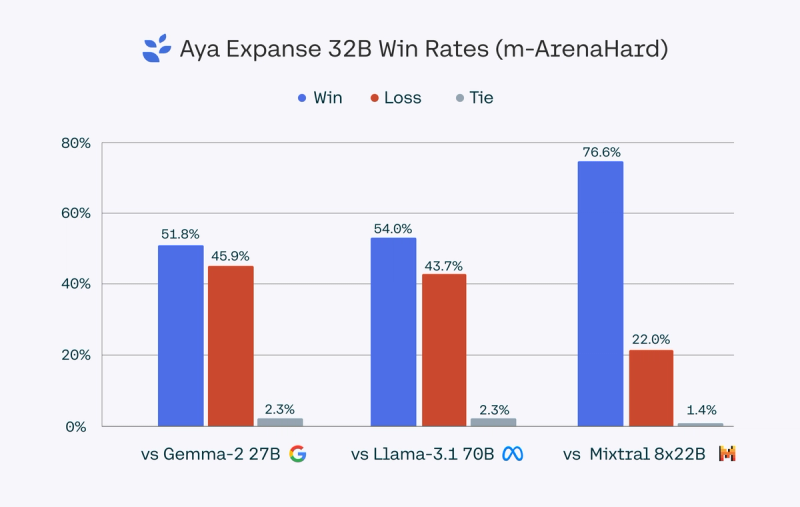
より大規模なモデルであるAya Expanse 32Bは、Gemma 2 27B、Mistral 8x22B、および自らの2倍以上のサイズを持つLlama 3.1 70Bを上回り、多言語性能において新たな最先端を切り拓いています。また、 Aya Expanse 8Bもリリースしました。これは、Gemma 2 9B、Llama 3.1 8B、最近リリースされたMinistral 8Bといった同クラスの主要なオープンウェイトモデルを、60.4%から70.6%という勝率で上回る性能を誇ります。
Aya Expanse の進化は、機械学習のブレイクスルーの根幹となる要素を再考し、世界中の多様な言語への AI の貢献を拡大することに注力し続けた結果です。ここ数年の研究テーマには言語の壁を克服することが重点的に盛り込まれており、現在の成果に不可欠ないくつかのブレイクスルーを達成しました。具体的には、「データ・アービトラージ」、data arbitrage、汎用的な性能向上のためのプリファレンス学習(好みの学習)、performance、および safety(安全性)、そして最後に「モデル・マージング」、model mergingが挙げられます。以下に、これらの研究について詳しくご紹介します。
データ不足の言語向けに合成データの活用を推進。合成データ(専門家や「教師」モデルによって生成され、別のモデルの学習に利用されるデータ)の活用は、大規模言語モデル(LLM)の開発においてますます重要になっています。特に、モデル学習で利用可能なデータソースが枯渇しつつある現状ではその傾向が顕著です。しかし、多言語データ、特にリソースの少ない言語においては、適切な教師モデルとなる事例が少なく、合成データの活用にはさらなる課題が存在します。
私たちは、合成データへの過度な依存による「意味をなさない文章」の生成(モード崩壊)を避けるため、「データ・アービトラージ」、data arbitrageと呼ぶ新しいデータサンプリング手法を提案しました。データ・アービトラージは、人間がスキルに応じて異なる先生に学ぶというアプローチに着想を得ています。例えば、ピアノを習いたいならピアノの先生に、料理を習いたいなら料理の専門家に師事します。私たちはこの考え方を AI にも適用し、データ分布に基づいて最適な「教師」モデルを戦略的に選択することで、多言語対応にふさわしい合成データを生成します。
世界的なニーズを反映したモデルの最適化。プリファレンス学習(好みの学習)は、モデル学習の最終段階で人間のフィードバックを活用し、高品質な出力のあり方をモデルに学習させる手法です。これは AI モデルの学習における「最後の仕上げ」と言えるでしょう。しかし、プリファレンス学習や安全対策は、欧米中心のデータセットに偏った有害性を過度に学習してしまう傾向があります。さらに問題なのは、これらの安全プロトコルが多言語環境にまで十分に適用されていない点です。私たちの研究は、異なる文化的・言語的視点を考慮し、プリファレンス学習を大規模な多言語環境に拡張した先駆的な取り組みの一つです。これにより、汎用的な performance(性能)と safety(安全性)の両面で大きな向上が見られました。
多様な世界におけるモデル・マージング。多言語性能におけるブレイクスルーを実現する最後のステップは、「モデル・マージング」、model mergingに関する研究です。これは、各段階で複数の候補モデルの重みを組み合わせることで、より高い汎用性と性能を実現する手法です。
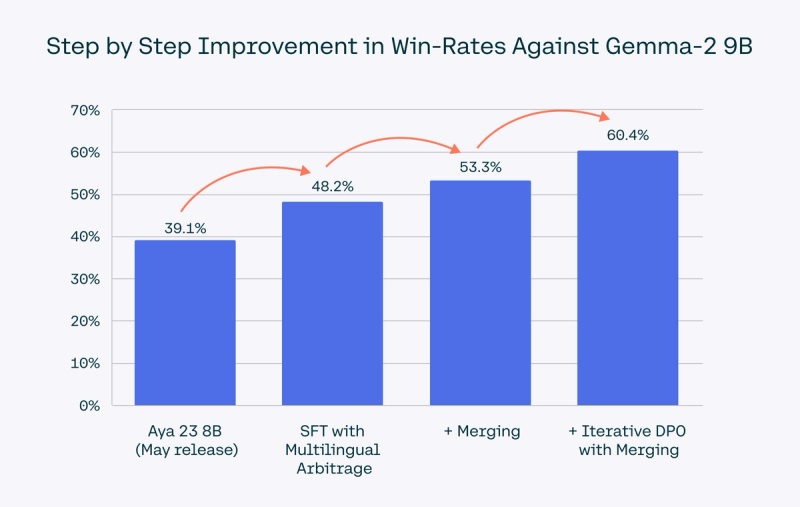
当社の研究成果を結集し、同クラスで最高水準の多言語モデルを構築しました。これらの手法をすべて統合し、Aya Expanseのための単一の学習レシピとして適用しました。データ・アービトラージからマージ、多言語嗜好最適化に至るまで、それぞれの手法が段階的な改善を実現し、同等のパラメータサイズを持つ他社の主要モデルに対して大幅な性能向上を達成しました。Gemma 2 9Bと比較して、Aya Expanse 8Bは60.4%という勝率を記録し、多言語LLM性能における同クラスでの新たな基準を打ち立てました。
多言語性能における最先端レベルへのスケールアップを実現。
今年開発し、Aya Expanseに統合した各アルゴリズム上のブレイクスルーは、より大規模なモデルサイズに対応して拡張され、最先端の性能を実現します。このポテンシャルを活かし、データ・アービトラージ、嗜好学習、マージを組み合わせた同一の学習レシピを採用しました。小規模モデルと同様に、このレシピは性能の大幅な向上をもたらします。Aya Expanse 32Bは、Gemma 2 27B、Mistral 8x22B、およびより大規模なLlama 3.1 70Bを上回り、23言語全体で51.8%から76.6%までのペアワイズ勝率を記録しました。
これらの結果は、小規模言語モデルを超えた多言語領域における当社の研究の成果を示しており、大規模展開における多言語性能の新たな最先端を切り拓くものです。
ぜひご参加ください
8Bおよび35Bモデルのウェイト公開に加え、多言語AIの加速に向けて研究コミュニティ全体と積極的に連携しています。当社の研究助成金への申請は、こちらからどうぞ。また、次回の研究コホートへの参加も募集しています。こちらでは、機関間の連携を促進するため、コンピューティングリソースと専門知識を提供します。
Ayaは、多言語性能と安全性の向上に対する当社の継続的なコミットメントの一環です。当社の研究に関する詳細は、こちらをご覧ください。ぜひ私たちと共に歩んでください。
Aya Expanseモデルは、現在、研究者や開発者がCohere APIプラットフォーム、Kaggle、およびHugging Faceで利用可能です。
謝辞
この成果は、Cohere For AIとCohereの両チームによる多大な努力の結晶です。また、世界中からこのリリースに参加した220名の言語アンバサダーからなる研究コミュニティにも深く感謝いたします。以下にアルファベット順で記載します。
メフメト・エムレ・アクブルト(トルコ/トルコ)、サメル・アトラ(オランダ語、アラビア語/オランダ)、MUHDIN AWOL(英語/エチオピア)、ケンザ・ベンキラネ(アラビア語、フランス語/モロッコ)、マン・バナシャリ(ヒンディー語、英語/インド)、イザベラ・ビカーリョ・フラゼト(フランス語、ポルトガル語/ブラジル、フランス)、ダニロ・ボイコ(ウクライナ語/ウクライナ)、サブリナ・ブマイザ(アラビア語/アルジェリア)、サミュエル・カヒヤウィジャヤ(インドネシア語/インドネシア)、サミュエル・カヒヤウィジャヤ(インドネシア語、英語/インドネシア)、エミルハン・チェリク(トルコ語/トルコ)、ライアン・チャン(イタリア語、英語/イギリス)、オレリアン=モーガン・クロドン(フランス語/フランス)、ウルズラ・チェルヴィンスカ(ポーランド語、フランス語/フランス、ポーランド)、ジョアナ・ダ・マッタ(ポルトガル語/ブラジル)、グエン・ザット(ベトナム語/ベトナム)、マナスヴィ・ダワネ(ヒンディー語/インド)、アーカンシャ・デヴカル(ヒンディー語/インド)、シャラド・ドゥワル(英語/ネパール)、アブデルジャリル・エル・マジョディ(アラビア語/モロッコ)、シャファグ・ファダエイ(ペルシャ語/イラン)、ニール・フェルナンデス(ドイツ語、日本語、ヒンディー語/カナダ)、シルビア・フェルナンデス(スペイン語、英語/アルゼンチン)、ハミドレザ・ガデル(ペルシャ語、オランダ語/イラン、オランダ)、マヌエル・ゴウラォン(ポルトガル語/ポルトガル)、バッサム・グティ(アラビア語、チュニジア方言/チュニジア)、マリア・グランドゥリ(スペイン語/スペイン)、ミゲル・ゲレロ(スペイン語/スペイン)、シドヘシュ・グンジャル(ヒンディー語/インド)、モハメド・ハムディ(アラビア語、英語/エジプト)、ハフェド・ヒクリ(アラビア語、フランス語/チュニジア)、グエ・ホアン・アイン・クイン(日本語、ベトナム語/日本、ベトナム)、カイル・ハワード(英語、スペイン語/アメリカ合衆国)、ジウング・ヒョン(韓国語/韓国)、ジョセフ・マービン・インペリアル(フィリピン語/フィリピン)、ブリン・インタチュエン(日本語/日本)、ライアン・ジュネジョ(英語、ヒンディー語/カナダ)、フアン・ジュンケラス(スペイン語/アルゼンチン)、カルティク・レディ・カンジュラ(英語、ヒンディー語/アメリカ、インド)、アルバート・カオ(中国語/台湾)、モルテザ・カシャニ(ペルシャ語/イラン)、アフメド・ハレド(アラビア語/エジプト)、ニハリカ・カンナ(ヒンディー語、パンジャブ語/インド)、ディピカ・クール(ヒンディー語/アメリカ、インド)、クリストファー・クラム(ドイツ語/ドイツ)、ナザル・コフート(ウクライナ語/ウクライナ)、アルキス・クドゥナス(イタリア語、ギリシャ語/イタリア、ギリシャ)、ディアナ・コザチェク(ドイツ語、ウクライナ語/ドイツ)、カタリーナ・ローレンス(英語、フランス語、ドイツ語/カナダ)、ジェームズ・レオン(スペイン語/エクアドル)、リアジェン・リー(中国語/中国、イギリス)、ニコロ・ロッド(イタリア語/イタリア)、ダンテ、フ・オン・ロク(中国語、英語/香港)、イロ・マルタ(ギリシャ語、ドイツ語/ギリシャ、ドイツ)、ハラース・マンスール(ウルドゥー語/パキスタン)、バヴニック・ミンハス(ヒンディー語/インド)、シャハル・ミルキン(ヘブライ語)、ロア・ア・モハメド(アラビア語/ヨルダン)、イーヤン・ナン(中国語/中国)、スリ・ハルシャ・ネラトゥル(ヒンディー語、ドイツ語/インド、ドイツ)、エカテリーナ・ノヴィコワ(英語、ロシア語/カナダ)、ロニ・オベイド(アラビア語、英語/シリア)、オリンピア・オティエノ(英語/ケニア)、エネス・オズゴズラー(トルコ語/トルコ)、ヤヴズ・アルプ・センセル・オズトゥルク(トルコ語/トルコ)、カルロス・パティニョ(スペイン語/コロンビア)、ジェビシュ・プルベイ(英語、ヒンディー語/ネパール)、マリア・キハノ・ヘスルール(スペイン語/コロンビア)、スワティ・ラジュワル(ヒンディー語、英語/アメリカ)、ディディ・ラムサラン・チン(スペイン語、英語/ベネズエラ)、ディヴヤラジ・ラナ(ヒンディー語、英語/アメリカ)、アディティヤ・レトナント(インドネシア語/インドネシア)、ロドリゴ・リベイロ・ゴメス(ポルトガル語/ブラジル)、エスラー・サレハ(英語、アラビア語/カナダ)、ロシャン・サントシュ(ヒンディー語/インド、アメリカ)、ドリシュティ・シャルマ(ヒンディー語、スペイン語/インド、スペイン、ラテンアメリカ諸国)、キンザ・シェイク(ウルドゥー語/パキスタン)、アディティヤ・シュリヴァスタヴァ(ヒンディー語、英語/インド、アイルランド)、ヴィヴェク・シリムハン(ヒンディー語、英語/インド)、マルジャナ・スケンドゥリ(英語、イタリア語/アルバニア)、ソハム・ソナール(ヒンディー語、マラーティー語/インド)、グルカン・ソイカン(トルコ語/トルコ)、デビッド・スタイヴン(ポルトガル語/ブラジル)、アンソニー・スセフスキ(英語/カナダ)、アドリアン・シミャク(ポーランド語/ポーランド)、ジョアンヌ・タン(英語、中国語/シンガポール)、クウェンティン・タルディフ(フランス語/フランス)、アミード・テイラー(英語、ドイツ語/アメリカ、ドイツ)、イオルゴス・ツァリキディス(ギリシャ語/ギリシャ)、ロマン・ティムツィフ(ウクライナ語/ウクライナ)、ムハンマド・サアド・ウディン(ドイツ語/ドイツ)、ルイ・ウルマー(フランス語/フランス)、スンダル・スリパダ V. S.(英語/アメリカ)、フレディ・ヴァーガス(英語、スペイン語/アメリカ)、ウラジスラフ・ヴァシレスク(ルーマニア語/ルーマニア)、カラン・ヴェルマ(英語、ヒンディー語/インド)、ヘンリー・ヴォ(ベトナム語/ベトナム)、ミン・チエン・ヴ(日本語、ベトナム語/日本、ベトナム)、ヒエウ・ヴ(ベトナム語/ベトナム)、アズミン・トゥシク・ワシ(英語、ヒンディー語、アラビア語、スペイン語/バングラデシュ)、ウォーレン・ウィリアムズ(英語/アメリカ)、ジョセフ・ウィルソン(フランス語/カナダ)、グスティ・ウィナタ(インドネシア語/インドネシア)、エゲ・ヤクット(トルコ語、英語/トルコ)、エライ・ヤパグチ(トルコ語/トルコ)、タハ・ヤシン(アラビア語、フランス語/モロッコ)、セルハン・ユルマズ(トルコ語/トルコ)、ハンナ・ユヒメンコ(ウクライナ語/ウクライナ)、マイク・ジャン(オランダ語/オランダ)。


