Contributeurs clés : Manoj Govindassamy, Maxime Brunet, Jeremy Pekmez, Inna Shteinbuk, Elliott Choi
Cohere lance Model Vault, une plateforme SaaS dédiée et entièrement isolée permettant aux clients d’exécuter les modèles Cohere de manière sécurisée, à grande échelle et avec des performances garanties.
Model Vault combine la réduction des frais opérationnels d'un SaaS entièrement géré avec les avantages de sécurité et de performance de l'hébergement sur site. Les utilisatrices et utilisateurs de North déploient leur application au sein d'un VPC sécurisé tout en confiant l'inférence des modèles, lourde en maintenance, et la mise à l'échelle à leur Model Vault sécurisé basé sur le cloud. Le résultat : un coût total de possession réduit et une adoption plus rapide par les entreprises.
Model Vault marque une étape importante dans le parcours de Cohere visant à fournir une IA transformatrice qui résout les défis concrets auxquels sont confrontés les clients d’entreprise aujourd’hui. Poursuivez votre lecture pour en savoir plus sur ce qui est proposé, ou commencez dès maintenant.
Le compromis entre commodité et contrôle
Au cœur de la transformation de l’IA en entreprise se trouve une contrainte fondamentale : comment équilibrer la rapidité et l’ampleur de l’adoption avec les exigences de contrôle de l’infrastructure et de conformité d’une organisation moderne et mature.
Il s’agit de plus en plus d’un problème lié à l’inférence. Alors que les entreprises s’efforcent d’intégrer des modèles dans davantage de flux de travail, d’équipes et de produits, l’inférence remplace progressivement l’entraînement en tant que charge de travail dominante de l’IA. McKinsey prévoit désormais que l’inférence représentera la majorité des calculs liés à l’IA d’ici la fin de la décennie, même si les coûts par unité continuent de baisser. Pour les entreprises, cela déplace la préoccupation principale, passant du financement d’opérations d’entraînement ponctuelles à la prise en compte de l’inférence — un coût récurrent qui augmente directement avec l’adoption.
Pour la plupart des entreprises, les options de déploiement disponibles reflètent clairement cette tension. Les plateformes SaaS multi-locataires privilégient la rapidité et la simplicité opérationnelle en répartissant les coûts d’infrastructure entre plusieurs clients. Cependant, l’absence d’isolation des charges de travail, inhérente aux environnements partagés, engendre des problèmes tels que les effets de « voisin bruyant », l’imposition de limites de débit lors des pics d’utilisation et une latence imprévisible. Ces plateformes ont également tendance à limiter la configurabilité des modèles, à offrir peu de visibilité sur les performances au niveau des charges de travail et à ne pas toujours répondre aux normes de conformité des entreprises hautement réglementées.
Les déploiements sur site — qu’ils soient sur site physique ou au sein d’un VPC géré par le client — répondent à bon nombre de ces limitations en offrant un meilleur contrôle sur l’infrastructure, les caractéristiques de performance et les périmètres de sécurité. Cependant, la charge financière et opérationnelle qui sous-tend ce contrôle peut s’avérer prohibitivement coûteuse, en particulier pour les équipes souhaitant passer à grande échelle.
Avec North, la plateforme d’entreprise de Cohere dédiée à la création d’applications d’IA agentique, ce problème d’infrastructure devient encore plus aigu. Le déploiement des modèles nécessite toujours la mise en place et la gestion de matériel, mais les charges de travail agentiques sont, par leur conception, intermittentes, multifacettes et imprévisibles.
Un nouveau cadre pour un déploiement d'IA évolutif et sécurisé
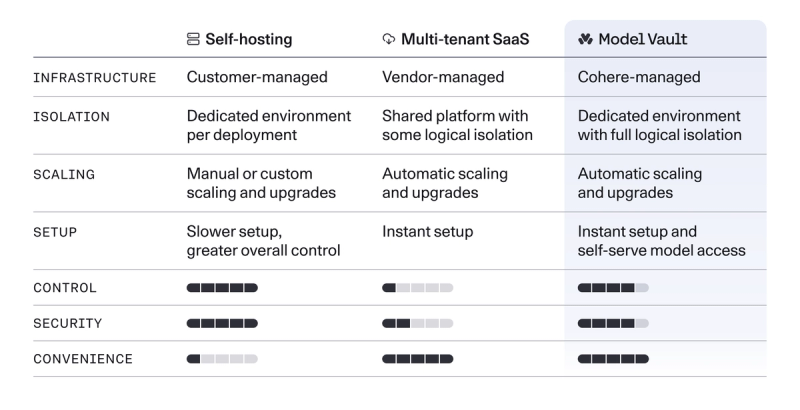
Model Vault est la dernière nouveauté de la suite d'options de déploiement sécurisé de Cohere. Il est conçu pour résoudre ce compromis entre commodité et contrôle en transférant les charges opérationnelles de l'inférence des modèles vers un environnement cloud sécurisé, géré par Cohere.
Le résultat est un modèle de déploiement SaaS qui élimine les contraintes liées à l'infrastructure partagée, telles que la concurrence pour les ressources et les performances imprévisibles, tout en préservant la rapidité, l'élasticité et la simplicité d'utilisation propres aux plateformes SaaS multi-tenants.
Pour être clair, il n'existe pas d'approche de déploiement unique adaptée à toutes les organisations. Pour certaines entreprises, le SaaS multi-tenant ou les déploiements auto-hébergés resteront le meilleur choix, selon leurs capacités internes, leur stratégie de données et leurs exigences réglementaires. Les secteurs disposant de flux de travail hautement standardisés, par exemple, peuvent répondre aux besoins de conformité grâce à des contrôles au niveau de l'application et continuer à privilégier les plateformes SaaS partagées.
Mais pour de nombreuses entreprises, la gestion de l'infrastructure est devenue un obstacle croissant au déploiement d'IA agentique de niveau production. Elles souhaitent augmenter la capacité d'inférence des modèles sans accroître la charge opérationnelle. Model Vault a été conçu pour ces équipes.
Dissociez l'inférence du développement
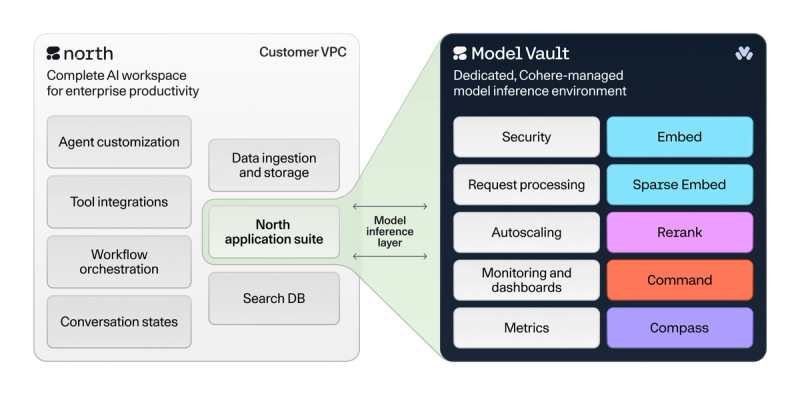
Model Vault est une solution gérée par Cohere. Cela signifie que nous assumons l'intégralité de la charge opérationnelle liée à l'inférence en production : déploiement des modèles, gestion des mises à jour et des dépendances, allocation et mise à l'échelle des capacités, ainsi que garantie des performances et de la disponibilité. Nous offrons aux utilisateurs de Model Vault une disponibilité garantie de 99,9 % et plus, soutenue par des SLO de niveau production et des performances de latence qui égalent ou surpassent les principales plateformes de déploiement d'IA/ML gérées.
Cela réduit considérablement le coût total de possession en éliminant le besoin pour les clients d'acquérir, de configurer et d'exploiter une infrastructure d'inférence basée sur des GPU. Les déploiements North peuvent désormais fonctionner entièrement sur des environnements CPU uniquement, tandis que les tâches d'infrastructure ML les plus lourdes sont exécutées au sein de votre Model Vault.
Model Vault permet aux équipes ML de mettre à l'échelle les charges de travail de manière élastique sans allouer de capacité à l'avance ni assumer le risque de GPU inutilisés. La capacité d'inférence s'adapte à la demande, éliminant ainsi le dilemme entre une surallocation pour garantir des performances optimales et une sous-allocation qui dégrade la latence et la disponibilité.
En termes simples, Model Vault permet à Cohere de prendre en charge la complexité opérationnelle du service de modèles, libérant ainsi votre atout le plus précieux — vos ingénieurs — pour qu'ils se concentrent sur le passage des applications d'IA agentique de la phase d'expérimentation à la production. L'inférence n'est pas votre facteur de différenciation.
Dans tous les cas, le contrôle reste entre les mains de l'entreprise là où cela compte le plus. Les clients de North conservent la pleine propriété du plan de contrôle, couvrant la logique des agents, l'orchestration des flux de travail, les états de conversation, le stockage des données et les pipelines. Ils bénéficient d'une flexibilité architecturale totale pour choisir quelles données et charges de travail héberger sur site ou sur leurs VPC existants, et lesquelles peuvent être gérées par Model Vault.
Aucun partage. Aucune limite. Aucune surprise.
Model Vault est déployé sous forme de cloud privé virtuel logiquement isolé. Aucun composant d'infrastructure n'est partagé entre les clients, ce qui garantit une isolation robuste pour des performances, une fiabilité et une sécurité optimales. Cela inclut des équilibreurs de charge réseau dédiés, des reverse proxies, des middlewares de diffusion, des serveurs d'inférence et les accélérateurs GPU sous-jacents.
Les équipes peuvent désormais utiliser Model Vault pour exécuter des charges de travail de production illimitées sans être limitées par une capacité restreinte. Les ressources que vous provisionnez vous sont réservées : finis les quotas de limitation pour maintenir la stabilité de la plateforme. Parallèlement, Model Vault ajuste dynamiquement la capacité d'inférence selon une logique personnalisable, garantissant ainsi des performances constantes, même lors de pics d'inférence liés à des agents autonomes.
Observez et optimisez en temps réel
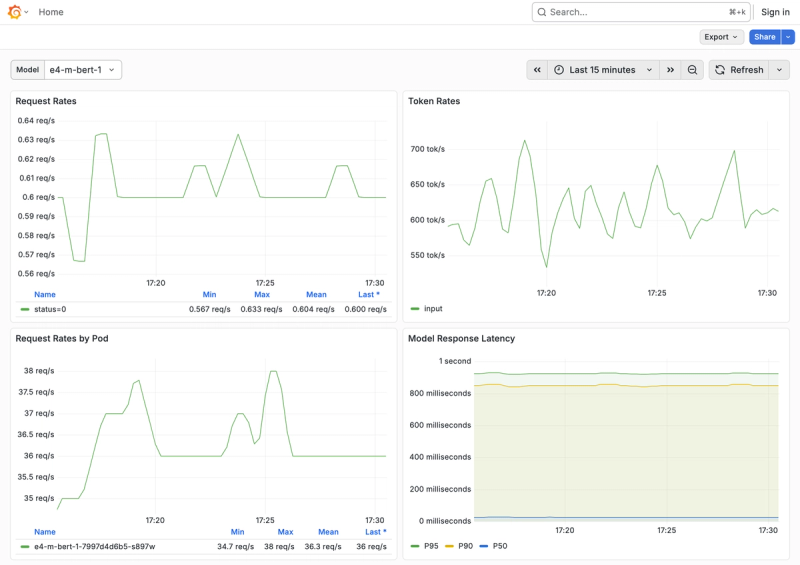
Model Vault offre aux équipes MLOps une visibilité unique sur le comportement des charges de travail d'inférence en production. Grâce à un tableau de bord dédié en temps réel, les équipes peuvent suivre les modèles de requêtes, la latence, le débit de tokens et l'utilisation des ressources, ce qui leur permet d'identifier rapidement les goulots d'étranglement et d'optimiser continuellement l'efficacité, la prévisibilité et les performances à mesure que la demande évolue.
Prise en main
Model Vault est conçu pour une intégration rapide et intuitive, avec une configuration manuelle minimale. Il peut être intégré à votre déploiement North existant ou servir de plateforme d'inférence privée pour les modèles Cohere utilisés de manière autonome.
Voici comment créer votre Model Vault en quelques minutes :
Sans North :
- Rendez-vous sur dashboard.cohere.com. Créez un compte et connectez-vous.
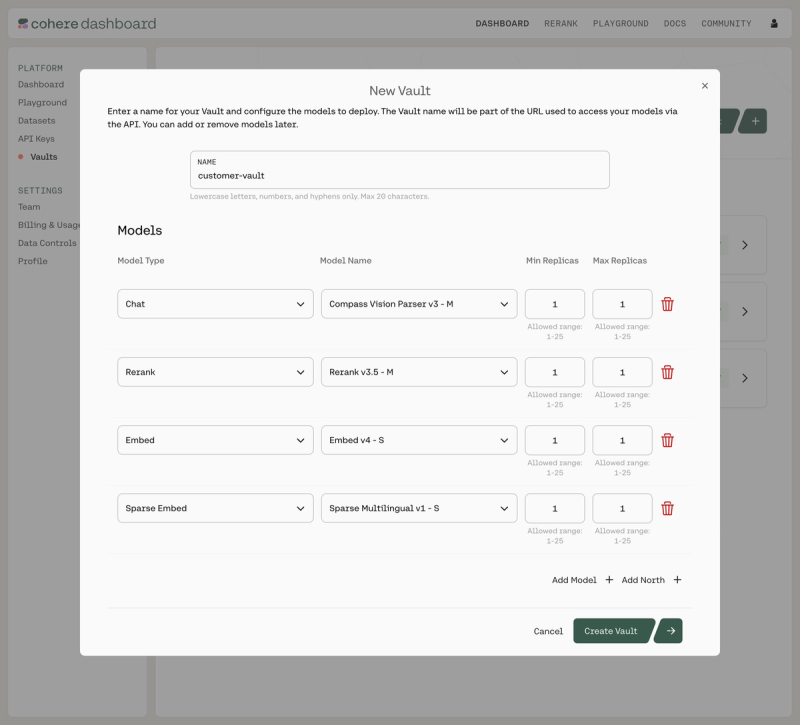
- Accédez à la section « Vaults » dans la barre latérale, puis sélectionnez « + Nouveau Vault ».
- Nommez votre Vault.
- Sélectionnez votre modèle Cohere ainsi que le niveau de performance.
- Précisez la plage de réplicas souhaitée pour chaque modèle sélectionné. Cela définit vos limites de mise à l'échelle.
- Confirmez la création de votre Vault.
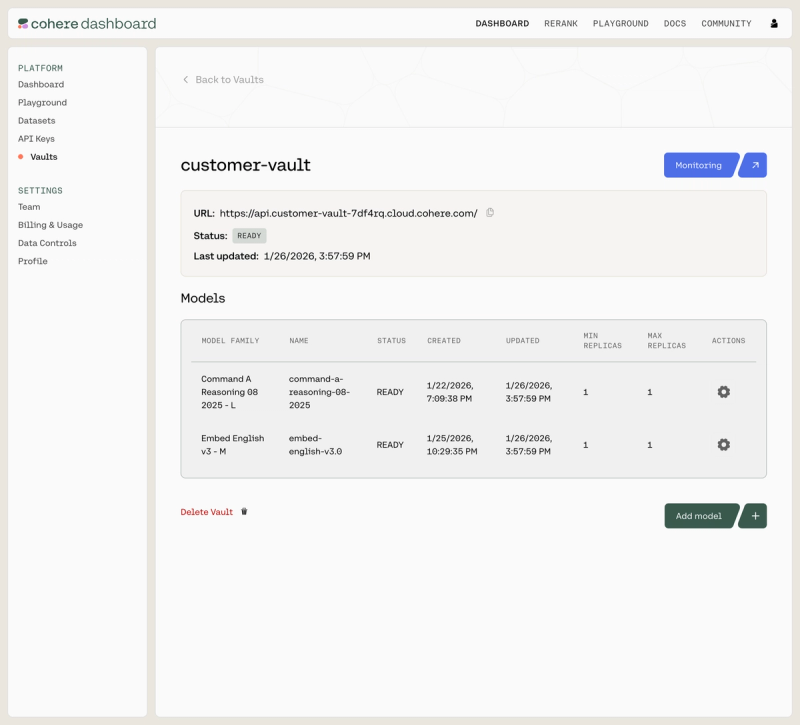
C'est tout ! Votre infrastructure est provisionnée et vous recevrez instantanément votre sous-domaine unique, votre point de terminaison API ainsi que l'accès à votre tableau de bord de surveillance privé.
Avec North :
- Suivez les étapes ci-dessus pour créer un Model Vault dédié à votre organisation.
- Assurez-vous de sélectionner les modèles dont vous avez besoin pour votre déploiement North.
- Une fois que vous disposez de votre point de terminaison API, mettez à jour le graphique Helm dans votre déploiement North afin que les modèles souhaités pointent vers ce point de terminaison.
- Après la configuration, les clients peuvent gérer les points de terminaison d'inférence principaux et secondaires pour les modèles Command dans North directement depuis l'interface d'administration.
- Votre déploiement North est désormais configuré avec Model Vault.
Modèles pris en charge
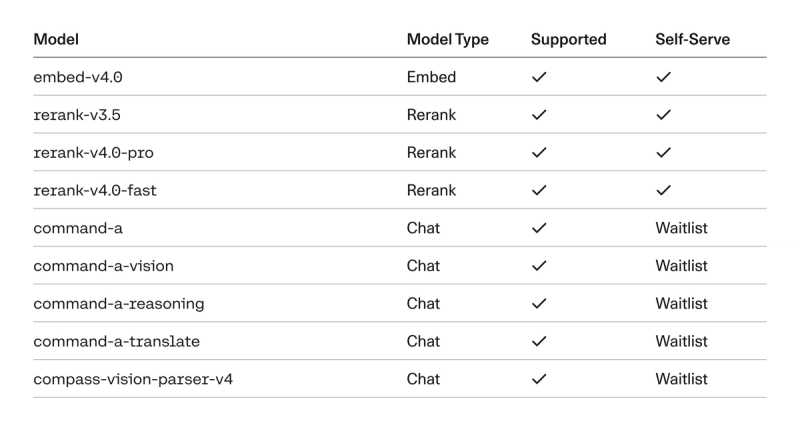
Model Vault prend actuellement en charge tous les derniers modèles de pointe de Cohere, notamment les modèles d'embedding, de rerankage, et génératifs. Cela inclut des offres groupées pour nos clients North (voir le tableau ci-dessous).
De plus, les modèles Rerank et Embed, qui sous-tendent les capacités de recherche et de récupération d'IA de pointe de Cohere, peuvent également être accessibles en libre-service via votre Model Vault. Cela signifie un accès à la demande pour une configuration fluide et une expérimentation plus rapide. Les clients intéressés par un accès en libre-service à nos modèles Command ou à des bundles de modèles intégrés peuvent demander à rejoindre la liste d'attente.
Les forfaits tarifaires de Model Vault sont flexibles et peuvent être adaptés aux besoins de charge de travail de votre équipe ainsi qu'à vos préférences budgétaires. Contactez un membre de notre équipe pour trouver la solution la mieux adaptée à vos besoins.
Vous pouvez également consulter notre documentation pour obtenir des instructions complètes étape par étape, ainsi que nos spécifications de modèles et guides pratiques pour développer des applications d'IA agentique dans North.
Développez rapidement. Gardez le contrôle.
Commencez dès aujourd'hui à déployer une IA d'entreprise sécurisée et performante avec Model Vault. Lancez-vous.