









Heute stellen wir Command A Reasoning vor, unser fortschrittlichstes Modell für Reasoning-Aufgaben in Unternehmen. Von agentenbasierten Workflows bis hin zu End-to-End-Systemen übertrifft es führende lokal einsetzbare Modelle seiner Klasse, darunter gpt-oss-120b, DeepSeek-R1 0528 und Mistral Magistral Medium.
Command A Reasoning wurde speziell für die Anforderungen von Unternehmen entwickelt und bietet hochgradig sichere, effiziente sowie skalierbare Bereitstellungsoptionen. Bei Bereitstellungen mit geringem Ressourcenbedarf kann es auf einer einzelnen H100- oder A100-GPU mit einer Kontextlänge von 128k betrieben werden. Bei Latenz-optimierten Bereitstellungen auf zwei oder mehr GPUs skaliert die Kontextlänge auf 256k. Diese Flexibilität stellt sicher, dass Unternehmen die verfügbare Hardware optimal nutzen können. Die lange Kontextlänge des Modells macht es ideal für dokumentenintensive Workflows und komplexe, mehrstufige agentenbasierte Anwendungsfälle.
Kunden können ein Token-Budget festlegen, um die Rechenlast direkt zu steuern und Kosten zu kontrollieren. Dies macht separate Modelle für Reasoning- und Nicht-Reasoning-Aufgaben überflüssig, da Command A Reasoning sowohl für Aufgaben genutzt werden kann, die maximale Präzision erfordern, als auch für eine höhere Geschwindigkeit und Durchsatzrate konfiguriert werden kann, wenn Effizienz im Vordergrund steht.
Command A Reasoning ist das zentrale generative Modell, das North, unsere sichere agentenbasierte KI-Plattform, antreibt. Dies ermöglicht es Unternehmen, maßgeschneiderte KI-Agenten und Automatisierungen On-Premises bereitzustellen, unterstützt durch unser leistungsfähigstes Reasoning-Modell.
Hervorragende Leistung bei Reasoning-Aufgaben in Unternehmen
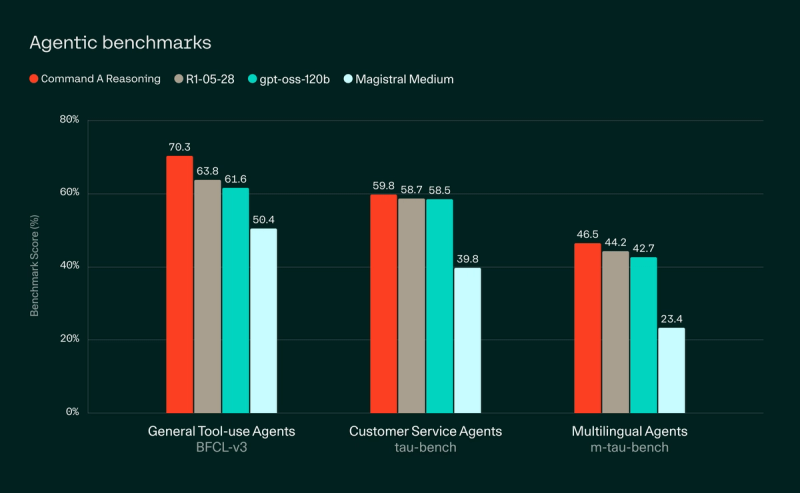
Benchmarks für agentenbasiertes und mehrsprachiges Reasoning
Command A Reasoning liefert führende Ergebnisse in wichtigen Benchmarks für agentenbasierte Anwendungen. Zudem erzielt es exzellente Leistungen in einer Vielzahl relevanter Geschäftsprachen, sodass globale Unternehmen KI-Agenten mit konsistenter Qualität einsetzen können.
Außergewöhnlicher Deep-Research-Agent
Command A Reasoning ist hervorragend geeignet, um End-to-End-Systeme mit verketteten und hierarchischen Agenten zu betreiben und die relevantesten Tools zur Aufgabenbewältigung einzusetzen. Ein herausragendes Beispiel ist unser Deep-Research-System, das ähnliche Funktionen aller anderen führenden KI-Labore übertrifft.
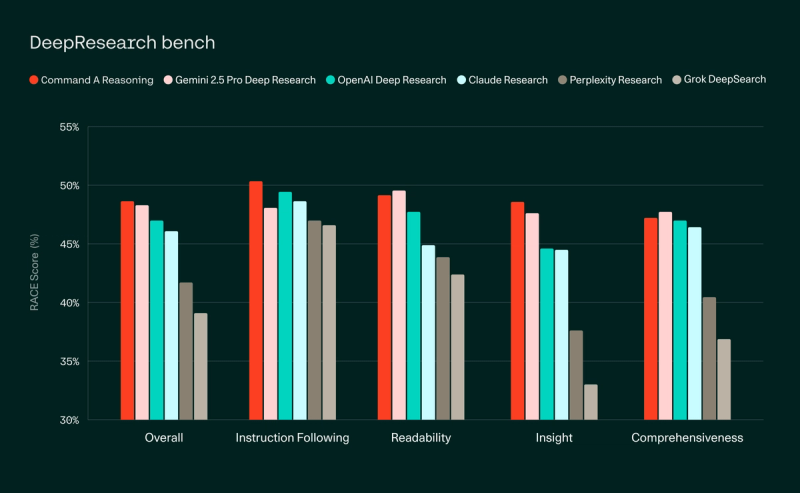
Deep Research ist darauf ausgelegt, komplexe und tiefgreifende Fragen zu beantworten, die mehr als eine einfache Suche erfordern. Es liefert innerhalb weniger Minuten detaillierte, fundiert belegte Berichte, für die ein Mitarbeiter normalerweise Stunden benötigen würde. Unser System nutzt eine Multi-Agenten-Architektur, die auf Command A Reasoning basiert und die Benutzeranfrage in kleinere Forschungsthemen unterteilt. Anschließend arbeiten mehrere KI-Agenten parallel, um Informationen aus einer Vielzahl von Quellen zu suchen und zu analysieren. Abschließend fasst das System die verifizierten Erkenntnisse in einem einzigen, gut strukturierten Bericht zusammen, der die ursprüngliche Benutzeranfrage direkt beantwortet. Deep Research wird bald in North verfügbar sein.
Die technologische Basis für North, Cohere’s führende Enterprise-KI-Plattform
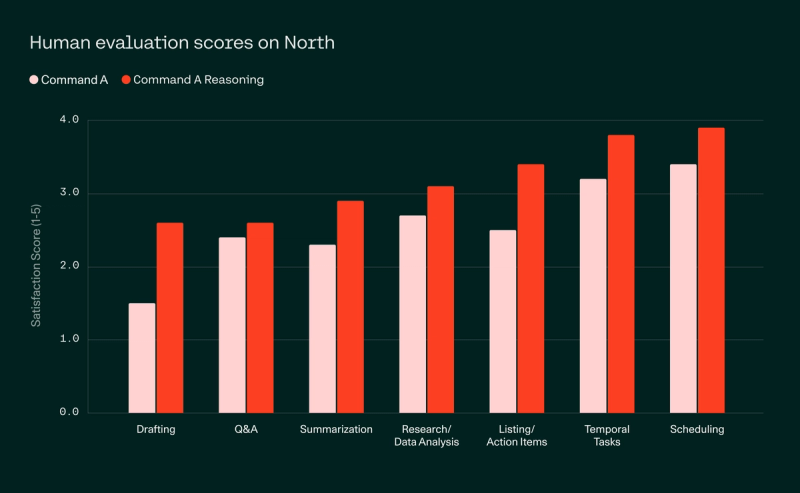
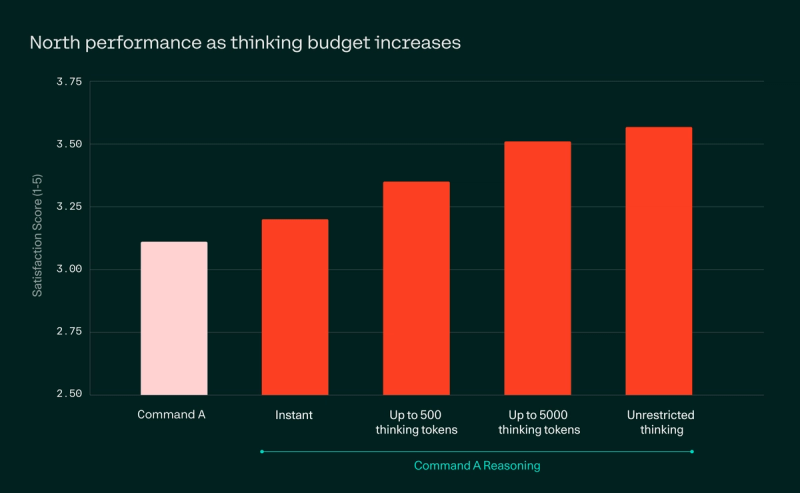
North ermöglicht Unternehmen, die großen Wert auf Datensicherheit legen, den großflächigen Einsatz von KI-Agenten und Automatisierungen innerhalb ihrer eigenen Infrastruktur. In menschlichen Evaluierungen für eine repräsentative Auswahl täglicher Arbeitsaufgaben übertrifft Command A Reasoning durchgängig das Modell Command A. Für Kunden bedeuten diese Fortschritte zuverlässigere Agenten, weniger manuellen Eingriff und die Bereitstellung hochpräziser, umsetzbarer Ergebnisse.
Kontrolle und Effizienz für den Enterprise-Maßstab
Command A Reasoning eröffnet branchenübergreifend neue Geschäftsmöglichkeiten, indem es starke Leistung, hohe Genauigkeit und skalierbare Effizienz vereint. Die geringen Hardwareanforderungen machen es ideal für den privaten Einsatz auf einer einzelnen H100- oder A100-GPU.
Das Modell optimiert den Rechenaufwand und die Kosten durch ein benutzergesteuertes Token-Budget, was eine nahtlose Anpassung zwischen präzisen, geschäftskritischen Aufgaben und hochvolumigen Workloads ermöglicht. Dies macht separate Reasoning- und Non-Reasoning-Modelle überflüssig und erlaubt Unternehmen, die GPU-Effizienz zu maximieren sowie Ressourcen dynamisch zuzuweisen.
In internen Evaluierungen von North zeigt die Anpassung des Reasoning-Budgets eine kontinuierliche Steigerung der Leistung: von effizienten Antworten bei deaktiviertem Reasoning bis hin zu tiefergehenden Analysen bei höheren Reasoning-Stufen. Selbst ohne Reasoning übertrifft Command A Reasoning das Modell Command A.
Sicherheit in kritischen Umgebungen gewährleistet
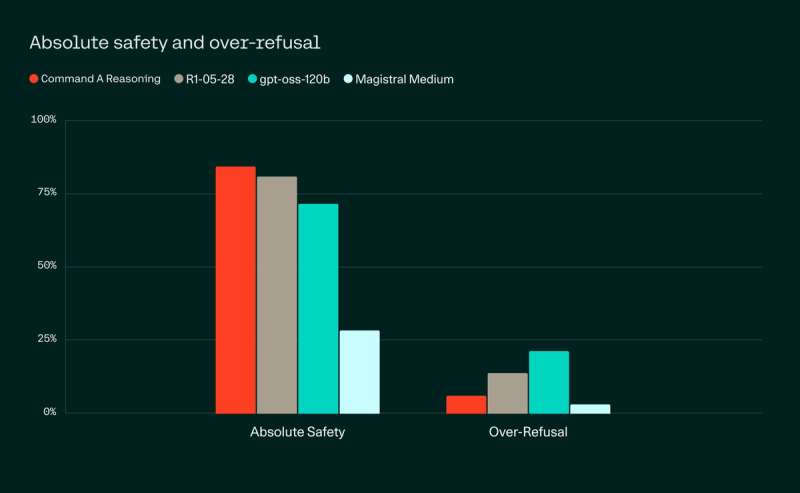
Sicherheit ist die Grundlage für das Training und die Evaluierung all unserer Modelle, einschließlich Command A Reasoning. Dabei gilt es, die optimale Balance zu finden: Einerseits muss verhindert werden, dass das Modell legitime Anfragen zu häufig ablehnt, andererseits muss die gezielte Verbreitung schädlicher und bösartiger Inhalte im Internet unterbunden werden. Unser Fokus liegt auf fünf Kernbereichen: sexueller Missbrauch und Ausbeutung von Kindern (CSEA), Selbstverletzung, Gewalt und Hassrede, sexuelle Inhalte sowie Verschwörungstheorien.
Verfügbarkeit
Command A Reasoning ist ab sofort auf der Cohere-Plattform verfügbar und kann für Forschungszwecke auch auf Hugging Face genutzt werden. Wenn Sie an privaten oder On-Premise-Bereitstellungen interessiert sind, wenden Sie sich bitte an unser Vertriebsteam für individuelle Preisangebote.
„Wir freuen uns auf die Partnerschaft mit Cohere, um deren Command A Reasoning-Modell in unser generatives KI-Hub in der SAP Business Technology Platform zu integrieren. Dieses leistungsstarke Modell wird die generativen KI-Funktionen von SAP erweitern und Kunden, Partnern sowie Entwicklern ermöglichen, innovative und sichere agentische Anwendungen zu erstellen, die genau auf ihre individuellen Anforderungen zugeschnitten sind. Gemeinsam erschließen wir neue Möglichkeiten für Reasoning-Aufgaben in Unternehmen.“ — Dr. Walter Sun, SVP und Global Head of AI, SAP SE
[1]Wir betreiben alle Modelle mit deren jeweils höchster verfügbarer Reasoning-Einstellung.
Bei BFCL bewerten wir Command-R-Reasoning mithilfe der Function-Calling-(FC)-Einstellung. Bei Wettbewerbern geben wir deren Punktzahl aus der offiziellen BFCL-Bestenliste an, sofern verfügbar; andernfalls erstellen wir ein Benchmark unter Verwendung des offiziellen BFCL-Codebases und berichten den höheren Wert aus den Prompt- und FC-Bewertungseinstellungen.
Bei TauBench geben wir den Durchschnitt des pass@1-Werts über 10 Durchläufe für Command-R-Reasoning an. Bei Wettbewerbern verwenden wir, sofern verfügbar, die offiziell gemeldeten Werte (R1-0528, GPT-oss); andernfalls führen wir die Tool-Use-API gegen die offizielle TauBench-Implementierung aus und berichten den Durchschnitt des pass@1-Werts über 10 Durchläufe. In allen Fällen geben wir den Durchschnitt der Bereiche Luftfahrt und Einzelhandel an.
Bei M-TauBench testen wir alle Modelle und berichten den Durchschnittswert über die Sprachen Japanisch, Koreanisch, Arabisch, Spanisch, Französisch und Englisch für sowohl den Einzelhandel als auch die Luftfahrt über 10 Durchläufe.
[2]Unser Deep-Research-Agent ist ein hierarchischer Web-Such-Agent, der ein Problem in mehrere Teilprobleme zerlegt und jedes dieser Probleme rekursiv mit einem Unter-Agenten bearbeitet. Sobald alle Unter-Agenten ihre Arbeit abgeschlossen haben, fassen wir deren Teilberichte zusammen und erstellen einen finalen Bericht, der mehrere Iterationen zur Verfeinerung durchläuft, um eine hohe Qualität des Endergebnisses sicherzustellen. Wir setzen einen intern entwickelten Agenten und eine Web-Suche ein und nutzen dabei unsere Expertise in den Bereichen Retrieval, Reranking, Retrieval-Augmented Generation und Agenten-Technologien. Die RACE-Werte für Wettbewerbsmodelle ermitteln wir, indem wir die offiziellen englischsprachigen Deep-Research-Berichte dieser Modelle auf der DeepResearchBench-Bestenliste mithilfe der offiziellen RACE-Bewertung erneut auswerten.
[3]Die Annotatoren wurden gebeten, ihre Zufriedenheit anhand eines umfassenden, intern entwickelten Bewertungsschemas zu bewerten, das Aspekte wie Antwortqualität, Angemessenheit, Korrektheit und Latenz zusammenfasst. Der gesamte Evaluierungssatz umfasst 112 Fragen; jede Antwort wird von sechs Annotatoren bewertet, bevor die Ergebnisse aggregiert werden.
[4]Diese Evaluierung nutzt einen automatischen Korrektheits-Score unter Verwendung von LlamaIndex im Vergleich zu bekannten, korrekten Referenzantworten.


