Aujourd’hui, nous lançons Command A Reasoning, notre modèle le plus avancé pour les tâches de raisonnement en entreprise. Des flux de travail pilotés par des agents aux systèmes de bout en bout, il surpasse les principaux modèles déployables en interne de sa catégorie, notamment gpt-oss-120b, DeepSeek-R1 0528 et Mistral Magistral Medium.
Command A Reasoning est conçu spécifiquement pour répondre aux besoins des entreprises, offrant des options de déploiement hautement sécurisées, efficaces et évolutives. Pour des déploiements à faible empreinte, il peut fonctionner sur une seule carte H100 ou A100 avec une fenêtre de contexte de 128k. Pour des déploiements optimisés en termes de latence sur deux GPU ou plus, la fenêtre de contexte passe à 256k. Cette flexibilité permet aux organisations de tirer le meilleur parti du matériel dont elles disposent. La grande capacité de contexte du modèle le rend idéal pour les flux de travail riches en documents et les cas d’utilisation complexes impliquant des agents multi-étapes.
Les clients peuvent définir un budget de jetons pour gérer directement l’utilisation des ressources de calcul et maîtriser les coûts. Cela élimine le besoin de maintenir des modèles distincts pour le raisonnement et les autres tâches, car Command A Reasoning peut être utilisé pour des tâches exigeant une précision maximale ou configuré pour une vitesse et un débit accrus lorsque l’efficacité est la priorité principale.
Command A Reasoning est le modèle génératif central qui alimente North, notre plateforme d’IA agentique sécurisée. Cela permet aux organisations de déployer des agents d’IA et des automatisations personnalisés sur site, soutenus par notre modèle de raisonnement le plus performant.
Des performances exceptionnelles pour les tâches de raisonnement en entreprise
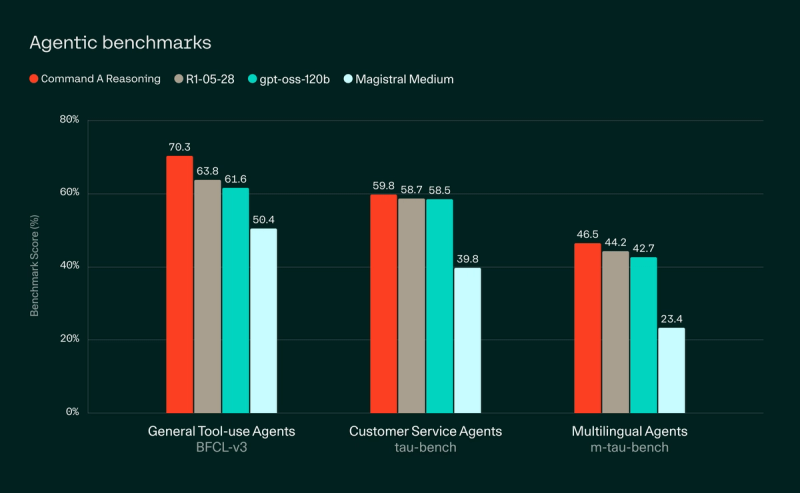
Benchmarks de raisonnement agentique et multilingue
Command A Reasoning offre des résultats de premier plan sur les principaux benchmarks agentiques. Il affiche également d’excellentes performances dans plusieurs langues commerciales essentielles, permettant aux entreprises mondiales de déployer des agents avec une qualité constante.
Agent de recherche approfondie exceptionnel
Command A Reasoning excelle dans la gestion de systèmes de bout en bout impliquant des agents chaînés et hiérarchiques, en exploitant les outils les plus pertinents pour accomplir les tâches. Un excellent exemple est notre système Deep Research, qui surpasse les capacités similaires de tous les autres principaux laboratoires d’IA.
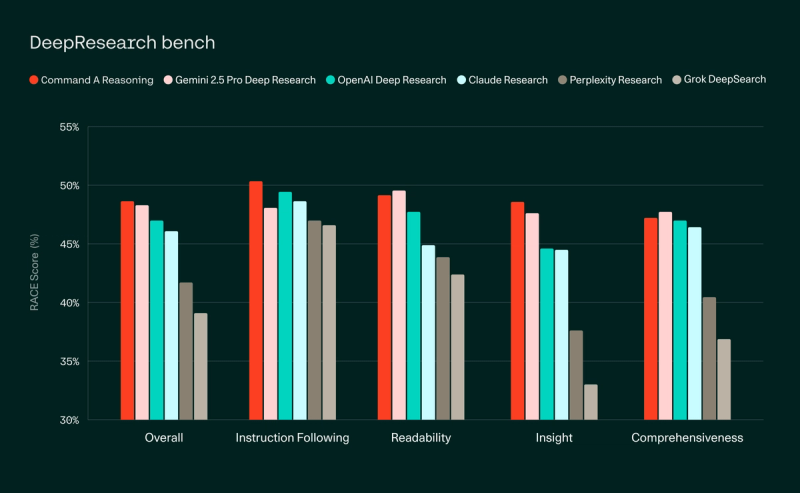
Deep Research est conçu pour répondre aux questions complexes et approfondies qui nécessitent plus qu'une simple recherche rapide. Il génère en quelques minutes des rapports détaillés et étayés par des sources, une tâche qui prendrait normalement plusieurs heures à un employé. Notre système utilise une architecture multi-agents, propulsée par Command A Reasoning, qui décompose la demande de l'utilisateur en plusieurs sujets de recherche. Ensuite, plusieurs agents d'IA travaillent en parallèle pour rechercher et analyser des informations provenant d'une vaste gamme de sources. Enfin, le système consolide les informations vérifiées dans un rapport unique et bien structuré qui répond directement à la demande initiale de l'utilisateur. Deep Research sera bientôt disponible sur North.
Propulsant North, la plateforme d'IA d'entreprise phare de Cohere
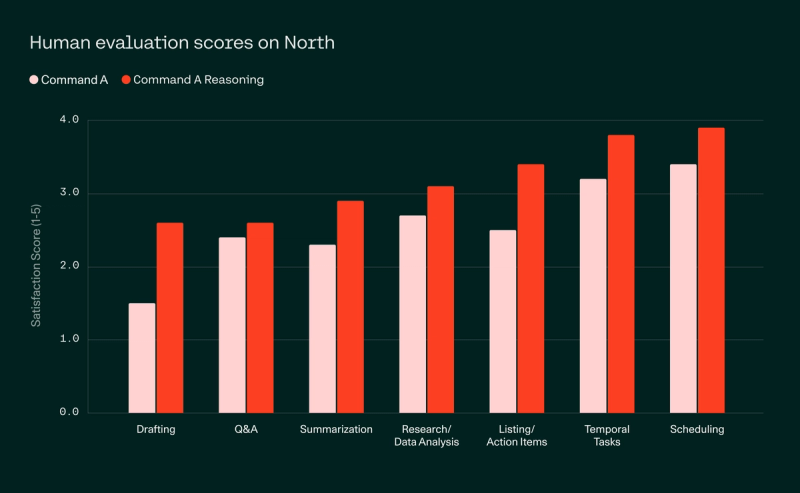
North permet aux entreprises qui accordent une priorité à la sécurité des données de déployer des agents d'IA et des automatisations à grande échelle au sein de leur propre infrastructure. Sur la base des évaluations humaines portant sur un ensemble représentatif de tâches quotidiennes au travail, Command A Reasoning surpasse systématiquement Command A. Pour les clients, ces améliorations se traduisent par des agents plus fiables, une réduction des interventions manuelles et la fourniture de résultats très précis et exploitables.
Contrôle et efficacité requis pour une mise en œuvre à l'échelle de l'entreprise
Command A Reasoning ouvre la voie à des applications professionnelles dans tous les secteurs, alliant performances exceptionnelles, haute précision et efficacité évolutive. Ses faibles exigences matérielles le rendent idéal pour des déploiements privés sur une seule carte H100 ou A100.
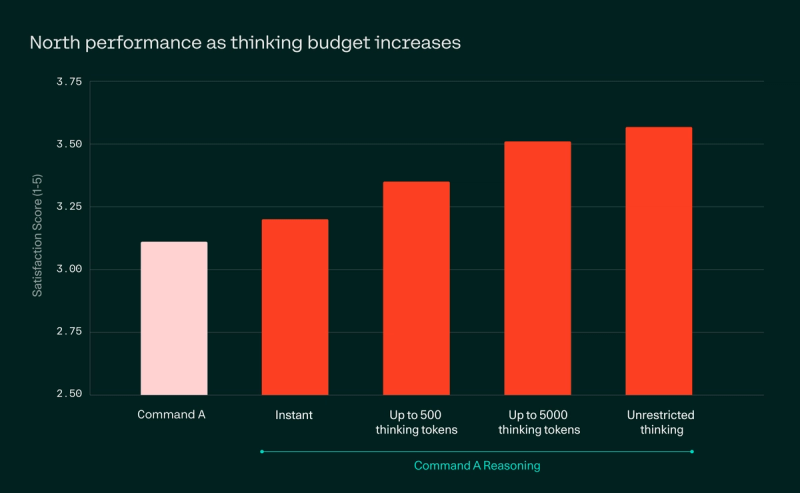
Le modèle optimise l'utilisation des ressources de calcul et les coûts grâce à un budget de jetons contrôlé par l'utilisateur, permettant un ajustement fluide entre la précision indispensable aux missions critiques et les tâches à haut débit. Cela élimine le besoin de disposer de modèles distincts pour le raisonnement et pour les autres tâches, permettant ainsi aux entreprises de maximiser l'efficacité des GPU et d'allouer dynamiquement les ressources.
Dans les évaluations internes de North, l'ajustement du budget de raisonnement montre une progression fluide des performances, allant de réponses efficaces sans raisonnement à des réponses plus approfondies avec des niveaux de raisonnement plus élevés. Même sans raisonnement activé, Command A Reasoning surpasse Command A.
Fiable dans des environnements à haut risque
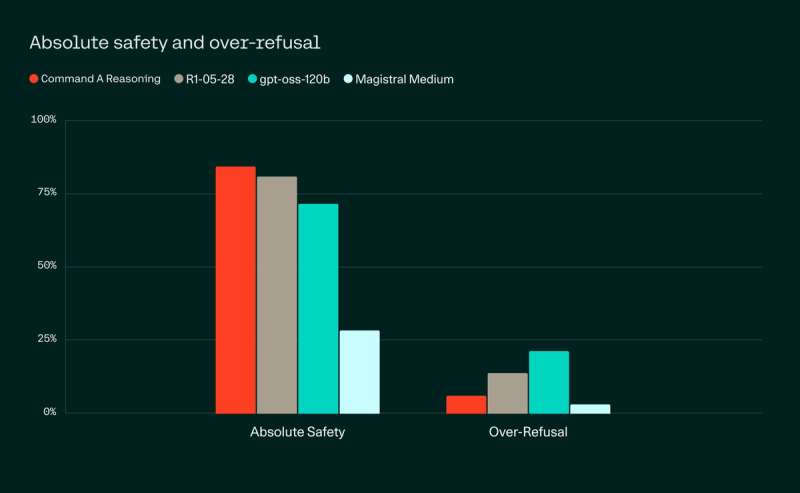
La sécurité est au cœur de notre processus d'entraînement et d'évaluation de tous nos modèles, y compris Command A Reasoning. Cela implique de trouver le meilleur équilibre pour éviter que le modèle ne refuse abusivement des requêtes légitimes, tout en empêchant la diffusion intentionnelle de contenus nuisibles et malveillants en ligne. Nous nous concentrons sur cinq domaines clés : l'exploitation et les abus sexuels sur enfants (CSEA), l'automutilation, la violence et la haine, les contenus sexuels et les théories du complot.
Disponibilité
Command A Reasoning est disponible dès aujourd'hui sur la plateforme Cohere et pour un usage en recherche sur Hugging Face. Si vous êtes intéressé par des déploiements privés ou sur site, veuillez contacter notre équipe commerciale pour obtenir un devis personnalisé.
« Nous sommes ravis de collaborer avec Cohere pour intégrer leur modèle Command A Reasoning à notre hub d'IA générative au sein de la SAP Business Technology Platform. Ce modèle puissant renforcera les capacités d'IA générative de SAP, permettant aux clients, partenaires et développeurs de créer des applications autonomes innovantes et sécurisées, adaptées à leurs environnements spécifiques. Ensemble, nous ouvrons de nouvelles perspectives pour les tâches de raisonnement en entreprise. » — Dr. Walter Sun, SVP et Directeur mondial de l'IA, SAP SE
[1]Nous exécutons tous les modèles avec leur paramètre de raisonnement le plus élevé disponible.
Sur BFCL, nous évaluons Command-R-Reasoning en utilisant le paramètre de fonction d'appel (FC). Pour les modèles concurrents, nous indiquons leur score sur le classement officiel BFCL s'il est disponible, ou nous les évaluons à l'aide du code source officiel de BFCL, en retenant le meilleur résultat entre les paramètres d'évaluation avec prompt et avec FC.
Sur TauBench, nous indiquons la moyenne du score pass@1 sur 10 exécutions pour Command-R-Reasoning. Pour les modèles concurrents, lorsque les données sont disponibles, nous utilisons les chiffres officiellement communiqués (R1-0528, GPT-oss) ; sinon, nous exécutons l'API d'utilisation d'outils sur l'implémentation officielle de TauBench, en indiquant la moyenne pass@1 sur 10 exécutions. Dans tous les cas, nous indiquons la moyenne des secteurs de l'aviation et de la vente au détail.
Sur M-TauBench, nous testons tous les modèles et indiquons le score moyen pour les langues japonaise, coréenne, arabe, espagnole, française et anglaise, pour les secteurs de la vente au détail et de l'aviation, sur 10 exécutions.
[2]Notre agent de recherche approfondie est un agent de recherche web hiérarchique qui décompose un problème en plusieurs sous-problèmes et effectue des recherches récursives sur chacun d'eux à l'aide d'un sous-agent. Une fois que tous les sous-agents ont terminé, nous compilons leurs rapports partiels pour générer un rapport final, en passant par plusieurs étapes d'affinement itératif afin de garantir sa qualité. Nous utilisons un agent et un moteur de recherche web développés en interne, en nous appuyant sur notre expertise en matière de recherche, de réordonnancement, de génération augmentée par recherche et d'agents. Nous indiquons les scores RACE pour les modèles concurrents sur les questions en anglais en réexécutant l'évaluation officielle RACE sur leurs rapports de recherche approfondie en anglais, disponibles sur le site du classement DeepResearchBench.
[3]Les annotateurs ont été invités à évaluer leur niveau de satisfaction selon une grille d'évaluation complète développée en interne, prenant en compte la qualité des réponses, leur pertinence, leur exactitude et leur rapidité d'exécution. L'ensemble du jeu de données d'évaluation comprend 112 questions, et chaque réponse est annotée par 6 annotateurs avant l'agrégation de leurs scores.
[4]Cette évaluation utilise un score d'exactitude automatique basé sur LlamaIndex, comparé à des réponses de référence connues comme étant correctes.