









Heute stellen wir Command A Vision vor, ein neues, hochmodernes generatives Modell, das Unternehmen eine führende Leistung bei multimodalen Vision-Aufgaben bietet und gleichzeitig leistungsstarke Textfunktionen beibehält. Command A Vision ermöglicht es KI-Agenten, Einblicke in die internen Unternehmensabläufe zu gewinnen, und eröffnet so die Automatisierung mühsamer Aufgaben, die visuelle Daten wie Folien, Diagramme, PDFs und Fotos nutzen. Ob es darum geht, Produktanleitungen zu interpretieren oder reale Szenen zur Risikodetektion zu analysieren – das Modell ist bestens geeignet, um die anspruchsvollsten Vision-Herausforderungen in Unternehmen zu bewältigen.
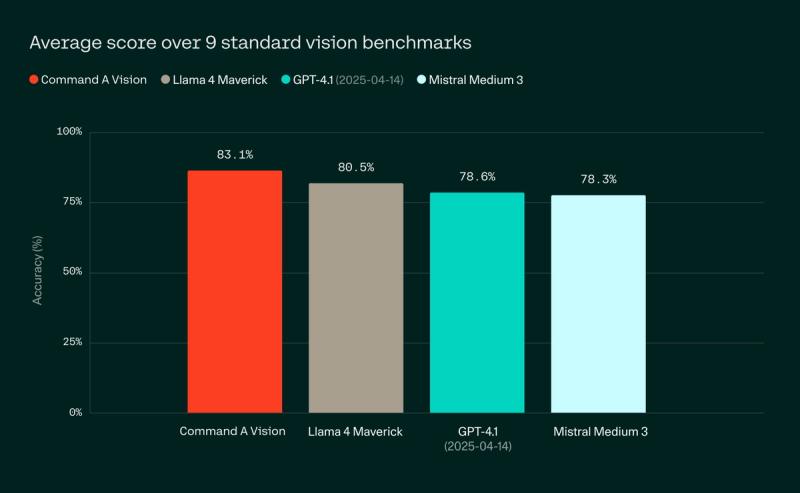
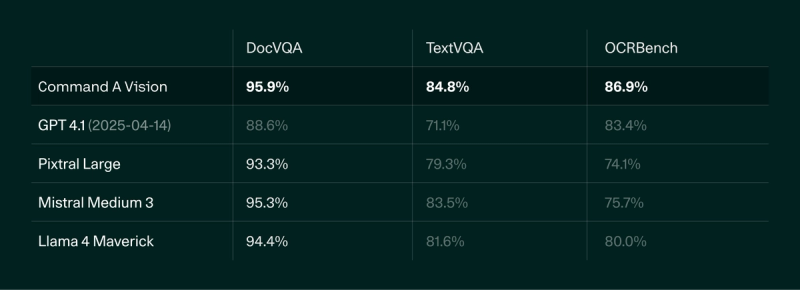
Es übertrifft andere Modelle seiner Klasse, darunter GPT-4.1, Llama 4 Maverick, Mistral Medium 3 (und Pixtral Large), in wichtigen multimodalen Benchmarks. Command A Vision stellt die Bedürfnisse von Unternehmen in den Vordergrund und bietet hochgradig sichere, effiziente und flexible Bereitstellungsoptionen. Der geringe Ressourcenbedarf ermöglicht eine nahtlose On-Premise- oder private Bereitstellung mit zwei oder weniger GPUs und gewährleistet so eine für den Unternehmenseinsatz geeignete Skalierbarkeit.
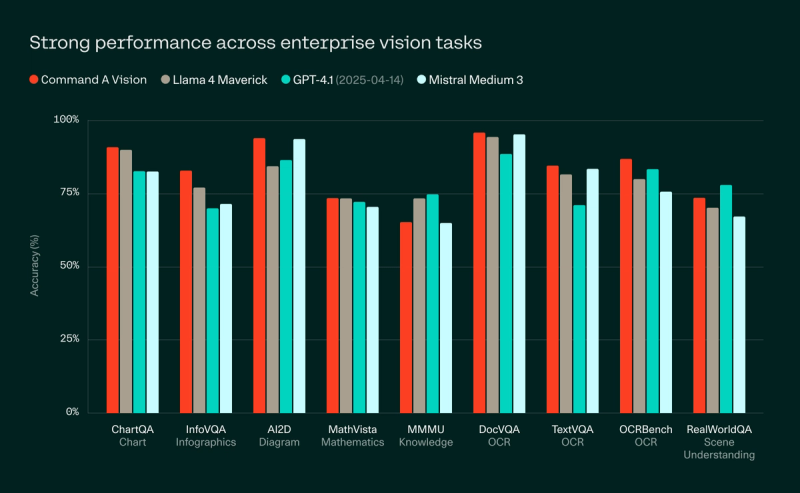
Hervorragende Leistung bei Vision-Aufgaben in Unternehmen
Analyse von Diagrammen, Grafiken und Schaubildern
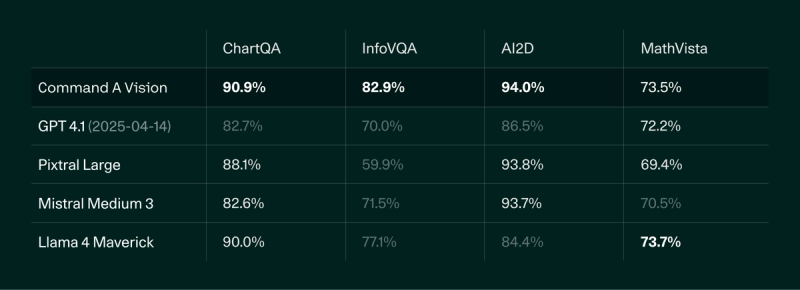
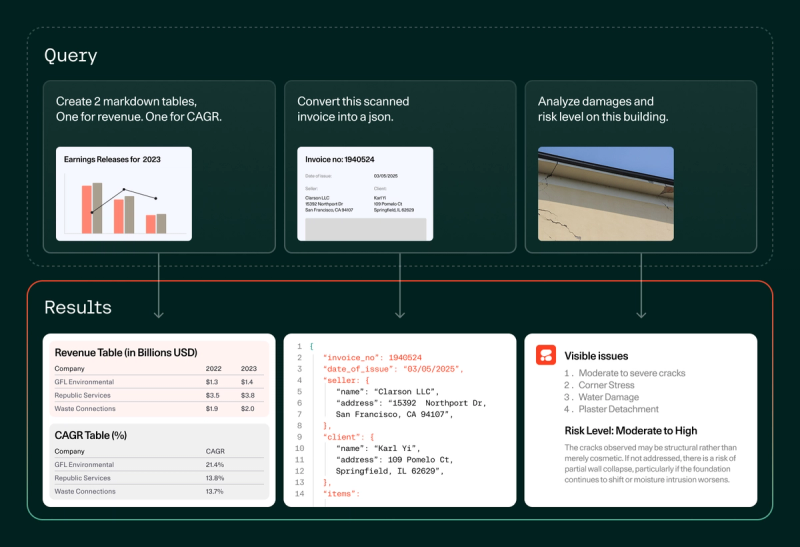
Command A Vision zeichnet sich durch das Verständnis und die Analyse einer breiten Palette visueller und mehrsprachiger Daten aus, darunter Diagramme, Grafiken, Tabellen und Schaubilder. Das Modell extrahiert Daten präzise aus verschiedenen visuellen Formaten, wendet domänenspezifisches Wissen in Branchen wie Finanzwesen, Gesundheitswesen, Fertigung, Bauwesen und Energie an und führt komplexe Analysen auf Basis der extrahierten Informationen durch.
Dokumenten-OCR und visuelle Verarbeitung
Command A Vision besticht durch seine Fähigkeiten im Bereich Dokumenten-OCR und visuelle Verarbeitung, indem es Text und Informationen präzise aus verschiedenen Dokumententypen extrahiert, darunter gescannte Dokumente, Rechnungen und Formulare. Das Modell geht über die einfache Texterkennung hinaus, versteht das Layout und die Struktur von Dokumenten und extrahiert so aussagekräftige Daten. Diese Fähigkeit, kombiniert mit unserer Unterstützung für strukturierte Datenausgabe im JSON-Modus, ermöglicht es Command A Vision, repetitive Dokumentenverarbeitungsprozesse zu automatisieren, die Datenqualität zu verbessern, Workflows zu optimieren und eine nahtlose Integration in bestehende Systeme zu gewährleisten – ein unverzichtbares Tool für Unternehmen, die große Dokumentenmengen verarbeiten. Es erreicht Spitzenleistungen in den Benchmarks DocVQA, TextVQA und OCRBench.
Verständnis realer Szenen
Die Fähigkeiten von Command A Vision erstrecken sich auf das Verständnis realer Szenen, sodass es komplexe visuelle Umgebungen analysieren und interpretieren kann. Dies geht über die einfache Objekterkennung hinaus, da das Modell räumliche Beziehungen, den Kontext und sogar subtile Nuancen in Bildern und Fotografien erfassen kann. Damit ist es ideal für eine Vielzahl realer Anwendungen geeignet, etwa zur Risikodetektion in industriellen Umgebungen und für Retail-Analysen.
Funktionen und Effizienz, die den Anforderungen großer Unternehmen gerecht werden
Command A Vision wurde entwickelt, um Unternehmen genau die Funktionen zu bieten, die für sie am wichtigsten sind. Es vereint die weiteren wichtigen Textfunktionen von Command A, wie die fortschrittliche Retrieval-Augmented Generation (RAG) mit Quellenangaben, sowie eine mehrsprachige Leistung in mehreren wichtigen Geschäftsprachen.
Mit Command A Vision können Unternehmen schnell und sicher kontextbezogene Erkenntnisse und Analysen zu ihren eigenen Daten abrufen – sei es in Textform oder in verschiedenen gängigen Bildformaten für Unternehmen. Dies funktioniert auf der vorhandenen Hardware und in den benötigten Sprachen. Unsere Command-Modellreihe ist gezielt auf die Anforderungen von Unternehmen zugeschnitten und besticht durch exzellente Leistungen bei komplexen Business-Anwendungen, wobei sie Performance, Genauigkeit und Effizienz optimal vereint.
Dank geringer Hardware-Anforderungen können Unternehmen in regulierten Branchen, die eine private Bereitstellung benötigen, Command A Vision effizient im produktiven Einsatz nutzen. Command A Vision lässt sich mit nur zwei oder weniger GPUs privat bereitstellen. Es benötigt lediglich zwei A100s oder eine H100 für die 4-Bit-Quantisierung.
Das sagen unsere Kunden
„Wir sind unglaublich begeistert von der Veröffentlichung von Command A Vision. Diese Modelle erweitern die Möglichkeiten generativer KI erheblich und ermöglichen es uns, über den Textbereich hinaus in die Welt des visuellen Verständnisses vorzudringen. Bereits jetzt haben wir gesehen, wie Command A Vision einige unserer komplexesten und zeitaufwendigsten Herausforderungen löst; es optimiert nicht nur Arbeitsabläufe, sondern eröffnet auch völlig neue Möglichkeiten für generative KI. Durch die Integration visueller Kontexte in unsere KI-Systeme können wir Lösungen entwickeln, die auf dem basieren, was wir sehen können, und nicht nur auf dem, was wir lesen können. Ich bin gespannt, wie weit wir diese Technologie vorantreiben können und welche Erfolge wir damit erzielen werden.“ – Jeffrey English, Director, Professional Services, Fujitsu Intelligence
„Während der ersten Tests hat das Command A Vision-Modell außergewöhnliche Fähigkeiten beim Verständnis und der Extraktion von Daten aus komplexen Dokumenten der Baubranche bewiesen, wie etwa Verzichtserklärungen, Rechnungen und Bauplänen. Die Möglichkeit, diese Art der KI-gestützten Datenerfassung zu automatisieren, hat das Potenzial, die Dokumentenverarbeitung, die Datenqualität und das Projektmanagement zu revolutionieren, was Risiken, Zeitaufwand und Kosten in der Baubranche reduzieren könnte.“ – Mark Webster, Senior Vice President und General Manager, Oracle Infrastructure Industries
Verfügbarkeit
Command A Vision ist ab sofort auf der Cohere-Plattform verfügbar und für Forschungszwecke auf Hugging Face zugänglich. Wenn Sie an privaten oder On-Premise-Bereitstellungen interessiert sind, wenden Sie sich bitte an unser Vertriebsteam für individuelle Preisangebote.
[1]Wir vergleichen uns mit den besten verfügbaren Modellen ohne Reasoning-Fähigkeiten (nicht veraltete Versionen), die von anderen Anbietern bereitgestellt werden. Soweit verfügbar, stammen die Benchmark-Werte entweder aus Berichten der jeweiligen Anbieter oder aus öffentlich zugänglichen Bestenlisten; andernfalls (grau hinterlegte Zahlen) basieren sie auf internen Evaluierungen nach bestem Bemühen, die entweder über VLMEvalKit oder den offiziellen Code-Bestand durchgeführt wurden.


