









Heute stellen wir Command A vor, ein neues, hochmodernes generatives Modell, das speziell für anspruchsvolle Unternehmen entwickelt wurde, die eine schnelle, sichere und hochwertige KI benötigen. Im Vergleich zu führenden proprietären Modellen und Modellen mit offenen Gewichten, wie GPT-4o und DeepSeek-V3, bietet Command A maximale Leistung bei minimalen Hardwarekosten. Bei privaten Bereitstellungen überzeugt Command A insbesondere bei geschäftskritischen agentischen und mehrsprachigen Aufgaben und kann dabei mit nur zwei GPUs betrieben werden, während andere Modelle üblicherweise bis zu 32 GPUs erfordern.
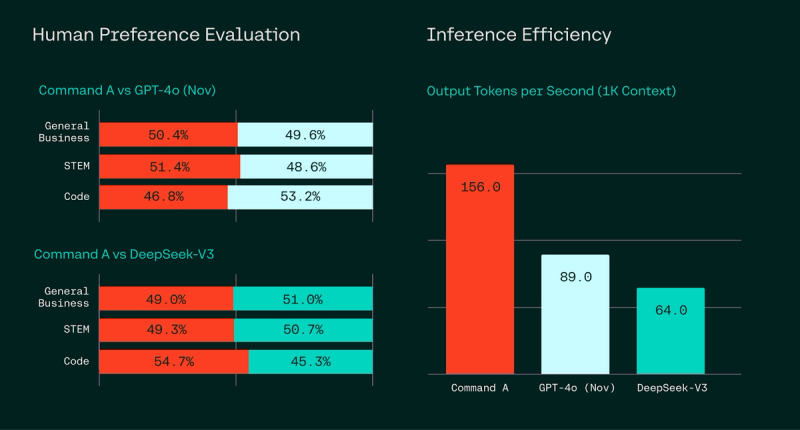
In direkten menschlichen Bewertungen bei geschäftlichen, MINT- und Programmieraufgaben erreicht Command A das Niveau seiner größeren und langsameren Wettbewerber oder übertrifft diese sogar – und bietet gleichzeitig eine höhere Durchsatzrate sowie gesteigerte Effizienz. Menschliche Bewertungen sind entscheidend, da sie auf realen Unternehmensdaten und -szenarien basieren.
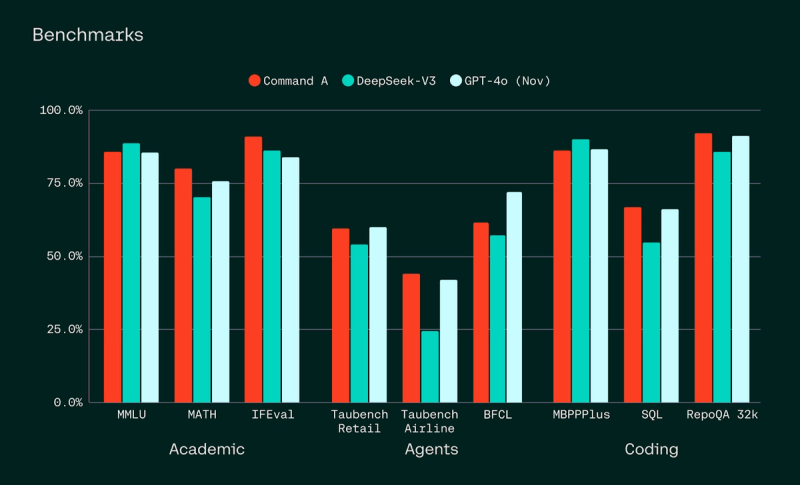
In einer Reihe gängiger Benchmarks liefert Command A starke Leistungen bei der Befolgung von Anweisungen sowie bei SQL-, agentischen und Tool-Aufgaben.
Skalierbare Effizienz
Unser Ziel war es, Command A so effizient wie möglich zu entwickeln und gleichzeitig den Betrieb in der Produktion so ressourcenschonend wie möglich zu gestalten. Mit einem Hardware-Footprint von nur zwei A100- oder H100-GPUs benötigt es deutlich weniger Rechenleistung als andere vergleichbare Modelle auf dem Markt. Dies ist besonders wichtig für private Bereitstellungen.
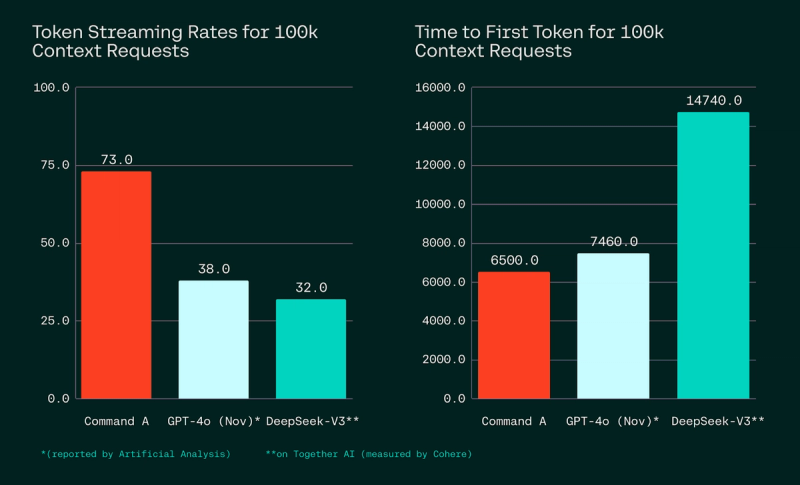
Übermäßig große Modelle führen zu schlechter Latenz. Wenn es Ihnen darum geht, schnell korrekte Antworten zu erhalten, ist Command A die beste Wahl. Tatsächlich kann Command A Token mit einer Rate von bis zu 156 Token/Sekunde generieren, was 1,75-mal schneller ist als bei GPT-4o und 2,4-mal schneller als bei DeepSeek-V3. Private Bereitstellungen von Command A können bis zu 50 % kostengünstiger sein als der Zugriff über eine API.
Funktionen für den Unternehmenseinsatz
Wir haben Command A unter Berücksichtigung geschäftlicher Anforderungen entwickelt. Die Kontextlänge von 256k (doppelt so hoch wie bei den meisten führenden Modellen) ermöglicht die Verarbeitung deutlich längerer Unternehmensdokumente. Zu den weiteren Hauptmerkmalen gehören Cohere’s fortschrittliche RAG-Technologie (Retrieval-Augmented Generation) mit verifizierbaren Quellenangaben, die Nutzung agentischer Tools, Sicherheit auf Enterprise-Niveau sowie eine starke mehrsprachige Performance.
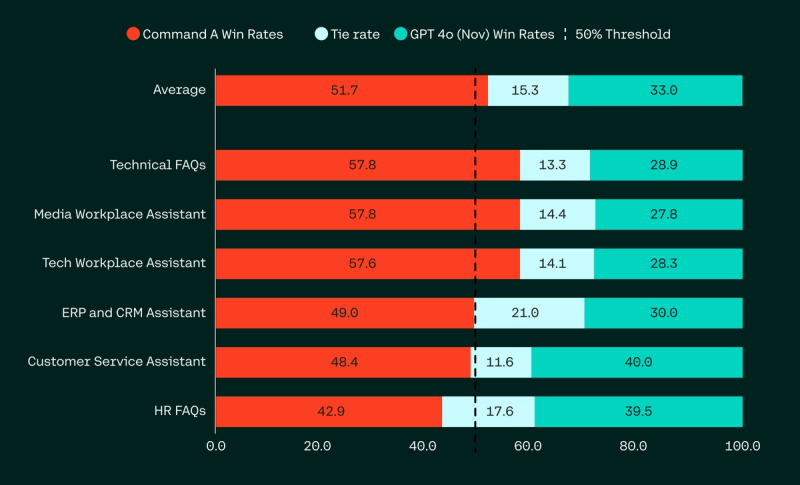
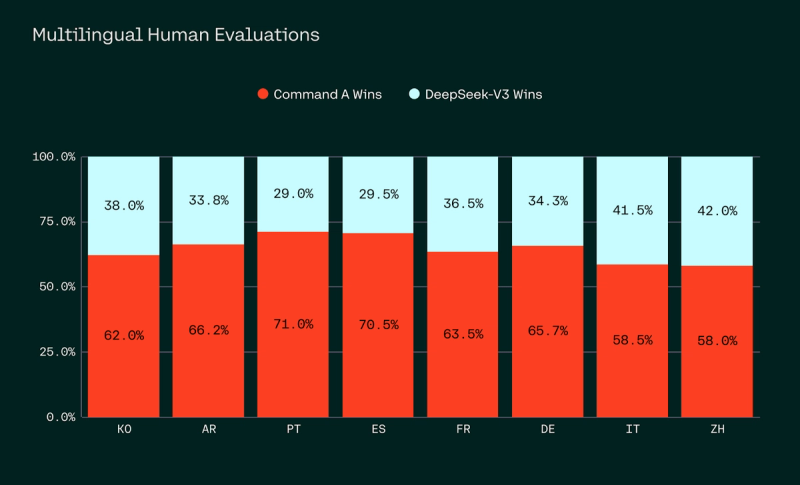
Wir wissen, dass globale Unternehmen Funktionen in verschiedenen Regionen benötigen. Command A bietet eine erweiterte Unterstützung auf Enterprise-Niveau für die 23 Sprachen, die von der Mehrheit der Weltbevölkerung gesprochen werden. Wir haben eine umfangreiche menschliche Bewertung durchgeführt und festgestellt, dass Nutzer Command A in den meisten Sprachen bei einer Reihe von geschäftlichen Anwendungsfällen deutlich gegenüber DeepSeek-V3 bevorzugten.
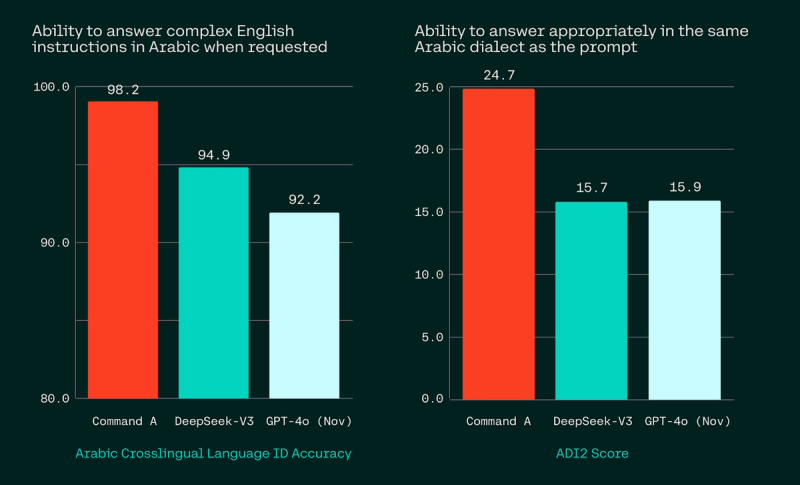
Insbesondere ist Command A deutlich besser als GPT-4o oder DeepSeek-V3 darin, konsistent Antworten in der angeforderten Sprache zu liefern – beispielsweise in dem für den Nutzer relevanten arabischen Dialekt.
Skalierbare Unterstützung für KI-Agenten
KI ist nur so gut wie die Daten, die ihr zur Verfügung gestellt werden. Vor diesem Hintergrund liefert Command A sichere und präzise Antworten auf Fragen, die auf Ihren internen Unternehmensinformationen basieren. In der Praxis nutzen Kunden dies für Aufgaben wie das Auffinden relevanter HR-Richtlinien nach Standort, die Prüfung rechtlicher Vorschriften oder die Analyse umfangreicher Finanzberichte.
Die nächste Generation der Cohere-Modelle wird eine Vielzahl von KI-Anwendungen für Kunden in Branchen wie Finanzwesen, Gesundheitswesen, Fertigung, Energie und dem öffentlichen Sektor unterstützen. Insbesondere werden sie nahtlos in North integriert – unsere sichere Plattform für KI-Agenten, die das volle Potenzial Ihrer Unternehmensdaten und Ihrer Mitarbeiter durch KI-Agenten ausschöpft. Unser vollständig integrierter Technologie-Stack ermöglicht eine umfassende Anpassung des Produkts an die spezifischen Geschäftsanforderungen der Kunden.
North nutzt sicher Unternehmens-Tools wie CRM- und ERP-Software und verbindet sich zudem mit internen Unternehmensdatenbanken sowie externen Web-Suchdiensten. So können Sie Agenten entwickeln, die innerhalb der geschützten Firewalls Ihrer Unternehmenssysteme autonom für Sie handeln.
Verfügbarkeit
Command A ist ab sofort auf der Cohere-Plattform verfügbar, für Forschungszwecke auf Hugging Face zugänglich und wird bald bei großen Cloud-Anbietern verfügbar sein. Wenn Sie an privaten oder On-Premise-Bereitstellungen interessiert sind, kontaktieren Sie bitte unser Vertriebsteam.
[1]BFCL: Leistung im BFCL-v3-Benchmark vom 12. März 2025. Soweit verfügbar, wurden die Werte der öffentlichen Bestenliste entnommen; andernfalls erfolgte eine interne Auswertung nach bestem Bemühen auf Basis des offiziellen Code-Repositorys. Bei Wettbewerbern wird der jeweils höhere Wert aus den Kategorien „prompted“ oder „function-calling“ des BFCL herangezogen. Berichtet wird über den Gesamtwert, der den Einsatz von Tools in vielfältigen, realen Umgebungen testet.
Taubench: Leistung im Taubench-Benchmark. Soweit verfügbar, wurden die Werte der öffentlichen Bestenliste des Repositorys entnommen; andernfalls erfolgte eine interne Auswertung nach bestem Bemühen auf Basis des offiziellen Code-Repositorys. Berichtet wird über die pass@1-Werte für die Aufgabenbereiche Retail und Airline, die den Einsatz von Tool-Agenten in mehrstufigen Kundensupport-Szenarien bewerten.
Akademisch: Leistung in akademischen Benchmarks, die allgemeines Wissen (MMLU), mathematische Fähigkeiten (MATH) und die Befolgung von Anweisungen (IFEval) abdecken. Dabei zeigt sich, dass Command-A in etwa das Leistungsniveau von GPT-4o und DeepSeek-V3 erreicht oder sogar übertrifft.
Programmierung: Command-A weist eine besonders starke Leistung bei SQL-Benchmarks auf (Durchschnitt aus BirdBench, Spider Dev und Spider Test) und erreicht bei den Anwendungsfällen von MBPPlus (Python-Programmierung) das Niveau von GPT-4o. Abschließend ist die überlegene Leistung bei der Beantwortung von Fragen auf Repository-Ebene in längeren Kontexten (RepoQA) hervorzuheben.


