









KI-Modelle mit offenen Gewichten, die für reale Sprachen entwickelt wurden: leistungsstark, anpassungsfähig und effizient genug, um lokal ausgeführt zu werden – sogar auf einem Smartphone.
Heute stellt Cohere Labs, die Forschungsabteilung von Cohere, Tiny Aya vor – das leistungsfähigste mehrsprachige Modell mit offenen Gewichten in dieser Größenklasse. Tiny Aya bietet erstklassige Übersetzungsqualität, ein starkes multilinguales Sprachverständnis, hochwertige Antworten in der Zielsprache und eine breite Sprachabdeckung in einem Modell, das klein genug ist, um lokal ausgeführt zu werden – selbst auf Consumer-Hardware und Mobiltelefonen. Es gibt keine Hürden für Experimente; es steht lediglich eine leistungsstarke Modellfamilie zur Verfügung, die überall eingesetzt werden kann.
Mehrsprachige KI hat rasante Fortschritte gemacht, doch Leistung und Benutzerfreundlichkeit konzentrieren sich nach wie vor auf eine kleine Gruppe dominanter Sprachen und eine großskalige Infrastruktur. Tiny Aya verfolgt einen anderen Ansatz: Die Kombination aus effizientem Design und tiefgehender multilingualer Forschung ermöglicht eine ausgewogene Leistung über verschiedene Sprachen hinweg und bleibt dabei praktisch in der Bereitstellung und Anpassung. Anstatt einer oberflächlichen Abdeckung hunderter Sprachen legt Tiny Aya den Fokus auf eine fundierte mehrsprachige Tiefe, die Forschenden, Entwicklern und Communities ermöglicht, KI-Systeme zu entwickeln, die ihre eigenen sprachlichen und kulturellen Kontexte widerspiegeln.
Was wir veröffentlichen
TinyAya-Base, ein vortrainiertes Modell mit 3,35 Milliarden Parametern:TinyAya-Base deckt über 70 Sprachen* ab, darunter viele Sprachen mit geringeren Ressourcen aus aller Welt.
TinyAya-Global, ein leistungsstarkes, instruktionsoptimiertes mehrsprachiges Modell:Auf Basis von TinyAya-Base bietet TinyAya-Global eine starke und ausgewogene Leistung in 67 unterstützten Sprachen. Es dient als Standardlösung für echte Mehrsprachigkeit und ist ideal für Anwendungen, die eine konsistente Qualität in verschiedenen sprachlichen Umgebungen innerhalb einer einzigen Bereitstellung erfordern.
Eine Familie spezialisierter, instruktionsoptimierter Modelle: Neben TinyAya-Global führen wir spezialisierte Varianten ein, die die Leistung in bestimmten Sprachregionen vertiefen und gleichzeitig eine starke allgemeine Mehrsprachigkeit beibehalten. Diese Struktur kombiniert gemeinsames sprachenübergreifendes Lernen mit gezielter regionaler Tiefe und bietet Forschenden sowie Entwicklern Flexibilität bei der Bereitstellung mehrsprachiger KI (Details zu den Modellvarianten und regionalen Spezialisierungen werden weiter unten beschrieben).
Ein neuer, massiv mehrsprachiger Datensatz zur Feinabstimmung sowie entsprechende Benchmarks:Diese Ressourcen decken verschiedene Domänen, Sprachen und Aufgaben ab und bilden die Grundlage für systematische mehrsprachige Experimente, wodurch eine reproduzierbare Evaluierung sowie die kontinuierliche Erforschung datenzentrierter Trainingsstrategien ermöglicht werden.
Ein detaillierter technischer Bericht:Hier teilen wir die Forschungsergebnisse, die Trainingsstrategie und die Erkenntnisse aus der Evaluierung hinter Tiny Aya.
Tiny Aya markiert einen Paradigmenwechsel in der Art und Weise, wie wir den Aufbau und die gemeinsame Nutzung multilingualer Systeme betrachten. Durch ein effizientes Design, fundierte Forschung im Bereich des multilingualen Pre-Trainings und Post-Trainings sowie einen von Grund auf auf sprachliche Vielfalt ausgerichteten Ansatz bringt Tiny Aya hochwertige KI näher an die Menschen, die sie am dringendsten benötigen: Forscher, die an unterrepräsentierten Sprachen arbeiten, Entwickler, die lokal agieren, und Gemeinschaften, die Technologie nach ihren eigenen Vorstellungen gestalten. So könnte beispielsweise ein universitäres Labor in Indien Tiny Aya als Offline-Übersetzungstool oder für die KI-Ausbildung in Klassenzimmern und Gemeinschaftseinrichtungen einsetzen, ohne auf Cloud-APIs angewiesen zu sein.
Technologische Innovationen
Tiny Aya basiert auf mehreren Jahren Forschung im Rahmen der Aya-Initiative zur Frage, wie multilinguale Modelle verantwortungsvoll skaliert werden können. Insbesondere baut der Trainingsansatz auf unserer aktuellen Forschung zu der Steigerung der sprachlichen Plastizität durch Tokenisierung, der verbesserten Naturalisierung synthetischer Daten, der intelligenten Kombination verschiedener Generierungsergebnisse sowie der gezielten Auswahl von Merge-Methoden auf. Zusammen ermöglichen diese Methoden die Kombination multilingualer Signale unter Beibehaltung sprachlicher Nuancen und der Stärkung sprachspezifischer Strukturen.
Ein weiteres zentrales Designprinzip von Tiny Aya war die Effizienz innerhalb realistischer Rechenkapazitätsbudgets. Durch die Durchführung des Post-Trainings auf einem einzigen Cluster mit 64 NVIDIA H100 GPUs zeigen wir, dass ein durchdachtes Design multilingualer Daten und eine gezielte Trainingsstrategie den massiven Einsatz von Rechenressourcen ersetzen können. Diese Konzepte prägten Tiny Aya von Grund auf und beeinflussten das Design des Tokenizers, die Datenzusammensetzung sowie die Herangehensweise an die Spezialisierung innerhalb verschiedener Sprachcluster.
Tiny Aya geht über die reine Mehrsprachigkeit als einheitliches Ziel hinaus und integriert Strategien, die die Vielfalt während des Trainings bewahren und gleichzeitig eine effiziente Anpassung für spezifische Anwendungsfälle ermöglichen. Dieses Design erlaubt es Forschern, das Modell flexibel anzupassen, ohne gegen starre Ausrichtungsvorgaben oder übermäßig spezialisierte Post-Training-Phasen ankämpfen zu müssen. Dadurch wird das Fine-Tuning für neue Domänen, aufstrebende Sprachen oder community-basierte Evaluierungsrahmen deutlich vereinfacht.
Kompakte Modelle, starke Leistung
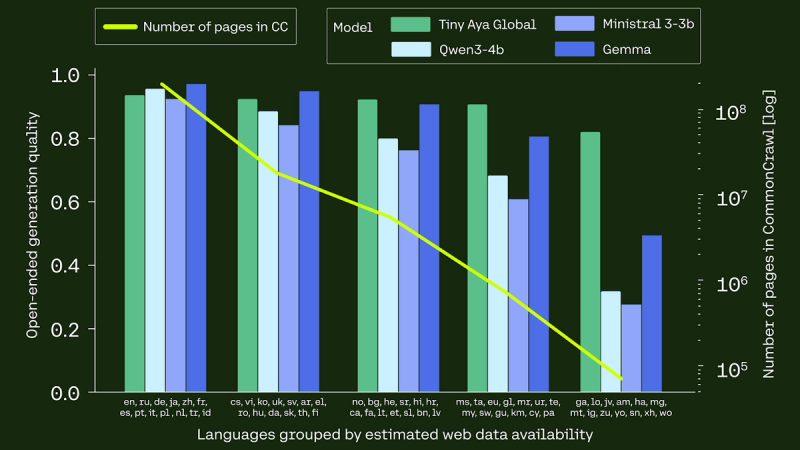
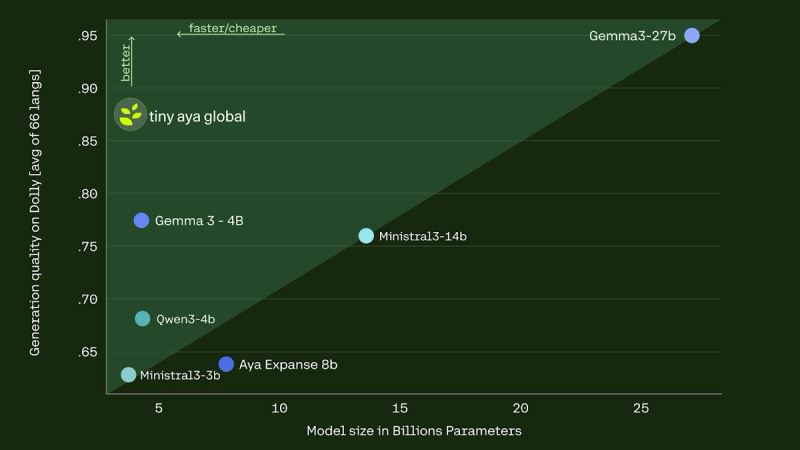
Bei der Entwicklung von Tiny Aya hatten wir ein übergeordnetes Ziel vor Augen: Modelle zu schaffen, die über viele Sprachen hinweg zuverlässig funktionieren und gleichzeitig effizient genug für den lokalen Einsatz sind. Das Ergebnis ist eine Modellfamilie, die in verschiedenen Benchmarks mit bestehenden mehrsprachigen Modellen mithalten kann – insbesondere bei Aufgaben wie Übersetzung, der Qualität der freien Textgenerierung und mathematischem Schlussfolgern in Sprachen mit geringeren Ressourcen.
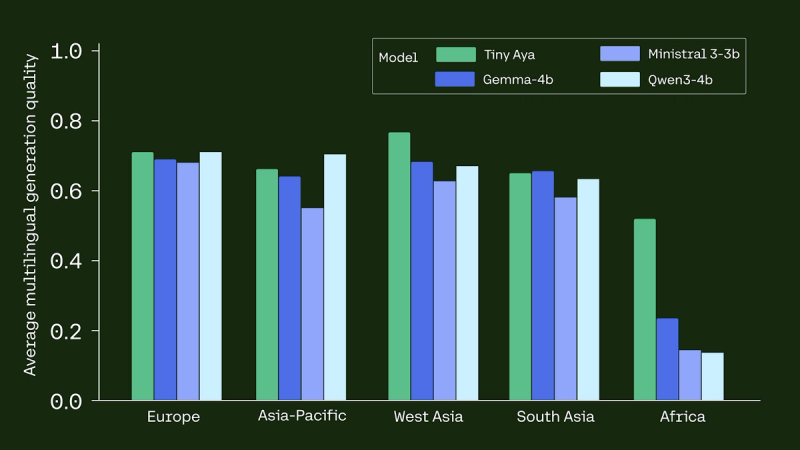
In einem umfassenden Benchmark-Szenario für mehrsprachige generative KI-Modelle kann Tiny Aya mit führenden Modellen dieser Größenordnung mithalten und erzielt in allen Regionen Leistungssteigerungen. Besonders hervorzuheben ist die Konsistenz, die Tiny Aya in verschiedenen sprachlichen Kontexten beibehält. Anstatt uns auf eine kleine Auswahl an Top-Werten zu konzentrieren, lag unser Fokus auf Stabilität, Breite und praktischer Anwendbarkeit. Uns war das „Wie“ genauso wichtig wie das „Was“ – das heißt, wir haben Qualitätsfaktoren berücksichtigt, die Muttersprachlern wichtig sind, insbesondere im Hinblick auf die Flüssigkeit und Kohärenz einer Antwort. In realen mehrsprachigen Szenarien, in denen Effizienz, Anpassungsfähigkeit und Sprachabdeckung ebenso entscheidend sind wie die reine Modellgröße, ist Tiny Aya führend und bietet eine überzeugende Balance zwischen Leistungsfähigkeit und Zugänglichkeit.
Zugänglichkeit als Designprinzip
Tiny Aya ist darauf ausgelegt, dort eingesetzt zu werden, wo Menschen arbeiten: auf lokalen Geräten, in Klassenzimmern, in Gemeinschaftslaboren und in Regionen, in denen eine großskalige Infrastruktur nicht immer verfügbar ist – zum Beispiel für Übersetzungen zwischen Sprachen in einem abgelegenen Dorf, weit entfernt von Cloud-Infrastrukturen. Durch die Senkung der Einstiegshürden können mehr Menschen selbst Modelle entwickeln, experimentieren und die Zukunft der mehrsprachigen KI mitgestalten.
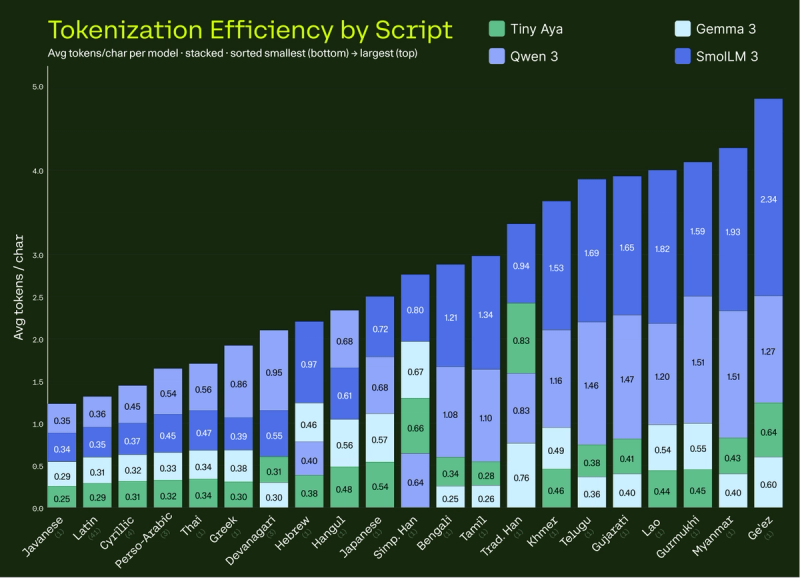
Neben der Modellgröße hängt die Zugänglichkeit auch davon ab, wie effizient Sprache dargestellt wird. Der Tokenizer von Tiny Aya wurde entwickelt, um die Fragmentierung über verschiedene Schriftsysteme und sprachliche Strukturen hinweg zu reduzieren und so weniger Token pro Satz über alle Sprachen hinweg zu erzeugen. Diese verbesserte Tokenisierungseffizienz senkt den Speicher- und Rechenbedarf während der Inferenz, was mehrsprachige Anwendungen auf lokaler Hardware praktikabler macht und gleichzeitig die Reaktionsfähigkeit im praktischen Einsatz verbessert.
Wir betrachten diese Veröffentlichung als Grundlage für ein breiteres Ökosystem spezialisierter mehrsprachiger Modelle, die von der Forschungsgemeinschaft selbst entwickelt werden. Wir laden Forscher und Entwickler weltweit ein, diese Modelle und Datensätze zu nutzen, um eigene sprachorientierte Systeme zu erstellen, die Sprachabdeckung zu erweitern, neue Evaluierungsstrategien zu erforschen und die mehrsprachige KI in Richtungen zu lenken, die wir allein nicht vorhersehen können. Die Zukunft der mehrsprachigen KI wird nicht durch ein einziges riesiges Modell geprägt sein, sondern durch ein lebendiges Ökosystem vieler Modelle, die von vielen Stimmen mitgestaltet werden.
Eine Familie spezialisierter Modelle
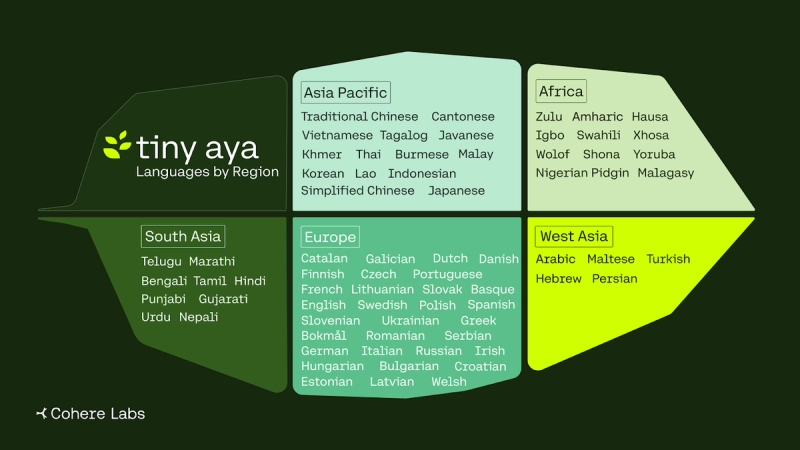
Tiny Aya basiert auf einer gemeinsamen mehrsprachigen Grundlage, die das Lernen über Sprachgrenzen hinweg in über 70 Sprachen ermöglicht. Auf dieser Basis haben wir untersucht, wie die Leistung innerhalb spezifischer Sprachökosysteme verbessert werden kann, ohne die allgemeine mehrsprachige Funktionalität einzuschränken.
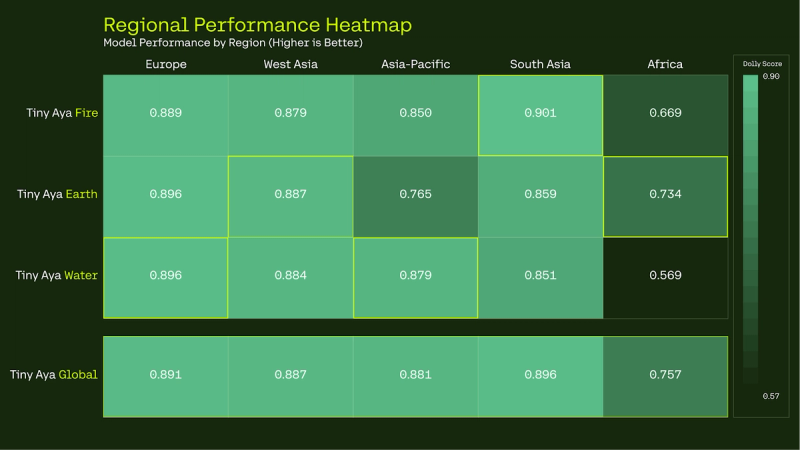
TinyAya-base bietet eine konsistente, mehrsprachige Basis für verschiedene Regionen. Die spezialisierten Varianten erweitern diese Basis, indem sie sich stärker auf bestimmte Sprachgemeinschaften konzentrieren – insbesondere in Afrika, Südasien und der Asien-Pazifik-Region –, ohne dabei ihre hohe Leistungsfähigkeit außerhalb ihrer Hauptregion zu verlieren.
Dieser Ansatz ermöglicht es jedem Modell, eine fundiertere sprachliche Basis und kulturelle Nuancen zu entwickeln, wodurch Systeme entstehen, die für die Zielgemeinschaften natürlicher und zuverlässiger wirken. Gleichzeitig behalten alle Tiny-Aya-Modelle eine breite mehrsprachige Abdeckung bei, was sie zu flexiblen Ausgangspunkten für weitere Anpassungen und Forschung macht.
Das Ergebnis ist eine koordinierte Modellfamilie mit regional spezialisierten Varianten:
- TinyAya-Earth: Besonders leistungsstark für Sprachen in Afrika und Westasien.
- TinyAya-Fire: Besonders leistungsstark für Sprachen in Südasien.
- TinyAya-Water: Besonders leistungsstark für die Asien-Pazifik-Region und Europa.
Zusammen bieten diese Modelle sowohl eine global ausbalancierte Option als auch regional fokussierte Varianten, sodass Forscher und Entwickler die passende Abdeckung für ihre Anwendungsfälle wählen können.
Testen Sie Tiny Aya jetzt.
Tiny Aya ist ab sofort als Open-Weights-Modell verfügbar. Sie können die Tiny-Aya-Modellfamilie auf verschiedene Weise erkunden und nutzen:
- Testen Sie es sofort auf Hugging Face Spacee oder auf der Cohere-Plattform.
- Laden Sie die Modellgewichte auf Hugging Face und Kaggle für lokale Bereitstellung und Forschungszwecke herunter.
- Erfahren Sie mehr in unserem detaillierten technischen Bericht, der die Trainingsstrategie, umfassende Evaluierungen und Designentscheidungen hinter Tiny Aya beschreibt.
- Bereit, mit Tiny Aya zu entwickeln? Erfahren Sie mehr über Expedition Tiny Aya– eine mehrstufige, mentorbegleitete Forschungsinitiative, die darauf ausgelegt ist, neue Projekte auf Basis der Tiny-Aya-Modellfamilie voranzutreiben.
*TinyAya-Base unterstützt über 70 Sprachen, darunter: Amharisch, Arabisch, Baskisch, Bengalisch, Bulgarisch, Birmanisch, Kantonesisch, Katalanisch, Chinesisch (vereinfacht und traditionell), Kroatisch, Tschechisch, Dänisch, Niederländisch, Englisch, Estnisch, Finnisch, Französisch, Galicisch, Deutsch, Griechisch, Gujarati, Hausa, Hebräisch, Hindi, Ungarisch, Igbo, Indonesisch, Irisch, Italienisch, Japanisch, Javanisch, Khmer, Koreanisch, Lao, Lettisch, Litauisch, Malagasy, Malaiisch, Maltesisch, Marathi, Nepali, Nigerianisches Pidgin, Norwegisch (Bokmål), Persisch, Polnisch, Portugiesisch, Punjabi, Rumänisch, Russisch, Serbisch, Shona, Slowakisch, Slowenisch, Spanisch, Swahili, Schwedisch, Tagalog, Tamil, Telugu, Thai, Türkisch, Ukrainisch, Urdu, Vietnamesisch, Walisisch, Wolof, Xhosa, Yoruba und Zulu.
Tiny Aya: Die Verbindung von Skalierbarkeit und multilingualer Tiefe (2026), von Alejandro R. Salamanca, Diana Abagyan, Daniel D’souza, Ammar Khairi, David Mora, Saurabh Dash, Viraat Aryabumi, Sara Rajaee, Mehrnaz Mofakhami, Ananya Sahu, Thomas Euyang, Brittawnya Prince, Madeline Smith, Hangyu Lin, Acyr Locatelli, Sara Hooker, Tom Kocmi, Aidan Gomez, Ivan Zhang, Phil Blunsom, Nick Frosst, Joelle Pineau, Beyza Ermis, Ahmet Üstün, Julia Kreutzer, Marzieh Fadaee. https://arxiv.org/abs/2603.11510


