









Heute gibt Cohere For AI die Einführung von Aya 23 bekannt – einer neuen Familie hochmoderner, multilingualer, generativer Large Language Research Models (LLMs), die 23 verschiedene Sprachen abdecken. Wir veröffentlichen sowohl die 8-Milliarden- als auch die 35-Milliarden-Parameter-Modelle von Aya 23 als Open-Weights-Modelle, als Teil unseres anhaltenden Engagements für die multilinguale Forschung.
Die Aya 23-Modellfamilie baut auf Aya auf – einer Open-Science-Bewegung, die 3.000 Mitwirkende aus aller Welt vereinte, um den bislang größten multilingualen Datensatz für Instruction Fine-Tuning sowie ein hochmodernes, massiv multilinguales Modell zu entwickeln. Aya 101 deckte 101 Sprachen ab und konzentrierte sich auf Breite; bei Aya 23 liegt der Fokus hingegen auf Tiefe, indem ein hochperformantes vortrainiertes Modell mit der kürzlich veröffentlichten Aya-Datensatzsammlung kombiniert wird. Das Ergebnis ist ein leistungsstarkes, multilinguales Large Language Research Model, das 23 Sprachen unterstützt und die Fähigkeiten moderner Sprachmodelle auf fast die Hälfte der Weltbevölkerung ausweitet.
Aya 23 sowie die gesamte Familie der Aya-Modelle und -Datensätze tragen zu einem Paradigmenwechsel in der Herangehensweise der ML-Community an die multilinguale KI-Forschung bei. Da LLMs und KI im Allgemeinen die globale Technologielandschaft verändert haben, blieben viele Gemeinschaften weltweit aufgrund der Sprachbeschränkungen bestehender Modelle unversorgt. Die meisten hochperformanten Sprachmodelle unterstützen nur eine Handvoll Sprachen. Aya 23 ist Teil unseres Engagements, durch erstklassige Forschung zu demonstrieren, dass mehr Sprachen als gleichwertige Komponenten behandelt werden können, und Modelle bereitzustellen, die Forschende unterstützen, die sich dieser Mission anschließen. Aya 23 sowie die gesamte Familie der Aya-Modelle und -Datensätze tragen zu einem Paradigmenwechsel in der Herangehensweise der ML-Community an die multilinguale KI-Forschung bei.
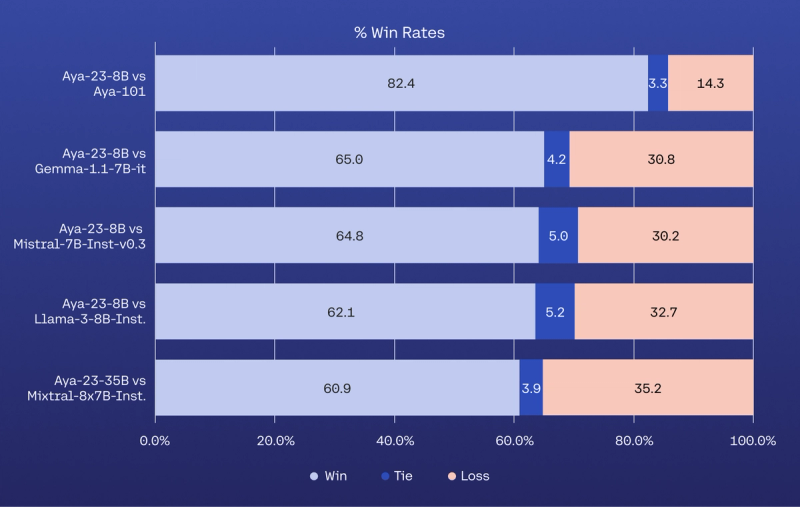
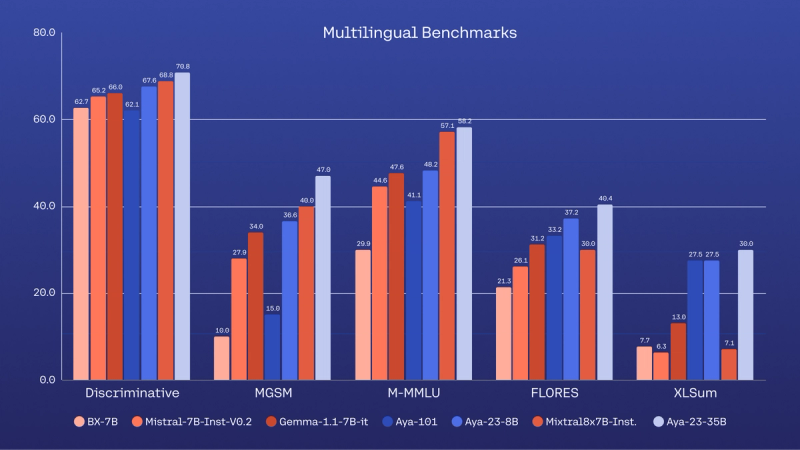
Wir haben die Leistung von Aya 23 sowohl im Vergleich zu massiv multilingualen Open-Source-Modellen wie Aya-101 als auch zu weit verbreiteten Open-Weights-Modellen mit Instruction-Tuning benchmarkt. Das Aya 23-Modell mit 35 Milliarden Parametern erzielt in allen Benchmarks für die abgedeckten Sprachen die besten Ergebnisse, während die 8-Milliarden-Parameter-Version von Aya 23 eine erstklassige multilinguale Performance bietet. Mit dieser Veröffentlichung demonstrieren wir überlegene Fähigkeiten bei komplexen Aufgaben wie dem Verständnis natürlicher Sprache, der Zusammenfassung und der Übersetzung über ein breites linguistisches Spektrum hinweg.
Die 8-Milliarden-Parameter-Version von Aya 23 unterstreicht unser Engagement für die Entwicklung hocheffizienter und zugänglicher multilingualer Forschungs-Modelle für Entwickler im Alltag. Aufgrund der kompakteren Modellgröße werden weniger Rechenressourcen benötigt. Dies sind entscheidende Faktoren, um die globale Kluft bei der Demokratisierung des Zugangs zu modernster Technologie für KI-Forschende zu schließen. Dies ist Teil unserer laufenden Forschung im Labor zur Bereitstellung von Effizienz im großen Maßstab; erfahren Sie mehr über unsere Arbeit hier.
Aya 23 steht nun für Experimente, Erkundungen und Weiterentwicklungen im Bereich der Grundlagenforschung und Sicherheitsaudits zur Verfügung. Das Modell können Sie hier erleben: https://huggingface.co/spaces/CohereForAI/aya-23.
Erfahren Sie mehr über dieses Modell und die umfassende Aya-Initiative unter https://cohere.com/research/aya.
Zudem veröffentlichen wir einen technischen Bericht zu Aya 23, der einen vollständigen Satz von Evaluierungsergebnissen zu verschiedenen mehrsprachigen NLP-Benchmarks sowie Bewertungen der Generierungsqualität enthält.


