









Heute gibt Cohere For AI, die Forschungsabteilung von Cohere, stolz den Launch von Aya Expanse bekannt – einer Familie hochperformanter multilingualer Modelle, die in 23 Sprachen herausragende Ergebnisse liefert und andere führende Open-Weights-Modelle übertrifft.
Wir veröffentlichen Aya Expanse als Open-Weights-Modelle mit 8 und 32 Milliarden Parametern auf Kaggle und Hugging Face. Dies ist Teil unseres anhaltenden Engagements für die multilinguale Forschung und dient dazu, die Grenzen der multilingualen KI voranzutreiben. Das Modell mit 8 Milliarden Parametern macht bahnbrechende Fortschritte für Forscher weltweit zugänglicher, während unser Modell mit 32 Milliarden Parametern modernste multilinguale Fähigkeiten bietet.
Aya Expanse markiert einen wichtigen Schritt zur Erweiterung der hochwertigen Sprachabdeckung in LLMs. Seit dem Start der Aya-Initiative vor zwei Jahren haben wir mit über 3.000 Forschern aus 119 Ländern zusammengearbeitet, um wegweisende multilinguale Forschung voranzutreiben. Dazu gehörte die Veröffentlichung der Aya-Collection, der bisher größten Sammlung multilingualer Datensätze mit 513 Millionen Beispielen, sowie wichtiger Evaluationsdatensätze für multilinguale Leistung und Sicherheit. Zudem wurde Aya-101, das bisher umfassendste multilinguale Modell, das 101 Sprachen abdeckt, veröffentlicht.
Ein Fokus auf multilinguale Forschung
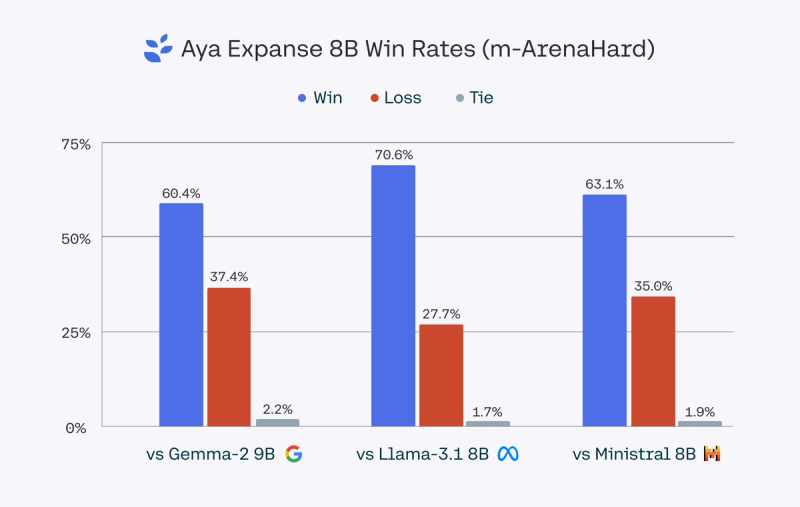
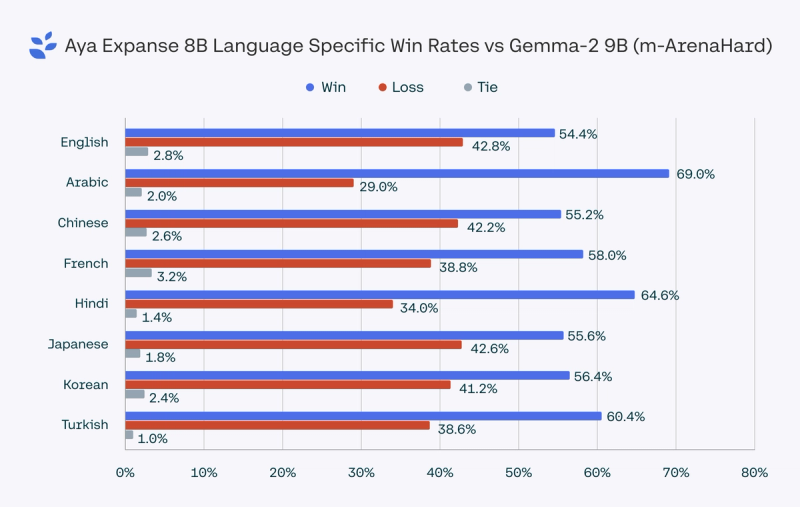
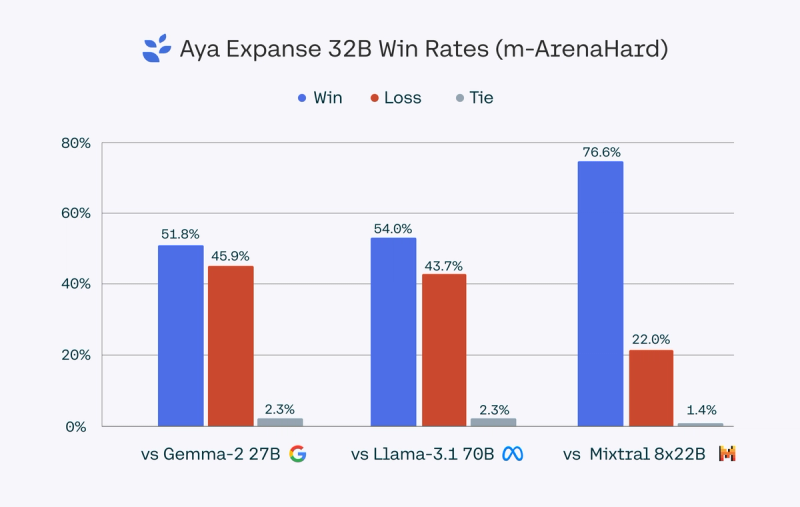
Im größeren Maßstab übertrifft Aya Expanse 32B die Modelle Gemma 2 27B, Mistral 8x22B und Llama 3.1 70B – letzteres ist mehr als doppelt so groß – und setzt damit neue Maßstäbe für die multilinguale Leistung. Zudem haben wir Aya Expanse 8B veröffentlicht, das führende Open-Weights-Modelle seiner Größenklasse wie Gemma 2 9B, Llama 3.1 8B und das kürzlich veröffentlichte Ministral 8B übertrifft, mit Erfolgsquoten zwischen 60,4 % und 70,6 %.
Die Verbesserungen in Aya Expanse sind das Ergebnis einer konsequenten Fokussierung darauf, die Art und Weise, wie KI Sprachen weltweit unterstützt, durch eine Neugestaltung der grundlegenden Bausteine von Durchbrüchen im maschinellen Lernen zu erweitern. Unsere Forschungsagenda der letzten Jahre umfasste einen gezielten Schwerpunkt auf die Überwindung der Sprachbarrieren, wobei mehrere Durchbrüche erzielt wurden, die für die aktuelle Methodik entscheidend waren: Data Arbitrage, Präferenztraining für die allgemeine Leistungsfähigkeit sowie Sicherheit, und schließlich Model Merging. Im Folgenden stellen wir diese Forschung vor.
Weiterentwicklung synthetischer Daten für Sprachen mit begrenzten Datenressourcen. Der Einsatz synthetischer Daten – also Daten, die von einem Experten- oder „Lehrermodell“ generiert werden, um ein anderes Modell zu trainieren – spielt eine zunehmend zentrale Rolle bei der Entwicklung von LLMs, insbesondere da die Modelltrainings die verfügbaren Datenquellen bereits weitgehend ausgeschöpft haben. Bei mehrsprachigen Daten, insbesondere bei Sprachen mit geringen Ressourcen, gibt es jedoch nur wenige geeignete Beispiele für Lehrermodelle, was die Nutzung synthetischer Daten zusätzlich erschwert.
Wir haben eine neuartige Daten-Sampling-Strategie entwickelt, die wir als Data Arbitrage bezeichnen, um einen Mode-Collapse oder die Generierung von „Unsinn“ bei übermäßiger Nutzung synthetischer Daten zu vermeiden. Data Arbitrage orientiert sich daran, wie Menschen lernen, indem sie für verschiedene Fähigkeiten unterschiedliche Lehrer aufsuchen. Wer Klavierspielen lernen möchte, wendet sich an einen Klavierlehrer; wer Backen lernen will, sucht einen Backexperten auf. Wir wenden dieselbe Philosophie auf die KI an und wählen strategisch verschiedene „Lehrermodelle“ basierend auf der Datenverteilung aus, um geeignete synthetische Daten für mehrsprachige Fähigkeiten zu generieren.
Ausrichtung von Modellen an globalen Präferenzen. Präferenztraining wird in den späten Phasen des Modelltrainings eingesetzt, um mithilfe von menschlichem Feedback das Modell auf die Erzeugung hochwertiger Ergebnisse auszurichten. Wir betrachten dies als den „letzten Schliff“ beim Training eines KI-Modells. Allerdings neigen Präferenztraining und Sicherheitsmaßnahmen oft dazu, sich zu stark an den in westlich geprägten Datensätzen vorherrschenden Problematiken anzupassen. Problematisch ist zudem, dass diese Sicherheitsmechanismen häufig nicht auf mehrsprachige Szenarien übertragbar sind. Unsere Arbeit ist eine der ersten, die Präferenztraining auf einen massiv mehrsprachigen Kontext ausweitet und dabei unterschiedliche kulturelle und sprachliche Perspektiven berücksichtigt. Wir stellen fest, dass dies zu erheblichen Verbesserungen sowohl bei der allgemeinen Leistungsfähigkeit als auch bei der Sicherheit führt.
Model Merging in einer vielfältigen Welt. Der letzte Schritt zu unserem Durchbruch bei der mehrsprachigen Leistungsfähigkeit ist unsere Arbeit zum Model Merging – der Kombination der Gewichte mehrerer Kandidatenmodelle in jeder Phase, um mehr Vielseitigkeit und Performance zu erreichen.
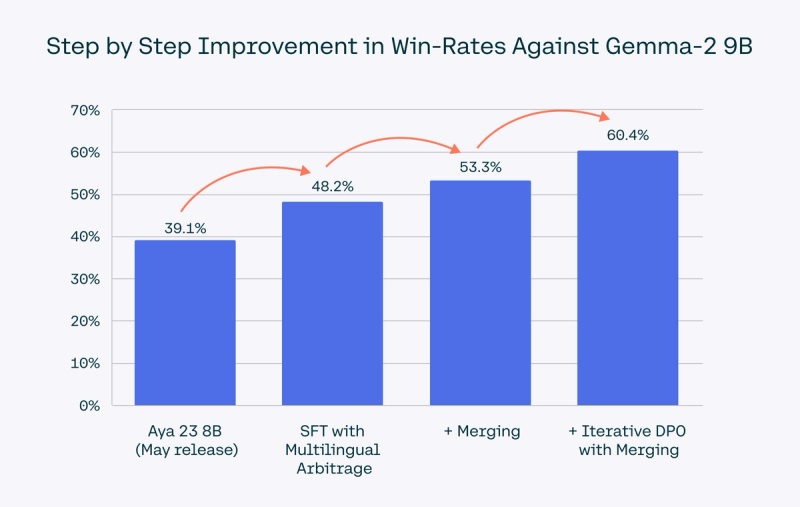
Wir bündeln unsere Forschungsergebnisse, um das beste mehrsprachige Modell seiner Klasse zu entwickeln.Wir haben all diese Techniken in einem einzigen Trainingskonzept für Aya Expanse vereint. Jede dieser Techniken – von Data Arbitrage über das Merging bis hin zur Optimierung mehrsprachiger Präferenzen – ermöglicht schrittweise Verbesserungen, was zu einem deutlichen Vorsprung gegenüber anderen führenden Modellen derselben Parameterklasse führt. Im Vergleich zu Gemma 2 9B erreicht Aya Expanse 8B eine Gewinnrate von 60,4 % und setzt damit neue Maßstäbe für die Leistung mehrsprachiger LLMs in dieser Klasse.
Auf dem Weg zur technologischen Spitze im Bereich Mehrsprachigkeit.
Jeder algorithmische Durchbruch, den wir im Laufe des Jahres erzielt und in Aya Expanse integriert haben, skaliert mit der Modellgröße und ermöglicht eine Leistung auf dem neuesten Stand der Technik. Um dieses Potenzial voll auszuschöpfen, haben wir dasselbe Trainingskonzept angewandt, das Data Arbitrage, Preference Training und Merging kombiniert. Wie bei unserem kleineren Modell führt dieses Konzept zu einer signifikanten Leistungssteigerung. Aya Expanse 32B übertrifft Gemma 2 27B, Mistral 8x22B und das deutlich größere Llama 3.1 70B mit paarweisen Gewinnraten zwischen 51,8 % und 76,6 % insgesamt in 23 Sprachen.
Diese Ergebnisse verdeutlichen die Auswirkungen unserer Forschung im Bereich Mehrsprachigkeit über kleine Sprachmodelle hinaus und markieren einen neuen Meilenstein bei der skalierbaren mehrsprachigen Leistung.
Machen Sie mit
Zusätzlich zur Veröffentlichung der Open-Weights-Modelle für 8B und 35B arbeiten wir aktiv mit der breiteren Forschungscommunity zusammen, um die Entwicklung mehrsprachiger KI zu beschleunigen. Bewerben Sie sich hier für eines unserer Forschungsstipendiengrants hieroder nehmen Sie an unserer nächsten Forschungs-Kohorte teil, in der wir Rechenressourcen und Expertise bereitstellen, um die Zusammenarbeit zwischen verschiedenen Institutionen zu fördern.
Aya ist Teil unseres kontinuierlichen Engagements für eine höhere mehrsprachige Leistung und Sicherheit. Erfahren Sie hier mehr über unsere Forschunghier, und erwägen Sie, Teil unseres Teams zu werden.
Die Aya Expanse-Modelle sind ab sofort für Forscher und Entwickler auf der Cohere API-Plattform, Kaggle und Hugging Face verfügbar.
Danksagungen
Diese Arbeit ist das Ergebnis einer enormen gemeinsamen Anstrengung der Teams von Cohere For AI und Cohere. Ein besonderer Dank gilt auch unserer Forschungscommunity – den 220 Sprachbotschaftern aus aller Welt, die an dieser Veröffentlichung mitgewirkt haben. Sie sind nachfolgend in alphabetischer Reihenfolge aufgeführt:
Mehmet Emre Akbulut (Türkisch/Türkei), Samer Attrah (Niederländisch, Arabisch/Niederlande), MUHDIN AWOL (Englisch/Äthiopien), Kenza Benkirane (Arabisch, Französisch/Marokko), Mann Bhanushali (Hindi, Englisch/Indien), Isabella Bicalho Frazeto (Französisch, Portugiesisch/Brasilien, Frankreich), Danylo Boiko (Ukrainisch/Ukraine), Sabrina Boumaiza (Arabisch/Algerien), Samuel Cahyawijaya (Indonesisch/Indonesien), Samuel Cahyawijaya (Indonesisch, Englisch/Indonesien), Emirhan Çelik (Türkisch/Türkei), Ryan Chan (Italienisch, Englisch/Vereinigtes Königreich), Aurélien-Morgan CLAUDON (Französisch/Frankreich), Urszula Czerwinska (Polnisch, Französisch/Frankreich, Polen), Joana da Matta (Portugiesisch/Brasilien), Nguyễn Đạt (Vietnamesisch/Vietnam), Manasvi Dawane (Hindi/Indien), Akanksha Devkar (Hindi/Indien), Sharad Duwal (Englisch/Nepal), Abdeljalil EL MAJJODI (Arabisch/Marokko), Shafagh Fadaei (Persisch/Iran), Neil Fernandes (Deutsch, Japanisch, Hindi/Kanada), Silvia Fernandez (Spanisch, Englisch/Argentinien), Hamidreza Ghader (Persisch, Niederländisch/Iran, Niederlande), Manuel Goulão (Portugiesisch/Portugal), Bassam Gouti (Arabisch, tunesischer Dialekt/Tunesien), María Grandury (Spanisch/Spanien), Miguel Guerrero (Spanisch/Spanien), Siddhesh Gunjal (Hindi/Indien), Mohammed Hamdy (Arabisch, Englisch/Ägypten), Hafedh Hichri (Arabisch, Französisch/Tunesien), Nhu Hoang Anh Quynh (Japanisch, Vietnamesisch/Japan, Vietnam), Kyle Howard (Englisch, Spanisch/Vereinigte Staaten), Jiwung Hyun (Koreanisch/Südkorea), Joseph Marvin Imperial (Filipino/Philippinen), Burin Intachuen (Japanisch/Japan), Ryan Junejo (Englisch, Hindi/Kanada), Juan Junqueras (Spanisch/Argentinien), Karthik Reddy Kanjula (Englisch, Hindi/USA, Indien), Albert Kao (Chinesisch/Taiwan), Morteza Kashani (Persisch/Iran), Ahmed Khaled (Arabisch/Ägypten), Niharika Khanna (Hindi, Punjabi/Indien), Dipika Khullar (Hindi/Vereinigte Staaten, Indien), Christopher Klamm (Deutsch/Deutschland), Nazar Kohut (Ukrainisch/Ukraine), Alkis Koudounas (Italienisch, Griechisch/Italien, Griechenland), Diana Kozachek (Deutsch, Ukrainisch/Deutschland), Katrina Lawrence (Englisch, Französisch, Deutsch/Kanada), James León (Spanisch/Ecuador), Jiazheng Li (Chinesisch/China, Vereinigtes Königreich), Nicolò Loddo (Italienisch/Italien), Dante, Fu On Lok (Chinesisch, Englisch/Hongkong), Iro Malta (Griechisch, Deutsch/Griechenland, Deutschland), Harras Mansoor (Urdu/Pakistan), Bhavnick Minhas (Hindi/Indien), Shachar Mirkin (Hebräisch), Roa’a Mohammad (Arabisch/Jordanien), Yiyang Nan (Chinesisch/China), Sree Harsha Nelaturu (Hindi, Deutsch/Indien, Deutschland), Jekaterina Novikova (Englisch, Russisch/Kanada), Roni Obaid (Arabisch, Englisch/Syrien), Olympiah Otieno (Englisch/Kenia), Enes Özgözler (Türkisch/Türkei), Yavuz Alp Sencer Ozturk (Türkisch/Türkei), Carlos Patiño (Spanisch/Kolumbien), Jebish Purbey (Englisch, Hindi/Nepal), Maria Quijano Jesurum (Spanisch/Kolumbien), Swati Rajwal (Hindi, Englisch/USA), Didi Ramsaran Chin (Spanisch, Englisch/Venezuela), Divyaraj Rana (Hindi, Englisch/Vereinigte Staaten), Aditya Retnanto (Indonesisch/Indonesien), Rodrigo Ribeiro Gomes (Portugiesisch/Brasilien), Esra'a Saleh (Englisch, Arabisch/Kanada), Roshan Santhosh (Hindi/Indien, USA), Drishti Sharma (Hindi, Spanisch/Indien, Spanien, lateinamerikanische Länder), Kinza Sheikh (Urdu/Pakistan), Aditya Shrivastava (Hindi, Englisch/Indien, Irland), Vivek Silimkhan (Hindi, Englisch/Indien), Marjana Skenduli (Englisch, Italienisch/Albanien), Soham Sonar (Hindi, Marathi/Indien), Gürkan Soykan (Türkisch/Türkei), David Styveen (Portugiesisch/Brasilien), Anthony Susevski (Englisch/Kanada), Adrian Szymczak (Polnisch/Polen), Joanne Tan (Englisch, Mandarin-Chinesisch/Singapur), Quentin Tardif (Französisch/Frankreich), Ameed Taylor (Englisch, Deutsch/USA, Deutschland), Yiorgos Tsalikidis (Griechisch/Griechenland), Roman Tymtsiv (Ukrainisch/Ukraine), Muhammad Saad Uddin (Deutsch/Deutschland), Louis Ulmer (Französisch/Frankreich), Sundar Sripada V. S. (Englisch/Vereinigte Staaten), Freddie Vargus (Englisch, Spanisch/Vereinigte Staaten), Vlad Vasilescu (Rumänisch/Rumänien), Karan Verma (Englisch, Hindi/Indien), Henry Vo (Vietnamesisch/Vietnam), Minh Chien Vu (Japanisch, Vietnamesisch/Japan, Vietnam), Hieu Vu (Vietnamesisch/Vietnam), Azmine Toushik Wasi (Englisch, Hindi, Arabisch, Spanisch/Bangladesch), Warren Williams (Englisch/Vereinigte Staaten), Joseph Wilson (Französisch/Kanada), Gusti Winata (Indonesisch/Indonesien), Ege Yakut (Türkisch, Englisch/Türkei), Eray Yapağcı (Türkisch/Türkei), Taha Yassine (Arabisch, Französisch/Marokko), Serhan YILMAZ (Türkisch/Türkei), Hanna Yukhymenko (Ukrainisch/Ukraine), Mike Zhang (Niederländisch/Niederlande).


