Aujourd’hui, nous lançons Command A Vision, un nouveau modèle génératif de pointe qui offre aux entreprises des performances exceptionnelles dans les tâches multimodales de vision, tout en conservant d’excellentes capacités de traitement du texte. Command A Vision permet aux agents d’avoir une vision interne de l’entreprise, ce qui facilite l’automatisation des tâches fastidieuses utilisant des données visuelles telles que des diapositives, des diagrammes, des PDF et des photos. Qu’il s’agisse d’interpréter des manuels de produits ou d’analyser des scènes réelles pour détecter des risques, le modèle excelle dans la résolution des défis les plus complexes en matière de vision pour les entreprises.
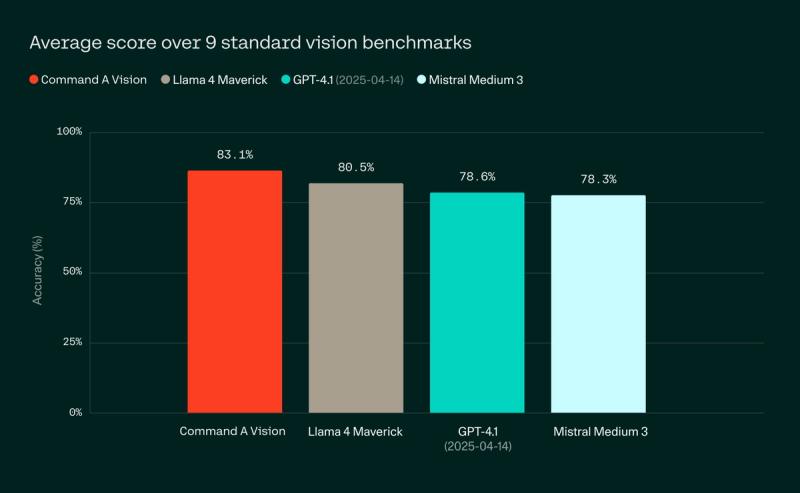
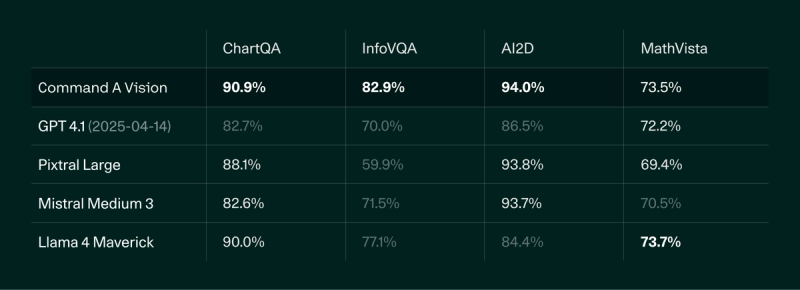
Il surpasse les autres modèles de sa catégorie, notamment GPT-4.1, Llama 4 Maverick, Mistral Medium 3 (et Pixtral Large), sur les principaux benchmarks multimodaux. Command A Vision répond prioritairement aux besoins des entreprises grâce à des options de déploiement hautement sécurisées, efficaces et flexibles. Sa faible empreinte matérielle permet un déploiement fluide sur site ou dans un environnement privé avec deux GPU ou moins, garantissant ainsi une évolutivité adaptée aux besoins des entreprises.
Des performances exceptionnelles dans les tâches de vision pour les entreprises
Analyse de graphiques, de diagrammes et de schémas
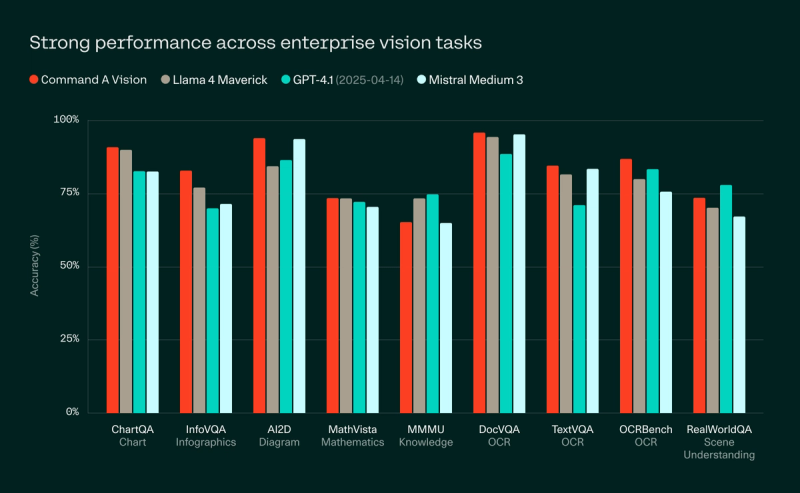
Command A Vision excelle dans la compréhension et l’analyse d’une large gamme de données visuelles et multilingues, notamment les graphiques, les diagrammes, les tableaux et les schémas. Le modèle extrait avec précision des données à partir de divers formats visuels, applique des connaissances spécifiques à chaque secteur dans des domaines tels que la finance, la santé, l’industrie manufacturière, la construction et l’énergie, et effectue des analyses complexes basées sur les informations extraites.
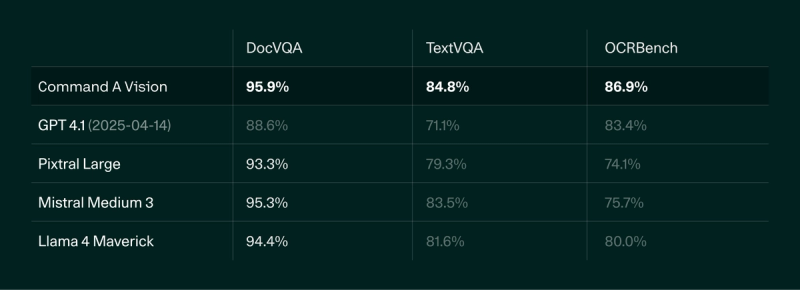
OCR de documents et traitement visuel
Command A Vision se distingue dans le domaine de l’OCR de documents et du traitement visuel, en extrayant avec précision du texte et des informations à partir de divers types de documents, notamment les documents numérisés, les factures et les formulaires. Le modèle va au-delà de la simple reconnaissance de texte, en comprenant la mise en page et la structure des documents pour extraire des données pertinentes. Cette fonctionnalité, combinée à notre prise en charge de la sortie de données structurées en mode JSON, permet à Command A Vision d’automatiser les tâches répétitives de traitement de documents, d’améliorer la précision des données, de rationaliser les flux de travail et de s’intégrer parfaitement aux systèmes existants, ce qui en fait un outil indispensable pour les entreprises traitant de grands volumes de documents. Il atteint des performances de premier ordre sur les benchmarks DocVQA, TextVQA et OCRBench.
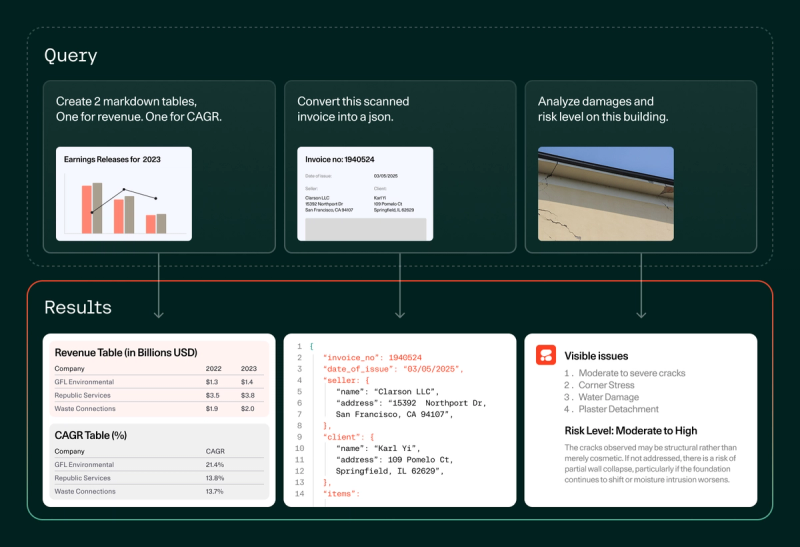
Compréhension des scènes du monde réel
Les capacités de Command A Vision s’étendent à la compréhension des scènes du monde réel, lui permettant d’analyser et d’interpréter des environnements visuels complexes. Cela va au-delà de la simple détection d’objets, car le modèle peut comprendre les relations spatiales, le contexte et même les nuances subtiles dans les images et les photographies, ce qui le rend idéal pour un large éventail d’applications concrètes, notamment la détection des risques dans les environnements industriels et l’analyse du secteur de la vente au détail.
Des capacités et une efficacité adaptées à l’échelle des entreprises
Command A Vision a été conçu pour répondre aux besoins des entreprises dans les domaines qui leur sont les plus importants. Il intègre les autres fonctionnalités textuelles essentielles de Command A, telles que la génération augmentée par récupération (RAG) avancée avec citations, ainsi que des performances multilingues dans plusieurs langues clés pour les entreprises.
Grâce à Command A Vision, les entreprises peuvent accéder rapidement et en toute sécurité à des analyses et des informations contextuelles basées sur leurs propres données, qu'il s'agisse de texte ou de divers formats d'images d'entreprise, sur le matériel dont elles disposent et dans les langues dont elles ont besoin. Notre série de modèles Command est conçue en priorité pour répondre aux besoins des entreprises : elle excelle dans les applications métier complexes tout en équilibrant performance, précision et efficacité.
Grâce à des exigences matérielles minimales, les entreprises opérant dans des secteurs réglementés et ayant besoin de déploiements privés peuvent utiliser Command A Vision en production de manière efficace. Command A Vision peut être déployé en environnement privé avec seulement deux GPU ou moins. Il ne nécessite que deux A100, ou un seul H100 pour une quantification en 4 bits.
Ce que disent les clients
« Nous sommes extrêmement enthousiastes à l’idée du lancement de Command A Vision. Ces modèles repoussent considérablement les limites de ce qui est possible avec l’IA générative, nous permettant de dépasser le texte pour entrer dans le domaine de la compréhension visuelle. Nous avons déjà constaté que Command A Vision résout certains de nos défis les plus complexes et les plus chronophages ; il simplifie non seulement les flux de travail, mais ouvre également des opportunités entièrement nouvelles pour l’IA générative. En intégrant le contexte visuel dans nos systèmes d’IA, nous pouvons commencer à développer des solutions fondées sur ce que nous voyons, et pas seulement sur ce que nous lisons. J’ai hâte de voir jusqu’où nous pourrons pousser cette technologie et ce que nous pourrons accomplir grâce à elle dans notre boîte à outils. » – Jeffrey English, Directeur, Services professionnels, Fujitsu Intelligence
« Lors des premiers tests, le modèle Command A Vision a démontré des capacités exceptionnelles pour comprendre et extraire des données de documents complexes du secteur de la construction, tels que des renonciations à privilège, des factures et des plans. La possibilité d'automatiser ce type de capture de données pilotée par l'IA a le pouvoir de transformer le traitement des documents, la précision des données et la gestion de projet, ce qui pourrait réduire les risques, les délais et les coûts pour le secteur de la construction. » – Mark Webster, Vice-président senior et Directeur général, Oracle Infrastructure Industries
Disponibilité
Command A Vision est disponible dès aujourd’hui sur la plateforme Cohere et pour un usage en recherche sur Hugging Face. Si vous êtes intéressé par des déploiements privés ou sur site, veuillez contacter notre équipe commerciale pour obtenir un devis personnalisé.
[1] Nous nous comparons aux meilleurs modèles sans capacité de raisonnement (non obsolètes) disponibles chez d'autres fournisseurs. Lorsque les scores de référence sont disponibles, ils sont tirés soit des rapports des autres fournisseurs, soit de classements publics ; sinon (chiffres grisés), nous utilisons une évaluation interne basée sur les meilleures pratiques, réalisée via VLMEvalKit ou le code source officiel.