Aujourd’hui, nous lançons Command A, un nouveau modèle génératif de pointe conçu pour les entreprises exigeantes qui ont besoin d’une IA rapide, sécurisée et de haute qualité. Command A offre des performances maximales avec des coûts matériels minimaux par rapport aux principaux modèles propriétaires et à poids ouverts, tels que GPT-4o et DeepSeek-V3. Pour les déploiements privés, Command A excelle dans les tâches agentiques et multilingues critiques pour l’entreprise, tout en pouvant être déployé sur seulement deux GPU, contre jusqu’à 32 GPU requis par d’autres modèles.
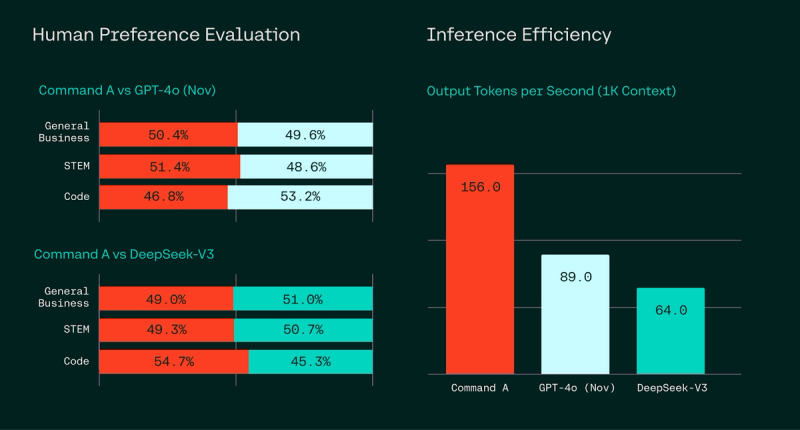
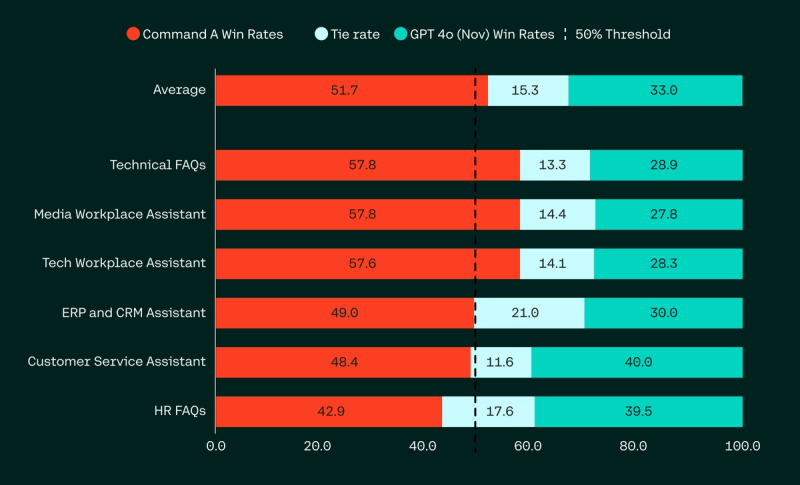
Lors de tests comparatifs réalisés par des humains sur des tâches liées aux affaires, aux sciences et à la programmation, Command A égale ou surpasse ses concurrents plus volumineux et plus lents, tout en offrant un débit supérieur et une efficacité accrue. Les évaluations humaines sont essentielles, car elles reposent sur des données et des scénarios réels issus du monde de l’entreprise.
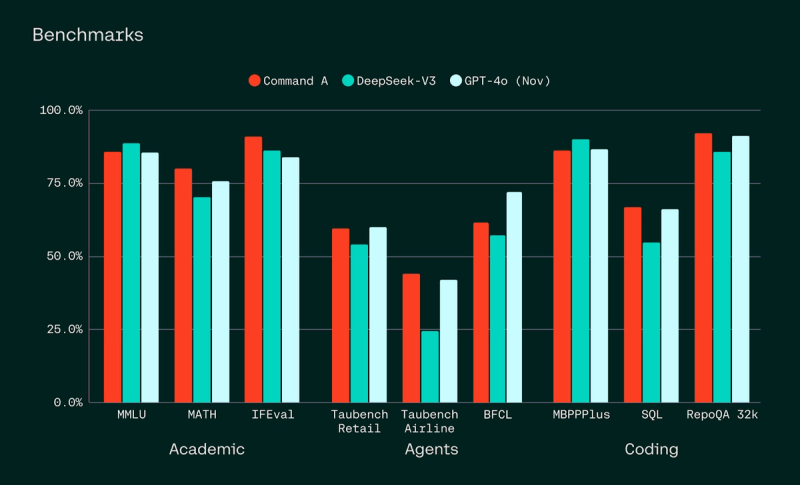
Sur un large éventail de benchmarks standard, Command A offre d’excellentes performances en matière de respect des instructions, de SQL, de tâches agentiques et d’utilisation d’outils.
Une efficacité évolutive
Nous avons conçu Command A en mettant l’accent sur l’efficacité, tant lors de son développement que lors de son déploiement en production. Avec une infrastructure de déploiement nécessitant seulement deux GPU A100 ou H100, il consomme beaucoup moins de ressources de calcul que d’autres modèles comparables sur le marché. Cela est particulièrement important pour les déploiements privés.
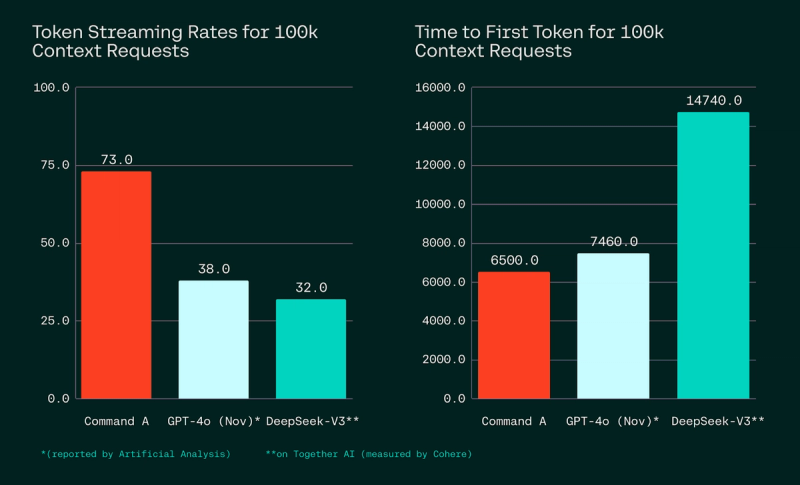
Des modèles excessivement volumineux entraînent une latence élevée. Lorsque vous avez simplement besoin de réponses précises et rapides, Command A est le meilleur choix. En effet, Command A peut générer des jetons à un débit allant jusqu’à 156 jetons par seconde, soit 1,75 fois plus que GPT-4o et 2,4 fois plus que DeepSeek-V3. Les déploiements privés de Command A peuvent être jusqu’à 50 % moins coûteux que l’accès via API.
Des fonctionnalités adaptées aux entreprises
Nous avons conçu Command A en tenant compte des besoins des entreprises. Sa capacité de traitement de contexte de 256 000 jetons (le double de la plupart des modèles de pointe) permet de gérer des documents d’entreprise beaucoup plus longs. Parmi ses autres fonctionnalités clés figurent la génération augmentée par récupération (RAG) avancée de Cohere avec des citations vérifiables, l’utilisation d’outils agentiques, une sécurité de niveau entreprise et d’excellentes performances multilingues.
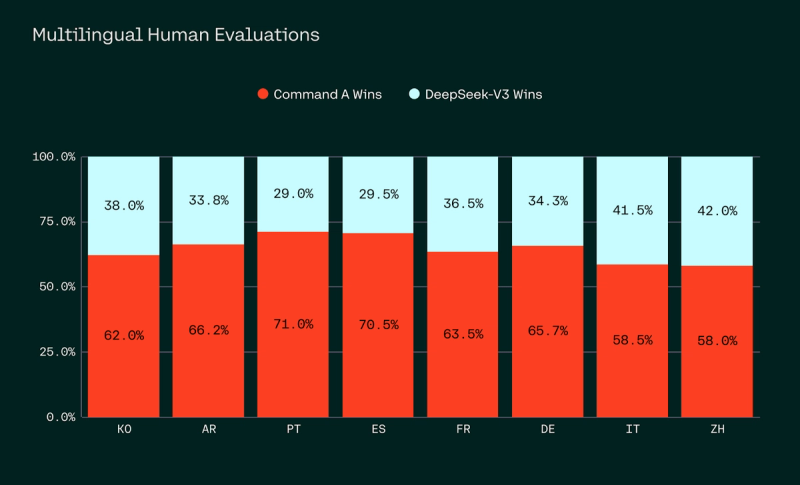
Nous comprenons que les entreprises mondiales ont besoin de fonctionnalités adaptées à différentes régions. Command A offre un support étendu de niveau entreprise pour les 23 langues parlées par la majorité de la population mondiale. Nous avons mené une évaluation humaine approfondie et constaté que les utilisateurs préféraient largement Command A à DeepSeek-V3 dans la plupart des langues, sur un large éventail de cas d’utilisation professionnels.
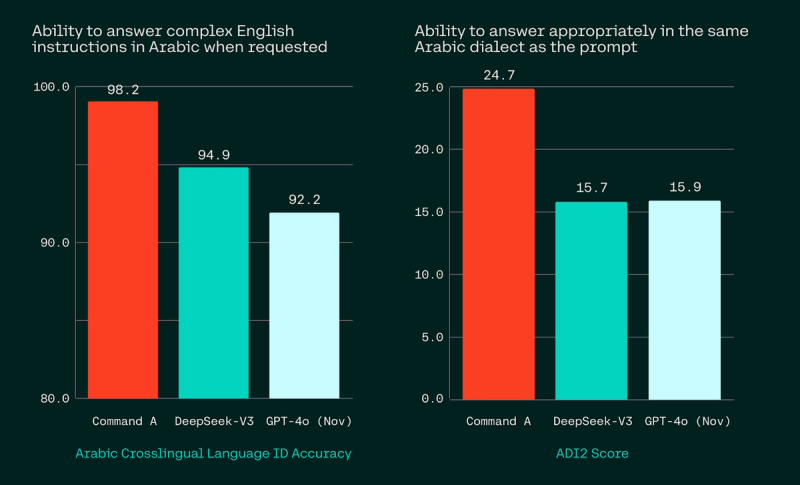
En particulier, Command A surpasse largement GPT-4o ou DeepSeek-V3 pour fournir systématiquement des réponses dans la langue demandée, par exemple en utilisant le dialecte arabe approprié selon l'utilisateur.
Propulser des agents d'IA à grande échelle
La qualité d'une IA dépend entièrement des données que vous lui fournissez. C'est pourquoi Command A génère en toute sécurité des réponses précises aux questions en s'appuyant sur les informations internes de votre entreprise. Concrètement, les clients utilisent cette fonctionnalité pour des tâches telles que la recherche de politiques RH adaptées selon le site, la consultation de réglementations juridiques ou l'analyse de longs rapports financiers.
La prochaine génération de modèles Cohere permettra de développer diverses applications d'IA pour des clients issus de secteurs tels que la finance, la santé, l'industrie manufacturière, l'énergie et le secteur public. En particulier, ils s'intégreront parfaitement à North, notre plateforme sécurisée d'agents d'IA, afin d'exploiter pleinement le potentiel des données et des talents de votre entreprise grâce aux agents d'IA. Notre pile technologique entièrement intégrée permet une personnalisation complète du produit pour répondre aux besoins spécifiques de chaque client.
North exploite en toute sécurité des outils d'entreprise tels que les logiciels CRM et ERP, tout en se connectant aux bases de données internes de l'entreprise et aux services de recherche web externes. Cela vous permet de créer des agents capables d'agir pour vous, derrière les pare-feu sécurisés de vos systèmes d'entreprise.
Disponibilité
Command A est disponible dès aujourd'hui sur la plateforme Cohere, pour un usage en recherche sur Hugging Face, et sera bientôt disponible chez les principaux fournisseurs de services cloud. Si vous êtes intéressé par des déploiements privés ou sur site, veuillez contacter notre équipe commerciale.
[1]BFCL : Performances sur le benchmark BFCL-v3 au 12 mars 2025. Lorsque les scores sont disponibles, ils sont extraits du classement public ; sinon, nous utilisons une évaluation interne réalisée avec le plus grand soin à partir du code source officiel. Pour les concurrents, nous retenons le score le plus élevé entre les évaluations « prompted » et « function-calling » de BFCL. Nous communiquons le score global, qui évalue l’utilisation d’outils dans divers environnements réels.
Taubench : Performances sur le benchmark Taubench. Lorsque les scores sont disponibles, ils sont extraits du classement public du dépôt ; sinon, nous utilisons une évaluation interne réalisée avec le plus grand soin à partir du code source officiel. Nous communiquons les scores pass@1 pour les tâches Retail et Airline, qui évaluent les agents d’utilisation d’outils dans des scénarios de support client multi-étapes.
Secteur universitaire : Performances sur des benchmarks universitaires couvrant les connaissances générales (MMLU), les compétences en mathématiques (MATH) et le respect des instructions (IFEval). Nous constatons que Command-A atteint un niveau de performance équivalent, voire supérieur, à celui de GPT-4o et DeepSeek-V3.
Développement : Nous observons que Command-A affiche des performances particulièrement solides sur les benchmarks SQL (moyenne de BirdBench, Spider Dev et Spider Test) et se situe au niveau de GPT-4o pour les cas d’utilisation de MBPPlus (programmation Python). Enfin, nous soulignons ses performances supérieures en matière de réponses à des questions au niveau du dépôt dans des contextes étendus (RepoQA).