Une IA à poids ouverts, conçue pour les langues du monde réel : puissante, adaptable et suffisamment efficace pour fonctionner localement, même sur un téléphone.
Aujourd’hui, Cohere Labs, la branche de recherche de Cohere, présente Tiny Aya, le modèle multilingue à poids ouverts le plus performant dans sa catégorie. Tiny Aya offre une qualité de traduction de pointe, une excellente compréhension multilingue, des réponses de haute qualité dans la langue cible et une large couverture linguistique, le tout dans un modèle suffisamment compact pour fonctionner localement, même sur du matériel grand public et des téléphones mobiles. Aucune barrière à l'expérimentation : simplement une famille de modèles puissants capables de fonctionner partout.
L’IA multilingue a connu des progrès rapides, mais ses performances et son accessibilité restent concentrées sur un petit groupe de langues dominantes et sur des infrastructures de grande envergure. Tiny Aya adopte une approche différente : elle allie une conception efficace à des recherches approfondies en multilinguisme pour garantir des performances équilibrées entre les langues, tout en restant facile à déployer et à adapter. Plutôt que de proposer une couverture superficielle de centaines de langues, Tiny Aya mise sur une profondeur multilingue significative, permettant aux chercheurs, aux développeuses et développeurs ainsi qu’aux communautés de créer une IA qui reflète leurs propres contextes linguistiques et culturels.
Ce que nous lançons
TinyAya-Base, un modèle pré-entraîné de 3,35 milliards de paramètres : TinyAya-Base couvre plus de 70 langues*, dont de nombreuses langues peu dotées issues du monde entier.
TinyAya-Global, un modèle multilingue puissant optimisé pour les instructions : Fondé sur TinyAya-Base, TinyAya-Global offre des performances solides et équilibrées dans 67 langues prises en charge. Il constitue le système véritablement multilingue par défaut, idéal pour les applications nécessitant une qualité constante dans divers contextes linguistiques au sein d'un seul déploiement.
Une famille de modèles spécialisés optimisés pour les instructions : En plus de TinyAya-Global, nous introduisons des variantes spécialisées qui améliorent les performances dans des régions linguistiques spécifiques tout en conservant une forte capacité multilingue à plus grande échelle. Cette structure combine un apprentissage interlinguistique partagé avec une expertise régionale ciblée, offrant ainsi aux chercheurs et aux concepteurs une flexibilité dans le déploiement de l'IA multilingue (les détails des variantes de modèles et des spécialisations régionales sont décrits ci-dessous).
Un nouveau jeu de données d'ajustement fin massivement multilingue et des benchmarks : Couvrant plusieurs domaines, langues et tâches, ces ressources constituent une base pour une expérimentation multilingue systématique, permettant une évaluation reproductible et une exploration continue des stratégies d'entraînement centrées sur les données.
Un rapport technique détaillé : Nous partageons les recherches, la stratégie d'entraînement et les enseignements tirés de l'évaluation qui sous-tendent Tiny Aya.
Tiny Aya marque un tournant dans notre façon de concevoir la création et le partage des systèmes multilingues. Grâce à une conception optimisée, à des recherches approfondies sur le pré-entraînement et le post-entraînement multilingues, et à une attention portée dès le départ à la diversité linguistique, Tiny Aya rend une IA de haute qualité plus accessible à ceux qui en ont le plus besoin : les chercheurs travaillant sur des langues sous-représentées, les développeurs créant des solutions localement, et les communautés qui façonnent la technologie selon leurs propres termes. Par exemple, un laboratoire universitaire en Inde pourrait déployer Tiny Aya comme outil de traduction hors ligne ou d'éducation à l'IA dans les salles de classe et les milieux communautaires, sans dépendre d'API cloud.
Innovation technique
Tiny Aya s'appuie sur plusieurs années de recherche menées dans le cadre de l'initiative Aya sur la manière dont les modèles multilingues peuvent être développés de façon responsable. Plus précisément, l'approche d'entraînement s'appuie sur nos recherches récentes concernant l'augmentation de la plasticité linguistique grâce à la tokenisation, l'amélioration de la naturalisation des données synthétiques, la fusion intelligente de générations diversifiées et la sélection ciblée des méthodes de fusion. Ensemble, ces méthodes permettent de combiner les signaux multilingues tout en préservant les nuances linguistiques et en renforçant la structure propre à chaque langue.
Un autre principe fondamental de la conception de Tiny Aya était l'efficacité dans le cadre de budgets de calcul réalistes. En réalisant le post-entraînement sur un seul cluster de GPU NVIDIA H100 (64 unités), nous démontrons qu'une conception rigoureuse des données multilingues et une stratégie d'entraînement adaptée peuvent se substituer à une mise à l'échelle massive. Ces concepts ont guidé la conception de Tiny Aya dès le départ, influençant la création du tokenizer, le mélange de données et notre approche de la spécialisation par groupes linguistiques.
Tiny Aya dépasse la simple multilinguité en tant qu'objectif unique et intègre des stratégies qui préservent la diversité pendant l'entraînement tout en permettant une adaptation efficace en aval. Cette conception permet aux chercheurs de reconfigurer le modèle sans être entravés par un alignement rigide ou un post-entraînement trop spécialisé, facilitant ainsi l'ajustement fin pour de nouveaux domaines, des langues émergentes ou des cadres d'évaluation communautaires.
Des modèles compacts, des performances puissantes
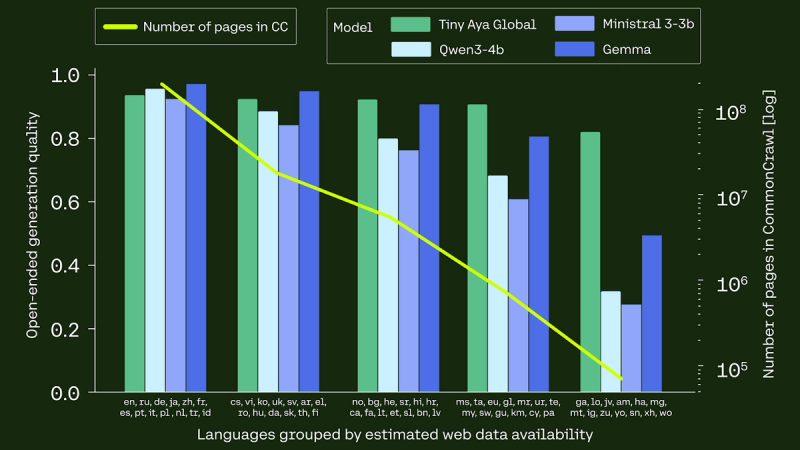
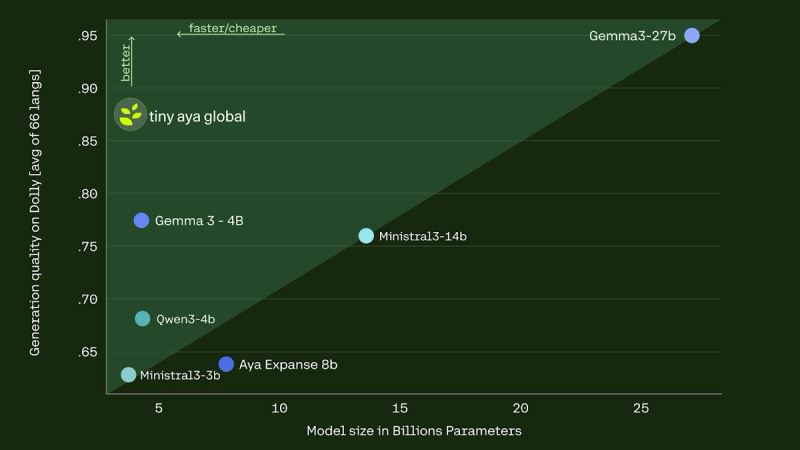
Nous avons conçu Tiny Aya avec un objectif plus large : créer des modèles qui restent fiables dans de nombreuses langues tout en étant suffisamment efficaces pour une utilisation locale. Le résultat est une famille de modèles qui rivalisent avec les modèles multilingues existants dans divers tests d'évaluation, notamment pour la traduction, la qualité de la génération de texte libre et le raisonnement mathématique dans les langues les moins dotées en ressources.
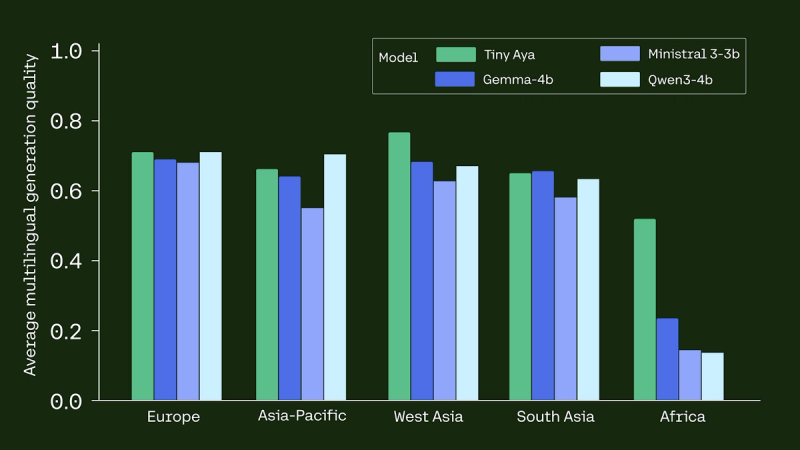
Dans un ensemble complet de tests de référence multilingues pour les modèles génératifs, Tiny Aya se distingue face aux modèles leaders de cette catégorie, améliorant ses performances dans toutes les régions. Ce qui frappe le plus, c'est la constance dont fait preuve Tiny Aya dans divers contextes linguistiques. Plutôt que d'optimiser un ensemble restreint de scores phares, nous avons privilégié la stabilité, l'étendue et l'utilisabilité concrète. Nous avons accordé autant d'importance au « comment » qu'au « quoi », en prenant en compte des facteurs de qualité essentiels pour les locuteurs natifs, tels que la fluidité et la cohérence des réponses. Dans des scénarios multilingues concrets, où l'efficacité, l'adaptabilité et la couverture linguistique comptent autant que la puissance brute, Tiny Aya est le meilleur de sa catégorie et offre un équilibre convaincant entre capacités et accessibilité.
L'accessibilité comme principe de conception
Tiny Aya est conçu pour fonctionner là où se trouvent les utilisateurs : sur des appareils locaux, dans les salles de classe, dans des laboratoires communautaires et dans des régions où les infrastructures à grande échelle ne sont pas toujours disponibles, par exemple pour traduire entre des langues éloignées de toute infrastructure cloud, comme dans un village isolé. Réduire les barrières à l'entrée permet à davantage de personnes de créer, d'expérimenter et de façonner elles-mêmes l'avenir de l'IA multilingue.
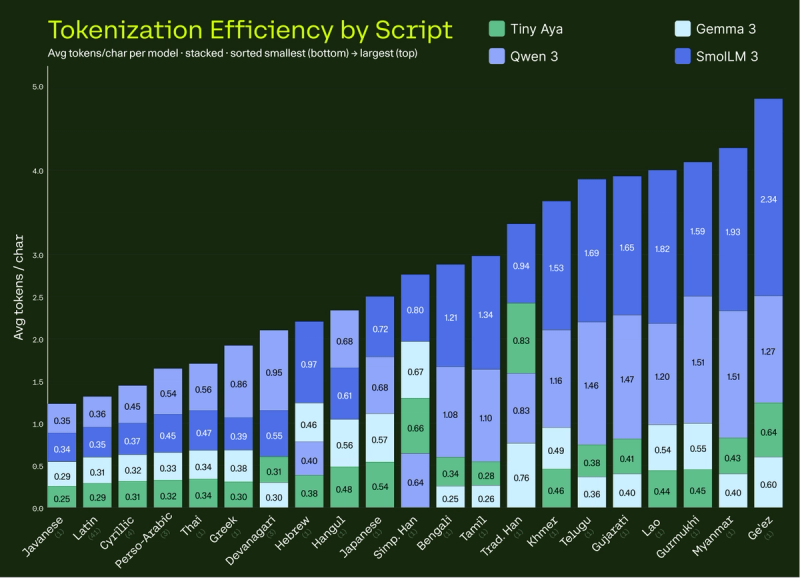
Au-delà de la taille du modèle, l'accessibilité dépend également de l'efficacité avec laquelle la langue est représentée. Le tokeniseur de Tiny Aya a été conçu pour réduire la fragmentation entre les systèmes d'écriture et les structures linguistiques, générant moins de jetons par phrase dans toutes les langues. Cette efficacité de tokenisation accrue réduit les besoins en mémoire et en puissance de calcul lors de l'inférence, rendant les applications multilingues plus pratiques sur du matériel local tout en améliorant la réactivité dans des conditions d'utilisation réelles.
Nous considérons cette version comme la base d'un écosystème plus large de modèles multilingues spécialisés, créés par la communauté de recherche elle-même. Nous invitons les chercheurs et les développeurs du monde entier à utiliser ces modèles et ces jeux de données pour créer leurs propres systèmes axés sur les langues, afin d'étendre la couverture linguistique, d'explorer de nouvelles stratégies d'évaluation et d'orienter l'IA multilingue dans des directions que nous ne pouvons pas prévoir seuls. L'avenir de l'IA multilingue ne reposera pas sur un seul modèle géant, mais sur un écosystème dynamique composé de nombreux modèles, façonnés par de nombreuses voix.
Une famille de modèles spécialisés
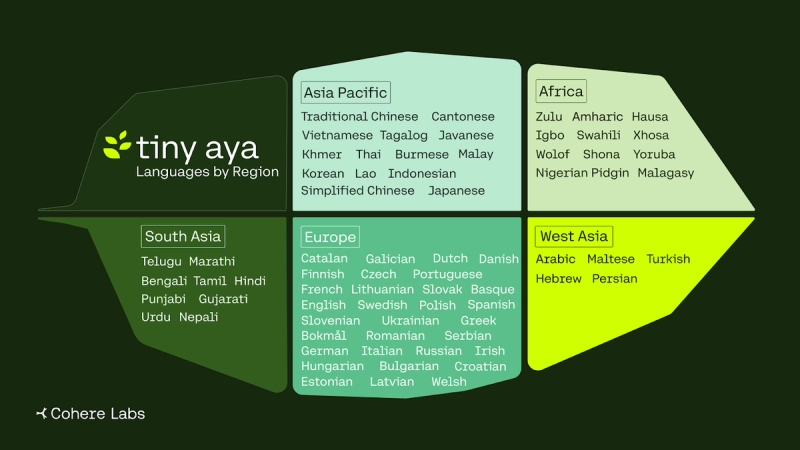
Tiny Aya repose sur une base multilingue commune qui permet l'apprentissage interlinguistique dans plus de 70 langues. Sur cette base, nous avons exploré comment améliorer les performances au sein d'écosystèmes linguistiques spécifiques sans sacrifier les capacités multilingues globales.
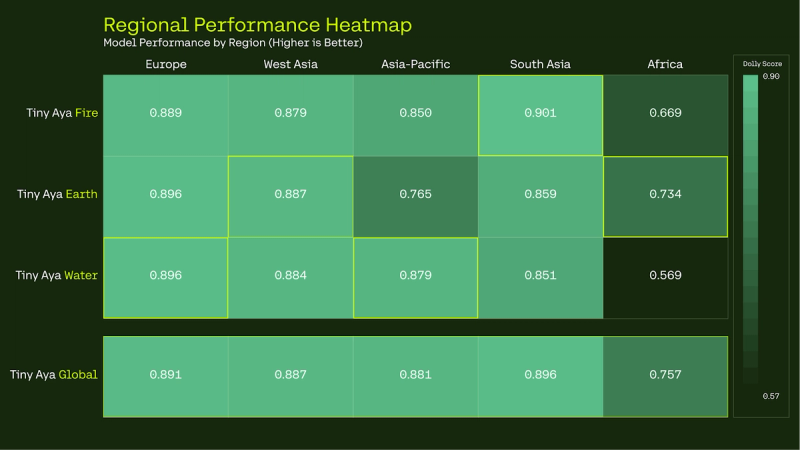
TinyAya-base offre une base multilingue cohérente à l'échelle mondiale. Les variantes spécialisées étendent cette base en se concentrant plus spécifiquement sur certaines communautés linguistiques, notamment en Afrique, en Asie du Sud et dans la région Asie-Pacifique, tout en conservant d'excellentes performances en dehors de leur zone principale.
Cette approche permet à chaque modèle de développer une meilleure maîtrise linguistique et une plus grande finesse culturelle, créant ainsi des systèmes qui semblent plus naturels et fiables pour les communautés qu'ils sont destinés à servir. Parallèlement, tous les modèles Tiny Aya conservent une large couverture multilingue, ce qui en fait des points de départ flexibles pour toute adaptation ou recherche ultérieure.
Le résultat est une famille de modèles coordonnée composée de variantes spécialisées par région :
- TinyAya-Earth : le plus performant pour les langues d'Afrique et d'Asie occidentale.
- TinyAya-Fire : le plus performant pour les langues d'Asie du Sud.
- TinyAya-Water : le plus performant pour la région Asie-Pacifique et l'Europe.
Ensemble, ces modèles offrent à la fois une option équilibrée à l'échelle mondiale et des variantes ciblées par région, permettant aux chercheurs et aux développeurs de choisir le niveau de couverture adapté à leurs besoins.
Essayez Tiny Aya dès maintenant
Tiny Aya est disponible dès aujourd'hui en tant que modèles à poids ouverts. Vous pouvez explorer et utiliser la famille de modèles Tiny Aya de plusieurs façons :
- Essayez-le instantanément sur Hugging Face Space ou sur la plateforme Cohere.
- Téléchargez les poids sur Hugging Face et Kaggle pour un déploiement local et un usage en recherche.
- Pour en savoir plus, consultez notre rapport technique détaillé qui décrit la stratégie d'entraînement, les évaluations complètes et les choix de conception à l'origine de Tiny Aya.
- Prêt à développer avec Tiny Aya ? En savoir plus sur Expedition Tiny Aya : un défi de recherche en plusieurs phases, accompagné par des mentors, conçu pour stimuler de nouveaux projets utilisant la famille de modèles Tiny Aya.
*TinyAya-Base prend en charge plus de 70 langues, notamment : l'amharique, l'arabe, le basque, le bengali, le bulgare, le birman, le cantonais, le catalan, le chinois (simplifié et traditionnel), le croate, le tchèque, le danois, le néerlandais, l'anglais, l'estonien, le finnois, le français, le galicien, l'allemand, le grec, le gujarati, le haoussa, l'hébreu, l'hindi, le hongrois, l'igbo, l'indonésien, l'irlandais, l'italien, le japonais, le javanais, le khmer, le coréen, le lao, le letton, le lituanien, le malgache, le malais, le maltais, le marathi, le népalais, le pidgin nigérian, le norvégien (bokmål), le persan, le polonais, le portugais, le pendjabi, le roumain, le russe, le serbe, le shona, le slovaque, le slovène, l'espagnol, le swahili, le suédois, le tagalog, le tamoul, le télougou, le thaï, le turc, l'ukrainien, l'ourdou, le vietnamien, le gallois, le wolof, le xhosa, le yoruba et le zoulou.
Tiny Aya : allier extensibilité et profondeur multilingue (2026), par Alejandro R. Salamanca, Diana Abagyan, Daniel D’souza, Ammar Khairi, David Mora, Saurabh Dash, Viraat Aryabumi, Sara Rajaee, Mehrnaz Mofakhami, Ananya Sahu, Thomas Euyang, Brittawnya Prince, Madeline Smith, Hangyu Lin, Acyr Locatelli, Sara Hooker, Tom Kocmi, Aidan Gomez, Ivan Zhang, Phil Blunsom, Nick Frosst, Joelle Pineau, Beyza Ermis, Ahmet Üstün, Julia Kreutzer, Marzieh Fadaee. https://arxiv.org/abs/2603.11510