Aujourd’hui, Cohere For AI, la branche de recherche de Cohere, est fière d’annoncer Aya Expanse, une famille de modèles multilingues hautement performants qui excellent dans 23 langues et surpassent les autres principaux modèles à poids ouverts.
Nous lançons Aya Expanse sous forme de modèles à poids ouverts de 8 et 32 milliards de paramètres, disponibles sur Kaggle et Hugging Face, dans le cadre de notre engagement continu en faveur de la recherche multilingue et pour faire progresser l’IA multilingue. Le modèle de 8 milliards de paramètres rend les avancées plus accessibles aux chercheurs du monde entier, tandis que notre modèle de 32 milliards de paramètres offre des capacités multilingues de pointe.
Aya Expanse représente une étape importante pour élargir la couverture linguistique de haute qualité dans les LLM. Depuis le lancement de l’initiative Aya il y a deux ans, nous avons collaboré avec plus de 3 000 chercheurs issus de 119 pays pour faire progresser la recherche multilingue de pointe. Cela a inclus la publication de la collection Aya, la plus grande collection de jeux de données multilingues à ce jour, avec 513 millions d’exemples, ainsi que des ensembles d’évaluation essentiels pour la performance multilingue et la sécurité. Cela a également inclus le lancement de Aya-101, le modèle multilingue le plus complet à ce jour, couvrant 101 langues.
Un coup de projecteur sur la recherche multilingue
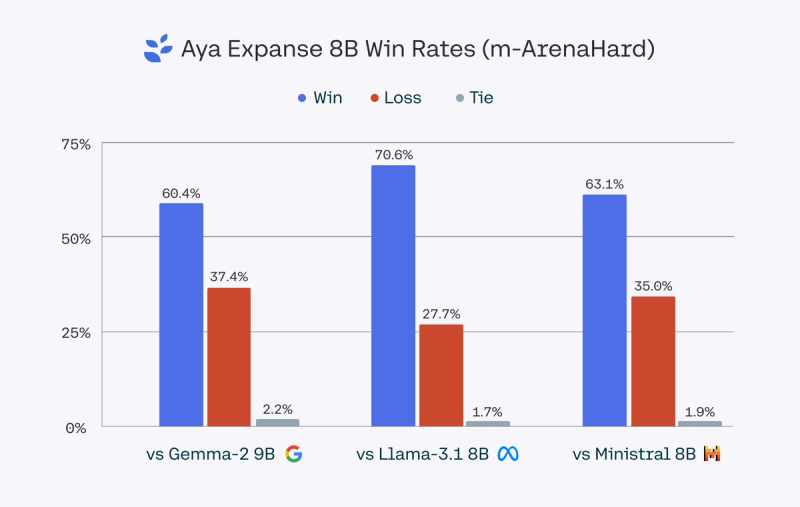
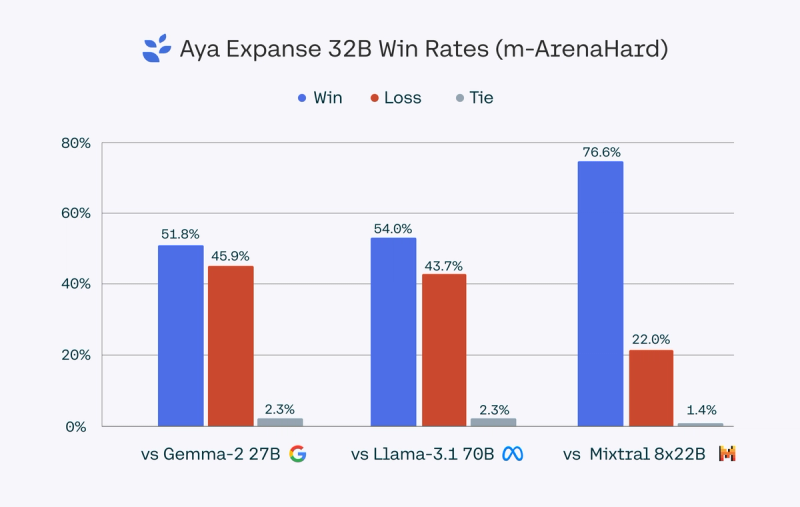
À plus grande échelle, Aya Expanse 32B surpasse Gemma 2 27B, Mistral 8x22B et Llama 3.1 70B, un modèle plus de deux fois plus volumineux, établissant ainsi un nouveau record en matière de performance multilingue. Nous avons également lancé Aya Expanse 8B, qui surpasse les principaux modèles à poids ouverts de sa catégorie, tels que Gemma 2 9B, Llama 3.1 8B et le récemment lancé Ministral 8B, avec des taux de réussite allant de 60,4 % à 70,6 %.
Les améliorations apportées à Aya Expanse sont le fruit d’un effort soutenu visant à élargir la manière dont l’IA sert les langues du monde entier, en repensant les éléments fondamentaux des avancées en matière d’apprentissage automatique. Notre programme de recherche des dernières années a inclus un accent particulier sur la réduction des disparités linguistiques, avec plusieurs percées essentielles à la méthode actuelle : l'arbitrage de données, l’entraînement basé sur les préférences pour améliorer les performances globales et la sécurité, et enfin la fusion de modèles. Ci-dessous, nous mettons en lumière ces travaux de recherche.
Améliorer les données synthétiques pour les langues disposant de peu de ressources. L’utilisation de données synthétiques – des données générées par un modèle expert ou « enseignant » pour entraîner un autre modèle – est devenue de plus en plus centrale dans le développement des LLM, notamment parce que l’entraînement des modèles a épuisé les sources de données disponibles. Cependant, pour les données multilingues, en particulier pour les langues peu dotées en ressources, il existe peu de bons exemples de modèles enseignants, ce qui constitue un défi supplémentaire pour l’exploitation des données synthétiques.
Nous avons proposé une nouvelle stratégie d’échantillonnage des données que nous appelons l'arbitrage de données afin d’éviter l’effondrement du mode de génération, ou la production de « charabia » en cas de dépendance excessive aux données synthétiques. L’arbitrage de données s’inspire de la façon dont les humains apprennent en faisant appel à différents enseignants pour différentes compétences. Si vous souhaitez apprendre à jouer du piano, vous ferez appel à un professeur de piano. Pour apprendre la pâtisserie, vous chercherez un expert en la matière. Nous appliquons la même philosophie à l’IA, en sélectionnant stratégiquement différents modèles « enseignants » en fonction de la distribution des données pour générer des données synthétiques adaptées aux capacités multilingues.
Orienter les modèles vers des préférences mondiales. L’entraînement basé sur les préférences est utilisé dans les dernières étapes de l’entraînement des modèles, en exploitant les retours des humains pour guider le modèle vers la production de résultats de haute qualité. Nous considérons cela comme la « touche finale » dans l’entraînement d’un modèle d’IA. Cependant, l’entraînement basé sur les préférences et les mesures de sécurité s’adaptent souvent trop étroitement aux problèmes prévalents dans les ensembles de données centrés sur l’Occident. De manière problématique, ces protocoles de sécurité échouent fréquemment à s’étendre aux contextes multilingues. Notre travail est l’un des premiers à étendre l’entraînement basé sur les préférences à un contexte massivement multilingue, en tenant compte des différentes perspectives culturelles et linguistiques. Nous constatons que cela entraîne des gains importants tant au niveau des performances globales que de la sécurité.
La fusion de modèles dans un monde diversifié. La dernière étape de notre percée en matière de performances multilingues réside dans nos travaux sur la fusion de modèles – la combinaison des poids de plusieurs modèles candidats à chaque étape pour créer davantage de polyvalence et de performance.
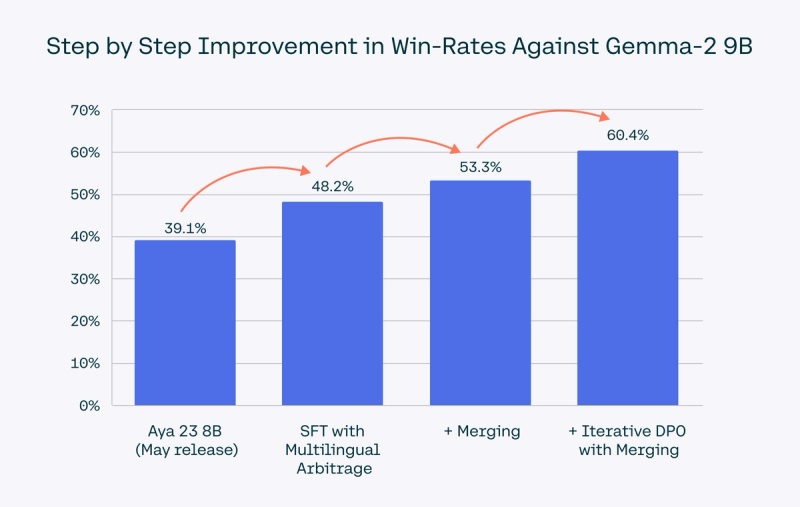
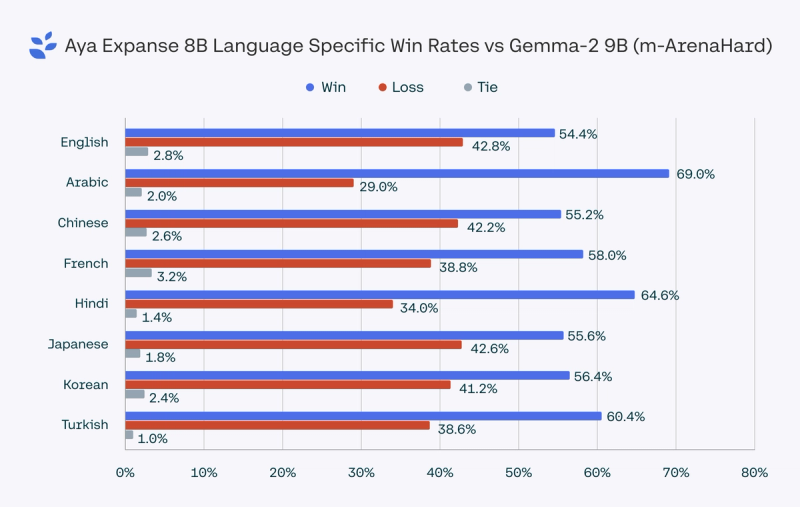
Nous combinons nos recherches pour créer le meilleur modèle multilingue de sa catégorie.Nous avons intégré toutes ces techniques dans une seule méthode d'entraînement pour Aya Expanse. Chacune de ces techniques – de l'arbitrage de données à la fusion et à l'optimisation des préférences multilingues – permet une amélioration progressive, aboutissant à un gain significatif par rapport aux autres modèles leaders dans les mêmes classes de paramètres. Face à Gemma 2 9B, Aya Expanse 8B atteint un taux de victoire de 60,4 %, ce qui représente une nouvelle avancée pour sa catégorie en matière de performance des LLM multilingues.
Atteindre l'état de l'art en matière de multilinguisme.
Chaque avancée algorithmique que nous avons développée au cours de l'année et intégrée dans Aya Expanse évolue avec l'augmentation de la taille du modèle et permet d'atteindre des performances de pointe. En exploitant ce potentiel, nous avons utilisé la même méthode d'entraînement combinant arbitrage de données, entraînement basé sur les préférences et fusion. Tout comme pour notre modèle plus petit, cette approche conduit à une amélioration significative des performances. Aya Expanse 32B surpasse Gemma 2 27B, Mistral 8x22B et le bien plus grand Llama 3.1 70B, avec des taux de victoire par paire allant de 51,8 % à 76,6 % au total dans 23 langues.
Ces résultats illustrent l'impact de nos recherches sur le multilinguisme, au-delà des petits modèles linguistiques, marquant ainsi un nouveau standard de performance multilingue à grande échelle.
Participez
En plus de la publication des poids ouverts pour les modèles de 8 et 35 milliards de paramètres, nous collaborons activement avec l'ensemble de l'écosystème de recherche pour accélérer l'IA multilingue. Postulez à l'une de nos bourses de recherche ici, ou rejoignez notre prochaine cohorte de recherche où nous fournissons des ressources de calcul et une expertise pour favoriser la collaboration interinstitutionnelle.
Aya s'inscrit dans notre engagement continu en faveur d'une meilleure performance et d'une plus grande sécurité multilingues. Découvrez-en plus sur nos recherches ici, et envisagez de nous rejoindre.
Les modèles Aya Expanse sont dès aujourd'hui disponibles pour les chercheuses et chercheurs ainsi que pour les développeuses et développeurs sur la plateforme API de Cohere, Kaggle, et Hugging Face.
Remerciements
Ce travail est le fruit d'un effort considérable fourni par les équipes de Cohere For AI et de Cohere. Nous tenons également à exprimer notre profonde gratitude à notre communauté de recherche – les 220 ambassadeurs linguistiques du monde entier qui ont contribué à cette publication. Ils sont listés ci-dessous par ordre alphabétique :
Mehmet Emre Akbulut (turc/Turquie), Samer Attrah (néerlandais, arabe/Pays-Bas), MUHDIN AWOL (anglais/Éthiopie), Kenza Benkirane (arabe, français/Maroc), Mann Bhanushali (hindi, anglais/Inde), Isabella Bicalho Frazeto (français, portugais/Brésil, France), Danylo Boiko (ukrainien/Ukraine), Sabrina Boumaiza (arabe/Algérie), Samuel Cahyawijaya (indonésien/Indonésie), Samuel Cahyawijaya (indonésien, anglais/Indonésie), Emirhan Çelik (turc/Turquie), Ryan Chan (italien, anglais/Royaume-Uni), Aurélien-Morgan CLAUDON (français/France), Urszula Czerwinska (polonais, français/France, Pologne), Joana da Matta (portugais/Brésil), Nguyễn Đạt (vietnamien/Vietnam), Manasvi Dawane (hindi/Inde), Akanksha Devkar (hindi/Inde), Sharad Duwal (anglais/Népal), Abdeljalil EL MAJJODI (arabe/Maroc), Shafagh Fadaei (persan/Iran), Neil Fernandes (allemand, japonais, hindi/Canada), Silvia Fernandez (espagnol, anglais/Argentine), Hamidreza Ghader (persan, néerlandais/Iran, Pays-Bas), Manuel Goulão (portugais/Portugal), Bassam Gouti (arabe, dialecte tunisien/Tunisie), María Grandury (espagnol/Espagne), Miguel Guerrero (espagnol/Espagne), Siddhesh Gunjal (hindi/Inde), Mohammed Hamdy (arabe, anglais/Égypte), Hafedh Hichri (arabe, français/Tunisie), Nhu Hoang Anh Quynh (japonais, vietnamien/Japon, Vietnam), Kyle Howard (anglais, espagnol/États-Unis), Jiwung Hyun (coréen/Corée du Sud), Joseph Marvin Imperial (philippin/Philippines), Burin Intachuen (japonais/Japon), Ryan Junejo (anglais, hindi/Canada), Juan Junqueras (espagnol/Argentine), Karthik Reddy Kanjula (anglais, hindi/États-Unis, Inde), Albert Kao (chinois/Taïwan), Morteza Kashani (persan/Iran), Ahmed Khaled (arabe/Égypte), Niharika Khanna (hindi, pendjabi/Inde), Dipika Khullar (hindi/États-Unis, Inde), Christopher Klamm (allemand/Allemagne), Nazar Kohut (ukrainien/Ukraine), Alkis Koudounas (italien, grec/Italie, Grèce), Diana Kozachek (allemand, ukrainien/Allemagne), Katrina Lawrence (anglais, français, allemand/Canada), James León (espagnol/Équateur), Jiazheng Li (chinois/Chine, Royaume-Uni), Nicolò Loddo (italien/Italie), Dante, Fu On Lok (chinois, anglais/Hong Kong), Iro Malta (grec, allemand/Grèce, Allemagne), Harras Mansoor (ourdou/Pakistan), Bhavnick Minhas (hindi/Inde), Shachar Mirkin (hébreu), Roa’a Mohammad (arabe/Jordanie), Yiyang Nan (chinois/Chine), Sree Harsha Nelaturu (hindi, allemand/Inde, Allemagne), Jekaterina Novikova (anglais, russe/Canada), Roni Obaid (arabe, anglais/Syrie), Olympiah Otieno (anglais/Kenya), Enes Özgözler (turc/Turquie), Yavuz Alp Sencer Ozturk (turc/Turquie), Carlos Patiño (espagnol/Colombie), Jebish Purbey (anglais, hindi/Népal), Maria Quijano Jesurum (espagnol/Colombie), Swati Rajwal (hindi, anglais/États-Unis), Didi Ramsaran Chin (espagnol, anglais/Venezuela), Divyaraj Rana (hindi, anglais/États-Unis), Aditya Retnanto (indonésien/Indonésie), Rodrigo Ribeiro Gomes (portugais/Brésil), Esra'a Saleh (anglais, arabe/Canada), Roshan Santhosh (hindi/Inde, États-Unis), Drishti Sharma (hindi, espagnol/Inde, Espagne, pays d'Amérique latine), Kinza Sheikh (ourdou/Pakistan), Aditya Shrivastava (hindi, anglais/Inde, Irlande), Vivek Silimkhan (hindi, anglais/Inde), Marjana Skenduli (anglais, italien/Albanie), Soham Sonar (hindi, marathi/Inde), Gürkan Soykan (turc/Turquie), David Styveen (portugais/Brésil), Anthony Susevski (anglais/Canada), Adrian Szymczak (polonais/Pologne), Joanne Tan (anglais, chinois mandarin/Singapour), Quentin Tardif (français/France), Ameed Taylor (anglais, allemand/États-Unis, Allemagne), Yiorgos Tsalikidis (grec/Grèce), Roman Tymtsiv (ukrainien/Ukraine), Muhammad Saad Uddin (allemand/Allemagne), Louis Ulmer (français/France), Sundar Sripada V. S. (anglais/États-Unis), Freddie Vargus (anglais, espagnol/États-Unis), Vlad Vasilescu (roumain/Roumanie), Karan Verma (anglais, hindi/Inde), Henry Vo (vietnamien/Vietnam), Minh Chien Vu (japonais, vietnamien/Japon, Vietnam), Hieu Vu (vietnamien/Vietnam), Azmine Toushik Wasi (anglais, hindi, arabe, espagnol/Bangladesh), Warren Williams (anglais/États-Unis), Joseph Wilson (français/Canada), Gusti Winata (indonésien/Indonésie), Ege Yakut (turc, anglais/Turquie), Eray Yapağcı (turc/Turquie), Taha Yassine (arabe, français/Maroc), Serhan YILMAZ (turc/Turquie), Hanna Yukhymenko (ukrainien/Ukraine), Mike Zhang (néerlandais/Pays-Bas).