









오늘, 저희는 기업용 추론 작업에 최적화된 최첨단 모델인 Command A Reasoning을 소개합니다. 에이전트 기반 워크플로우부터 엔드투엔드 시스템에 이르기까지, 이 모델은 gpt-oss-120b, DeepSeek-R1 0528, Mistral Magistral Medium을 포함한 동급의 주요 온프레미스 배포 모델들을 능가하는 성능을 제공합니다.
Command A Reasoning은 기업 요구사항에 맞춰 특별히 설계되어 매우 안전하고 효율적이며 확장 가능한 배포 옵션을 제공합니다. 리소스 사용량이 적은 환경에서는 단일 H100 또는 A100에서 컨텍스트 길이 128k로 실행 가능하며, 2개 이상의 GPU를 사용하여 지연 시간을 최적화한 배포 환경에서는 컨텍스트 길이가 256k까지 확장됩니다. 이러한 유연한 구성 덕분에 기업은 보유한 하드웨어를 최대한 활용할 수 있습니다. 이 모델의 긴 컨텍스트 길이는 문서 중심의 워크플로우와 복잡한 다단계 에이전트 유스케이스에 이상적입니다.
고객은 토큰 할당량을 설정하여 컴퓨팅 사용량을 직접 관리하고 비용을 제어할 수 있습니다. Command A Reasoning은 최대 정확도가 필요한 작업에 사용하거나, 효율성이 최우선일 때는 더 빠른 속도와 처리량을 위해 설정할 수 있으므로, 추론 전용 모델과 일반 모델을 별도로 유지할 필요가 없습니다.
Command A Reasoning은 저희의 안전한 에이전트 기반 AI 플랫폼인 North의 핵심 생성 모델입니다. 이를 통해 기업은 저희의 가장 강력한 추론 모델을 기반으로 맞춤형 AI 에이전트와 자동화 솔루션을 온프레미스에 배포할 수 있습니다.
기업용 추론 작업 전반에 걸친 강력한 성능
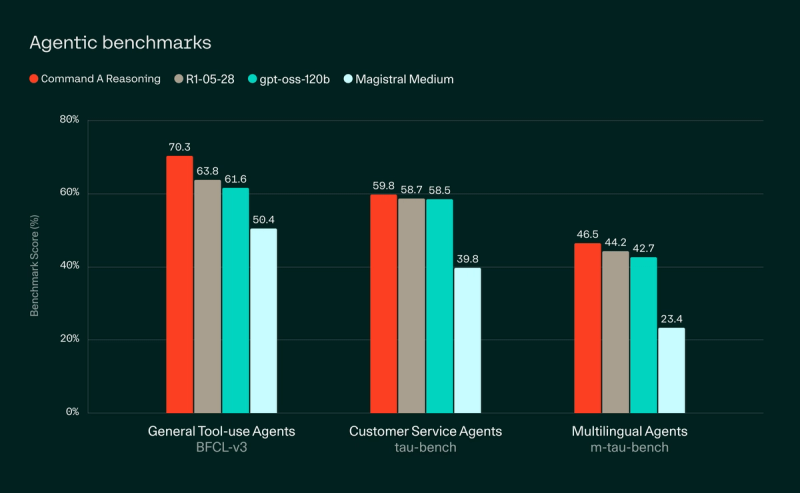
에이전트 및 다국어 추론 벤치마크 결과
Command A Reasoning은 주요 에이전트 벤치마크에서 최상위 수준의 결과를 보여줍니다. 또한 다양한 주요 비즈니스 언어에서도 뛰어난 성능을 발휘하여, 글로벌 기업이 일관된 품질의 에이전트를 활용할 수 있도록 지원합니다.
탁월한 딥 리서치 에이전트 성능
Command A Reasoning은 체이닝 및 계층적 에이전트가 포함된 엔드투엔드 시스템을 구동하고, 작업을 완수하기 위해 가장 적합한 도구를 활용하는 데 탁월한 성능을 발휘합니다. 대표적인 예로, 저희의 Deep Research 시스템은 다른 모든 주요 AI 연구소의 유사 기능보다 뛰어난 성능을 보여줍니다.
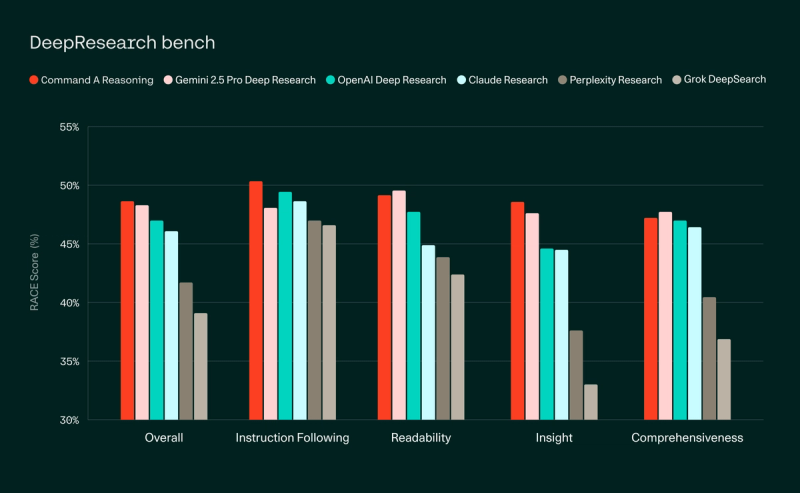
딥 리서치는 단순한 검색 이상의 심층적인 분석이 필요한 복잡한 질문에 대응하도록 설계되었습니다. 일반적으로 직원이 수행하는 데 수 시간이 걸리는 작업을 단 몇 분 만에 상세하고 근거가 명확한 보고서로 제공합니다. 당사의 시스템은 Command A Reasoning 기반의 멀티 에이전트 아키텍처를 사용하여 사용자 요청을 더 작은 리서치 주제로 세분화합니다. 이후 여러 AI 에이전트가 병렬로 작동하며 다양한 소스에서 정보를 검색하고 분석합니다. 마지막으로, 시스템은 검증된 결과를 통합하여 사용자의 원래 요청에 직접적으로 답하는 잘 구조화된 단일 보고서로 작성합니다. 딥 리서치는 곧 North에서 제공될 예정입니다.North.
Cohere의 대표 엔터프라이즈 AI 플랫폼인 North의 핵심 엔진
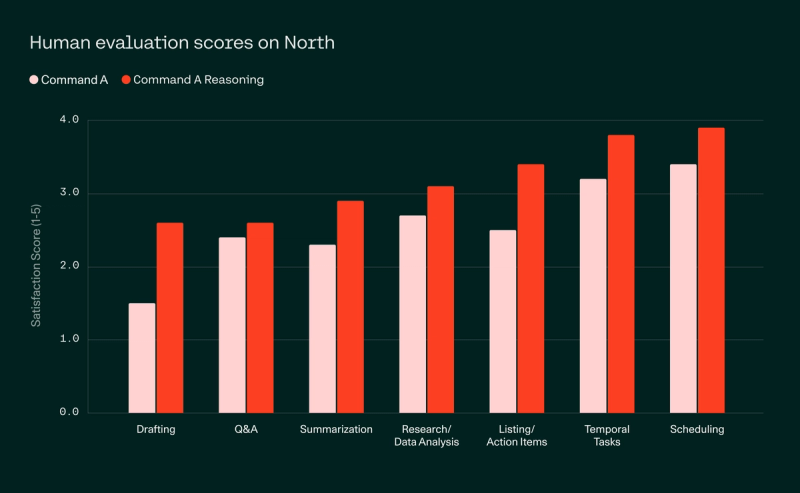
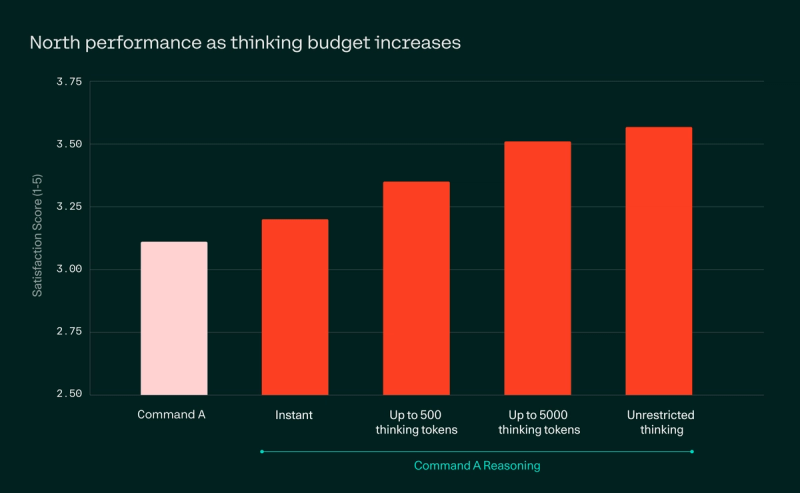
North는 데이터 보안을 중시하는 기업이 자체 인프라 내에서 AI 에이전트와 자동화 솔루션을 대규모로 구축할 수 있도록 지원합니다. 업무상 대표적인 일일 작업 세트에 대한 인간 평가 점수에서 Command A Reasoning은 Command A보다 일관되게 우수한 성능을 보입니다. 고객 입장에서는 이러한 성능 향상이 더 신뢰할 수 있는 에이전트, 수동 개입 감소, 그리고 매우 정확하고 실행 가능한 결과 도출로 이어집니다.
엔터프라이즈 규모에 필요한 제어 및 효율성
Command A Reasoning은 강력한 성능, 높은 정확도, 확장 가능한 효율성을 결합하여 다양한 산업 분야의 비즈니스 애플리케이션을 가능하게 합니다. 낮은 하드웨어 요구 사항 덕분에 단일 H100 또는 A100 환경에서도 프라이빗 배포가 가능합니다.
이 모델은 사용자가 토큰 예산을 직접 제어함으로써 컴퓨팅 리소스 사용량과 비용을 최적화하며, 미션 크리티컬한 정밀 작업과 고처리량 작업 간의 원활한 조정이 가능합니다. 이를 통해 추론 전용 모델과 일반 모델을 별도로 운영할 필요가 없어져, 기업이 GPU 효율성을 극대화하고 리소스를 동적으로 할당할 수 있습니다.
North의 내부 평가 결과, 추론 예산 설정을 조정함에 따라 추론이 없는 효율적인 응답부터 높은 추론 수준의 심층적인 응답까지 성능이 점진적으로 향상되는 것으로 나타났습니다. 추론을 사용하지 않는 설정에서도 Command A Reasoning은 Command A보다 우수한 성능을 보입니다.
중요도가 높은 환경에서도 안전한 성능 제공
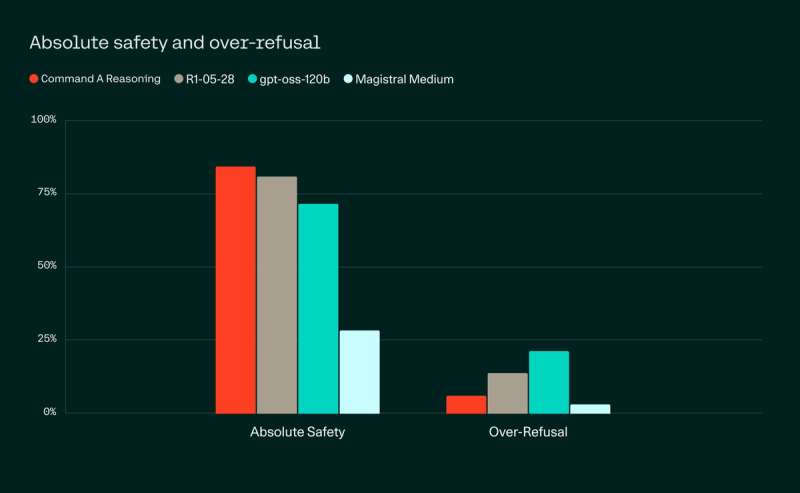
안전성은 Command A Reasoning을 포함한 모든 모델의 학습 및 평가 방식의 핵심입니다. 이는 모델이 정당한 요청을 과도하게 거부하지 않으면서도, 온라인상에서 유해하고 악의적인 콘텐츠의 의도적인 확산을 방지하는 최적의 균형을 맞추는 것을 의미합니다. 당사는 아동 성착취 및 학대(CSEA), 자해, 폭력 및 혐오 표현, 성적 콘텐츠, 음모론 등 5가지 핵심 영역에 집중하고 있습니다.
가용성
Command A Reasoning은 현재 Cohere 플랫폼에서 이용 가능하며, 연구 목적으로는 Hugging Face에서 사용할 수 있습니다. 프라이빗 또는 온프레미스 배포에 관심이 있으신 경우, 맞춤형 가격 안내를 위해 영업팀에 문의하시기 바랍니다.
“Cohere와 협력하여 SAP Business Technology Platform의 생성형 AI 허브에 Command A Reasoning 모델을 통합하게 되어 매우 기쁩니다. 이 강력한 모델은 SAP의 생성형 AI 역량을 강화하여, 고객, 파트너 및 개발자가 각자의 고유한 환경에 맞춘 혁신적이고 안전한 에이전트 애플리케이션을 구축할 수 있도록 지원할 것입니다. 양사는 협력을 통해 기업용 추론 작업의 새로운 가능성을 열어갈 것입니다.” — Dr. Walter Sun, SAP SE AI 부문 수석 부사장 겸 글로벌 책임자
[1]모든 모델은 사용 가능한 최고 수준의 추론 설정으로 실행합니다.
BFCL의 경우, Command-R-Reasoning에 대해 함수 호출(FC) 설정을 사용하여 평가합니다. 경쟁 모델의 경우, 공식 BFCL 리더보드에 점수가 게시되어 있다면 해당 점수를 보고하며, 그렇지 않은 경우 공식 BFCL 코드베이스를 사용하여 벤치마크를 수행하고 프롬프트 기반 평가 및 FC 평가 설정 중 더 높은 점수를 보고합니다.
Taubench의 경우, Command-R-Reasoning에 대해 10회 실행 결과의 pass@1 점수 평균을 보고합니다. 경쟁 모델의 경우, 공식적으로 발표된 수치가 있다면 이를 사용하며(R1-0528, GPT-oss), 그렇지 않은 경우 공식 tau-bench 구현 환경에서 tool-use API를 실행하여 10회 실행 결과의 pass@1 평균을 보고합니다. 모든 경우 항공 및 리테일 분야의 평균 점수를 보고합니다.
M-taubench의 경우, 모든 모델을 실행하여 일본어, 한국어, 아랍어, 스페인어, 프랑스어, 영어로 된 리테일 및 항공 분야 테스트를 10회 수행하고 평균 점수를 보고합니다.
[2]당사의 딥 리서치 에이전트는 계층적 웹 검색 에이전트로, 문제를 여러 하위 문제로 분해하고 하위 에이전트를 통해 각 문제를 재귀적으로 조사합니다. 모든 하위 에이전트의 작업이 완료되면 각 하위 보고서를 취합하여 여러 단계의 반복적 개선 과정을 거쳐 최종 보고서를 생성함으로써 보고서의 완성도를 높입니다. 당사는 검색, Rerank, 검색 증강 생성(RAG) 및 에이전트 분야의 전문성을 활용하여 자체 개발한 에이전트와 웹 검색 기술을 사용합니다. 경쟁 모델의 경우, DeepResearchBench 리더보드 웹사이트에서 공식 RACE 평가를 다시 실행하여 영어 질문 세트에 대한 RACE 점수를 보고합니다.
[3]평가자들은 당사가 자체 개발한 종합 평가 기준에 따라 응답의 품질, 적절성, 정확성 및 지연 시간 등의 측면을 종합적으로 고려하여 만족도 점수를 매겼습니다. 전체 평가 세트는 112개의 질문으로 구성되며, 각 답변은 6명의 평가자가 주석을 달고 점수를 합산합니다.
[4]이 평가는 알려진 정답 참조 데이터에 대해 LlamaIndex를 활용하여 자동 정확도 점수를 산출합니다.


