









오늘 저희는 빠르고 안전하며 고품질의 AI를 필요로 하는 까다로운 기업 환경에 최적화된 최첨단 생성형 모델인 Command A를 소개합니다. Command A는 GPT-4o 및 DeepSeek-V3와 같은 주요 상용 및 오픈 웨이트 모델과 비교했을 때, 최소한의 하드웨어 비용으로 최대 성능을 제공합니다. 프라이빗 배포 환경에서 Command A는 비즈니스 핵심 에이전트 작업 및 다국어 작업에서 탁월한 성능을 발휘하며, 일반적으로 32개의 GPU가 필요한 다른 모델들과 달리 단 2개의 GPU만으로 배포가 가능합니다.
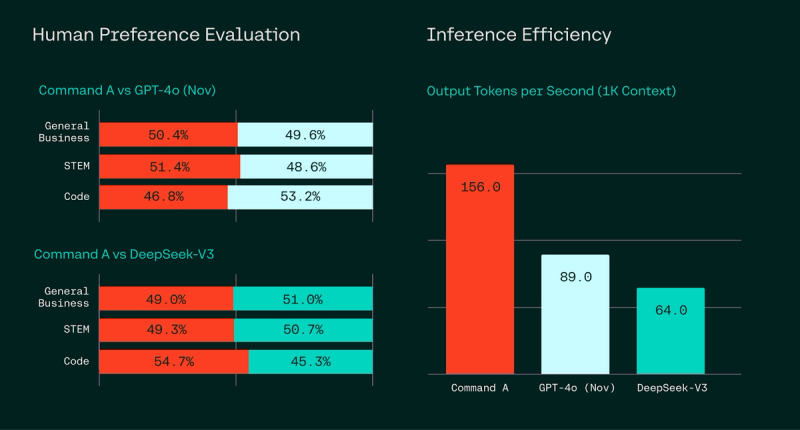
비즈니스, STEM 및 코딩 작업에 대한 직접적인 인간 평가를 실시한 결과, Command A는 더 크고 느린 경쟁 모델들과 대등하거나 그 이상의 성능을 보여주었으며, 동시에 더 뛰어난 처리량과 효율성을 제공합니다. 실제 기업 데이터와 상황을 기반으로 테스트하는 인간 평가는 매우 중요한 의미를 갖습니다.
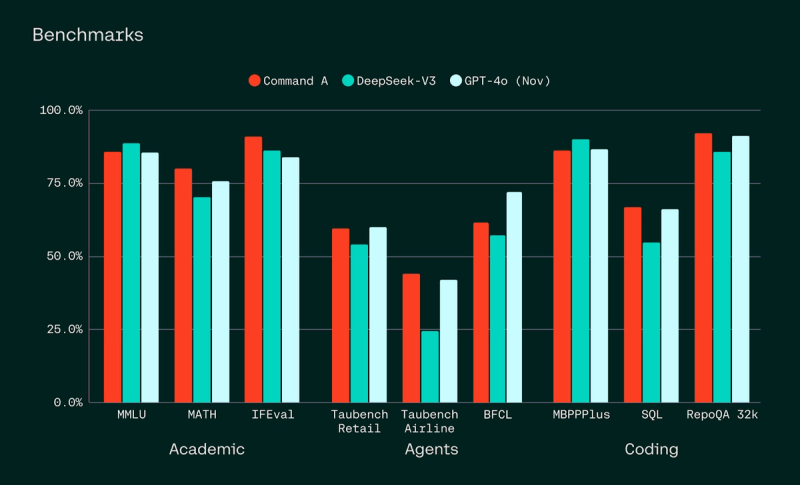
다양한 표준 벤치마크에서 Command A는 지시 준수, SQL, 에이전트 및 툴 작업에서 강력한 성능을 제공합니다.
확장 가능한 효율성
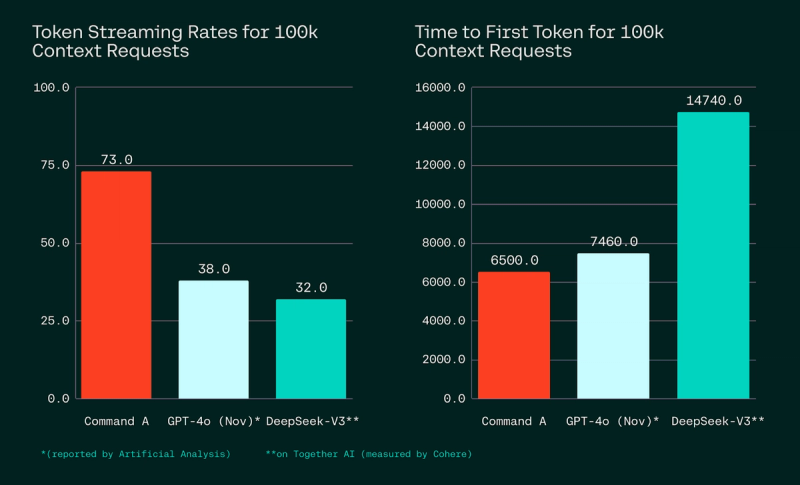
저희는 Command A를 최대한 효율적으로 구축하는 동시에, 프로덕션 환경에서 서비스할 때도 최대한 효율적으로 운영할 수 있도록 하는 데 집중했습니다. 단 2개의 A100 또는 H100만으로도 구동이 가능하여, 시장에 출시된 다른 유사 모델들보다 훨씬 적은 컴퓨팅 자원을 필요로 합니다. 이는 특히 프라이빗 배포 환경에서 매우 중요합니다.
지나치게 큰 모델은 지연 시간 증가로 인해 실용성이 떨어집니다. 단순히 빠르고 정확한 답을 원하신다면 Command A가 최선의 선택입니다. 실제로 Command A는 초당 최대 156토큰까지 생성할 수 있으며, 이는 GPT-4o보다 1.75배, DeepSeek-V3보다 2.4배 더 빠른 속도입니다. Command A의 프라이빗 배포는 API 기반 액세스보다 최대 50% 더 저렴할 수 있습니다.
엔터프라이즈급 기능
저희는 비즈니스 요구 사항을 고려하여 Command A를 설계했습니다. 256k의 컨텍스트 길이(대부분의 주요 모델보다 2배 길음)를 통해 훨씬 더 긴 기업용 문서를 처리할 수 있습니다. 다른 주요 기능으로는 검증 가능한 인용 출처를 갖춘 Cohere의 고급 검색 증강 생성(RAG), 에이전트 툴 활용, 엔터프라이즈급 보안 및 강력한 다국어 성능이 있습니다.
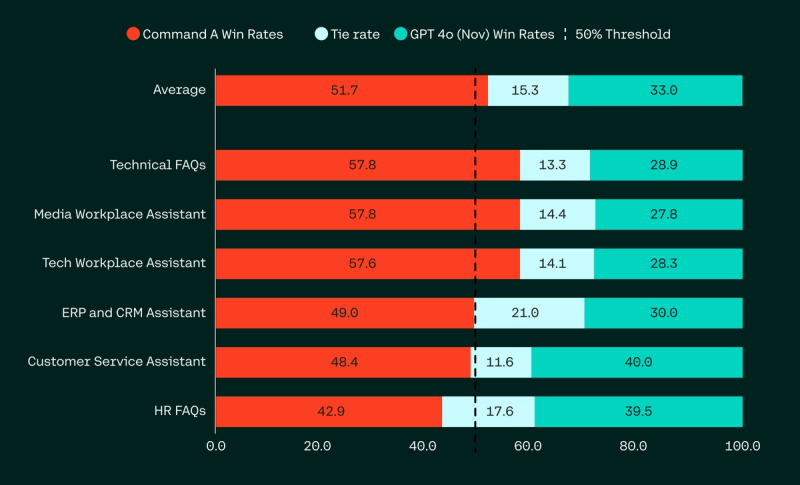
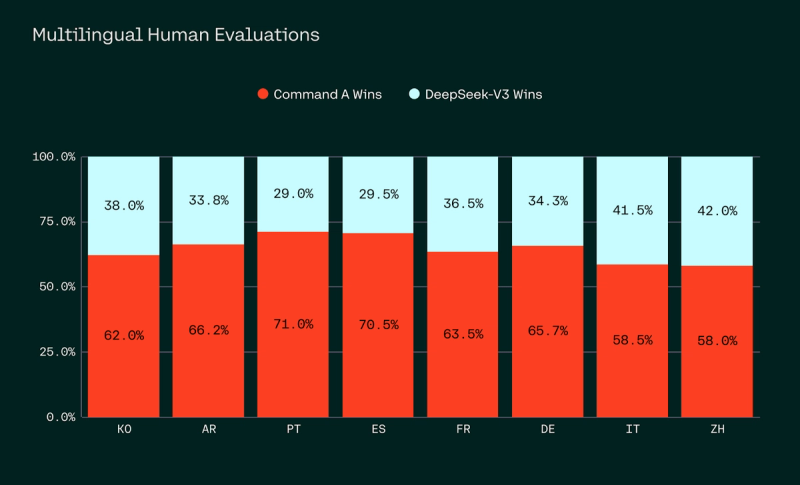
글로벌 기업들은 여러 지역에 걸친 기능이 필요하다는 점을 잘 알고 있습니다. Command A는 전 세계 인구의 대다수가 사용하는 23개 언어에 대해 확장된 엔터프라이즈급 지원을 제공합니다. 저희는 광범위한 인간 평가를 실시했으며, 다양한 비즈니스 유스케이스에서 대부분의 언어에 걸쳐 사용자들이 DeepSeek-V3보다 Command A를 훨씬 더 선호한다는 것을 확인했습니다.
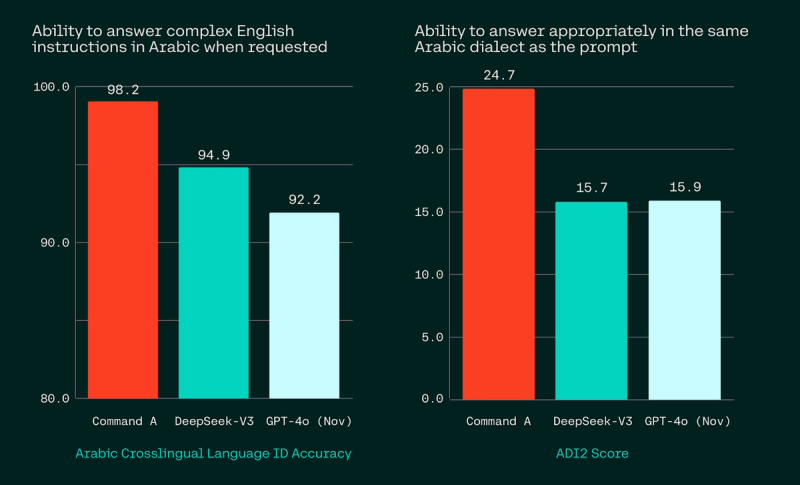
특히 Command A는 요청한 언어로 일관되게 답변하는 능력이 GPT-4o나 DeepSeek-V3보다 훨씬 뛰어나며, 예를 들어 사용자의 해당 아랍어 방언으로 답변할 수 있습니다.
대규모 AI 에이전트 구현 지원
AI의 성능은 입력되는 데이터의 품질에 달려 있습니다. 이를 바탕으로 Command A는 기업 내부 정보를 기반으로 질문에 대한 정확한 답변을 안전하게 제공합니다. 실제로 고객들은 이를 통해 사무소 위치별 관련 HR 정책 확인, 법적 규제 검토, 긴 재무 보고서 분석과 같은 작업에 활용하고 있습니다.
차세대 Cohere 모델은 금융, 헬스케어·생명 과학, 제조, 에너지·유틸리티 및 공공 부문을 포함한 다양한 산업 분야의 고객을 위한 여러 AI 애플리케이션 구현을 지원할 예정입니다. 특히, 이 모델들은 다음과 원활하게 통합됩니다:North
North는 CRM 및 ERP 소프트웨어와 같은 기업용 도구를 안전하게 활용하며, 기업 내부 데이터베이스 및 외부 웹 검색 서비스와도 연결됩니다. 이를 통해 기업 시스템의 보안 방화벽 뒤에서 사용자를 대신해 작업을 수행하는 에이전트를 구축할 수 있습니다.
이용 가능 여부
Command A는 현재 Cohere 플랫폼에서 이용 가능하며, Hugging Face에서는 연구용으로 사용할 수 있습니다. 또한 주요 클라우드 제공업체에서도 곧 제공될 예정입니다. 프라이빗 또는 온프레미스 배포에 관심이 있으신 경우 영업팀에 문의하시기 바랍니다.
[1]BFCL: 2025년 3월 12일 기준 BFCL-v3 벤치마크 성능입니다. 공개 리더보드에 점수가 있는 경우 해당 점수를 사용하며, 그렇지 않은 경우 공식 코드베이스를 활용한 내부 평가로 최선을 다해 측정했습니다. 경쟁 모델의 경우, BFCL '프롬프트' 또는 '함수 호출' 점수 중 더 높은 점수를 기재했습니다. 다양한 실제 환경에서 도구 활용 능력을 테스트하는 종합 점수를 기준으로 합니다.
Taubench: Taubench 벤치마크 성능입니다. 공개 저장소 리더보드에 점수가 있는 경우 해당 점수를 사용하며, 그렇지 않은 경우 공식 코드베이스를 활용한 내부 평가로 최선을 다해 측정했습니다. 다단계 고객 지원 시나리오에서 도구 활용 에이전트의 성능을 평가하는 Retail 및 Airline 태스크의 pass@1 점수를 기재했습니다.
Academic: 일반 지식(MMLU), 수학 성능(MATH), 명령 수행 능력(IFEval)을 아우르는 학술 벤치마크 전반의 성능입니다. Command-A는 GPT-4o 및 DeepSeek-V3와 유사한 수준이거나 그 이상의 성능을 보이는 것으로 나타났습니다.
Coding: Command-A는 SQL 벤치마크(BirdBench, Spider Dev, Spider Test 평균)에서 특히 뛰어난 성능을 보였으며, MBPPlus(Python 프로그래밍) 사용 사례에서는 GPT-4o와 유사한 수준을 기록했습니다. 마지막으로, 긴 컨텍스트에서의 저장소 수준 질의응답(RepoQA)에서도 우수한 성능을 보였습니다.


