









휴대전화에서도 로컬 실행이 가능할 만큼 강력하고 적응력이 뛰어나며 효율적인, 실제 사용 언어를 위해 설계된 오픈 웨이트 AI입니다.
오늘, Cohere의 연구 조직인 Cohere Labs는 Tiny Aya를 공개합니다. 이는 해당 규모에서 가장 뛰어난 다국어 오픈 웨이트 모델입니다. Tiny Aya는 최첨단 번역 품질, 강력한 다국어 이해 능력, 우수한 타겟 언어 응답 성능, 그리고 폭넓은 언어 커버리지를 제공하며, 일반 하드웨어나 휴대전화에서도 로컬 실행이 가능할 만큼 모델 크기가 작습니다. 실험의 장벽은 없으며, 어디서나 실행 가능한 강력한 모델 제품군을 제공합니다.
다국어 AI는 빠르게 발전해 왔지만, 성능과 사용성은 여전히 소수의 주요 언어와 대규모 인프라에 집중되어 있습니다. Tiny Aya는 효율적인 설계와 심층적인 다국어 연구를 결합하여, 배포 및 적응의 실용성을 유지하면서 모든 언어에 걸쳐 균형 잡힌 성능을 지원하는 차별화된 접근 방식을 취합니다. 수백 개의 언어에 걸쳐 표면적인 커버리지를 제공하는 대신, Tiny Aya는 의미 있는 다국어 심층성을 강조하여 연구자, 개발자 및 커뮤니티가 자신들만의 언어적, 문화적 맥락을 반영하는 AI를 구축할 수 있도록 지원합니다.
공개 내용
사전 학습된 33.5B 파라미터 모델인 TinyAya-Base:TinyAya-Base는 전 세계 다양한 저자원 언어를 포함하여 70개 이상의 언어*를 지원합니다.
강력한 지시 조정(Instruction-tuned) 다국어 모델인 TinyAya-Global:TinyAya-Base를 기반으로 구축된 TinyAya-Global은 지원되는 67개 언어 전반에 걸쳐 강력하고 균형 잡힌 성능을 제공합니다. 이는 진정한 다국어 시스템의 기본 모델로, 단일 배포 환경에서 다양한 언어 설정에 걸쳐 일관된 품질이 필요한 애플리케이션에 이상적입니다.
특수 목적 지시 조정 모델 제품군: TinyAya-Global과 더불어, 광범위한 다국어 능력을 유지하면서 특정 언어 권역 내의 성능을 심화한 특수 변형 모델들을 공개합니다. 이러한 구조는 범언어적 공유 학습과 타겟 지역 심화 학습을 결합하여, 연구자와 개발자가 다국어 AI를 배포하는 방식에 유연성을 제공합니다 (모델 변형 및 지역별 특화 세부 사항은 아래에 설명되어 있습니다).
새로운 대규모 다국어 미세 조정 데이터셋 및 벤치마크:다양한 도메인, 언어 및 태스크를 아우르는 이 리소스들은 체계적인 다국어 실험을 위한 기반을 제공하며, 재현 가능한 평가와 데이터 중심 학습 전략에 대한 지속적인 탐구를 가능하게 합니다.
상세 기술 보고서:Tiny Aya의 기반이 된 연구, 학습 전략 및 평가 인사이트를 공유합니다.
Tiny Aya는 다국어 시스템의 구축 및 공유 방식에 대한 관점의 변화를 보여줍니다. 효율적인 설계, 다국어 사전 학습 및 후학습에 대한 심층적인 연구, 그리고 초기 단계부터 언어적 다양성에 집중함으로써, Tiny Aya는 고품질 AI를 가장 필요로 하는 사람들, 즉 소외된 언어를 연구하는 연구자, 현지에서 솔루션을 개발하는 개발자, 그리고 스스로의 기준에 따라 기술을 발전시키는 커뮤니티에 더 가까이 다가가게 합니다. 예를 들어, 인도의 한 대학 연구실은 클라우드 API에 의존하지 않고도 교실이나 지역 사회 환경에서 오프라인 번역 도구 또는 AI 교육 도구로 Tiny Aya를 도입할 수 있습니다.
기술적 혁신
Tiny Aya는 다국어 모델이 어떻게 책임감 있게 확장될 수 있는지에 대한 Aya 이니셔티브의 수년간의 연구 성과를 바탕으로 합니다. 특히, 이 학습 방식은 다음과 같은 최근 연구 성과에 기반합니다: 토크나이제이션을 통한 언어 가소성 증대, 합성 데이터의 자연스러움 향상, 다양한 생성 결과의 스마트한 융합 및 병합 방법의 타겟팅 선택. 이러한 방법들은 언어적 뉘앙스를 보존하면서 언어별 구조를 강화하는 동시에 다국어 신호를 결합할 수 있게 해줍니다.
Tiny Aya의 또 다른 핵심 설계 원칙은 현실적인 컴퓨팅 예산 범위 내에서의 효율성입니다. 단일 64개 NVIDIA H100 GPU 클러스터에서 후학습을 완료함으로써, 세심한 다국어 데이터 설계와 학습 전략이 무분별한 규모 확장(Brute-force scaling)을 대체할 수 있음을 입증했습니다. 이러한 아이디어는 Tiny Aya의 초기 설계 단계부터 반영되어 토크나이저 설계, 데이터 구성, 그리고 언어 그룹별 특화 방식에 영향을 주었습니다.
Tiny Aya는 다국어 능력을 단일한 목표로 보는 관점에서 벗어나, 학습 과정에서 다양성을 보존하면서 효율적인 다운스트림 적응을 가능하게 하는 전략을 통합했습니다. 이러한 설계 덕분에 연구자들은 경직된 정렬이나 과도하게 특화된 후학습의 제약을 받지 않고 모델을 재구성할 수 있으며, 이를 통해 새로운 도메인, 신흥 언어, 또는 커뮤니티 기반 평가 프레임워크에 맞게 모델을 미세 조정하는 것이 더 쉬워졌습니다.
소형 모델, 강력한 성능
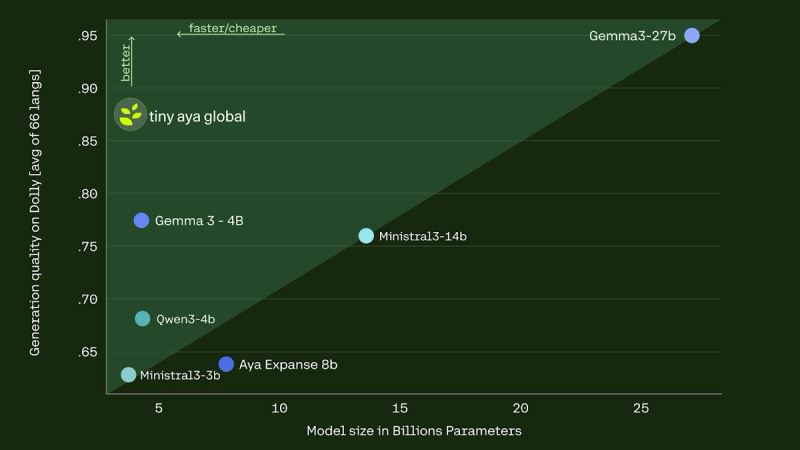
Tiny Aya를 개발할 때 우리는 더 넓은 목표를 염두에 두었습니다. 바로 로컬 환경에서도 충분히 효율적이면서도 다양한 언어에서 일관된 신뢰성을 유지하는 모델을 구축하는 것이었습니다. 그 결과, 번역, 자유형 생성 품질, 저자원 언어에 대한 수학적 추론 등 다양한 평가 항목에서 기존 다국어 모델과 견주어도 손색없는 모델 제품군이 탄생했습니다.
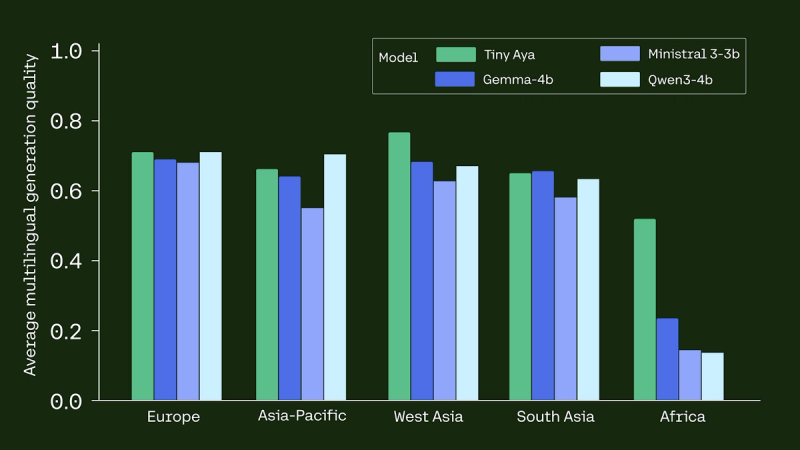
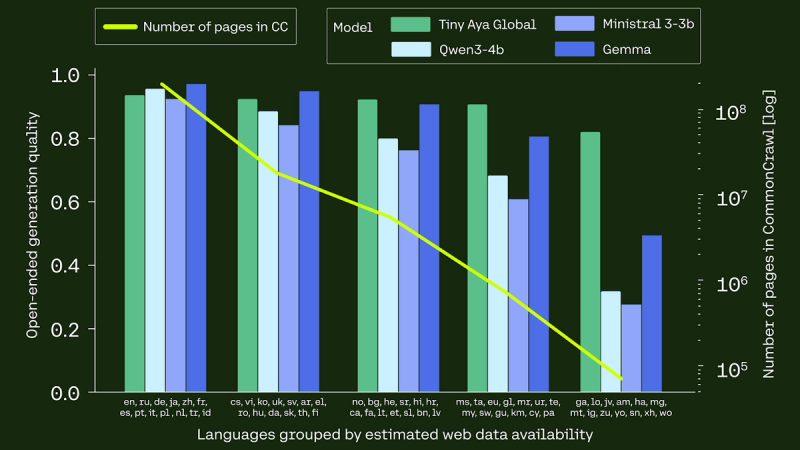
포괄적인 다국어 생성 벤치마크 테스트 결과, Tiny Aya는 해당 규모에서 선도적인 모델들과 어깨를 나란히 하며 모든 영역에서 성능을 향상시켰습니다. 특히 눈에 띄는 점은 Tiny Aya가 다양한 언어 환경에서 일관된 성능을 유지한다는 것입니다. 일부 주요 지표 점수만을 최적화하는 대신, 우리는 안정성, 폭넓은 지원 범위, 그리고 실제 사용 편의성에 집중했습니다. '무엇을' 구현하느냐만큼 '어떻게' 구현하느냐에도 신경을 썼으며, 이는 응답의 유창성과 일관성 등 원어민이 중요하게 생각하는 품질 요소들을 고려했음을 의미합니다. 단순 모델 규모만큼 효율성, 적응력, 언어 지원 범위가 중요한 실제 다국어 사용 환경에서 Tiny Aya는 동급 최고의 성능을 자랑하며, 성능과 접근성 사이의 최적의 균형을 제공합니다.
디자인 원칙으로서의 접근성
Tiny Aya는 사람들이 실제로 사용하는 환경, 즉 로컬 기기, 교실, 지역 커뮤니티 연구소, 그리고 대규모 인프라가 부족한 지역에서 실행되도록 설계되었습니다. 예를 들어, 클라우드 인프라와 멀리 떨어진 외딴 마을에서도 언어 간 번역이 가능하도록 말이죠. 진입 장벽을 낮춤으로써 더 많은 사람이 직접 다국어 AI를 구축하고, 실험하며, 그 미래를 만들어갈 수 있게 되었습니다.
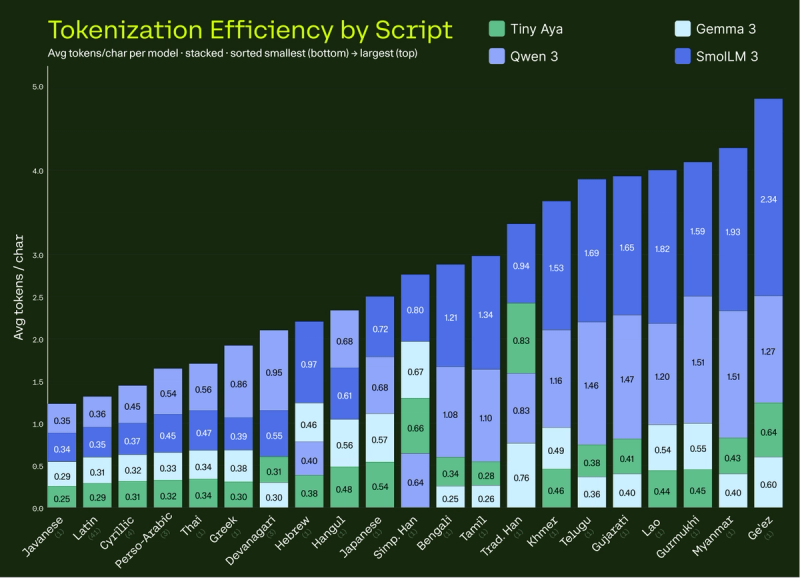
모델 크기 외에도, 접근성은 언어가 얼마나 효율적으로 표현되는지에 따라 달라집니다. Tiny Aya의 토크나이저는 다양한 문자 체계와 언어 구조에 걸쳐 토큰 분절을 최소화하도록 설계되어, 모든 언어에서 문장당 토큰 생성 수를 줄였습니다. 이러한 토큰화 효율성 향상은 추론 시 메모리 및 컴퓨팅 요구 사항을 낮춰, 로컬 하드웨어에서도 다국어 애플리케이션을 더 실용적으로 사용할 수 있게 하며, 실제 사용 환경에서의 응답성 또한 개선합니다.
우리는 이번 출시가 연구 커뮤니티 스스로가 만드는 전문 다국어 모델 생태계의 초석이 될 것이라 믿습니다. 전 세계 연구자와 개발자 여러분이 이 모델과 데이터셋을 활용해 자체적인 언어 특화 시스템을 구축하고, 지원 범위를 확장하며, 새로운 평가 전략을 탐구함으로써 우리가 혼자서는 예측할 수 없는 방향으로 다국어 AI를 발전시켜 나가기를 바랍니다. 다국어 AI의 미래는 단 하나의 거대한 모델이 아니라, 다양한 목소리에 의해 형성된 수많은 모델이 어우러진 활기찬 생태계가 될 것입니다.
전문 모델 제품군
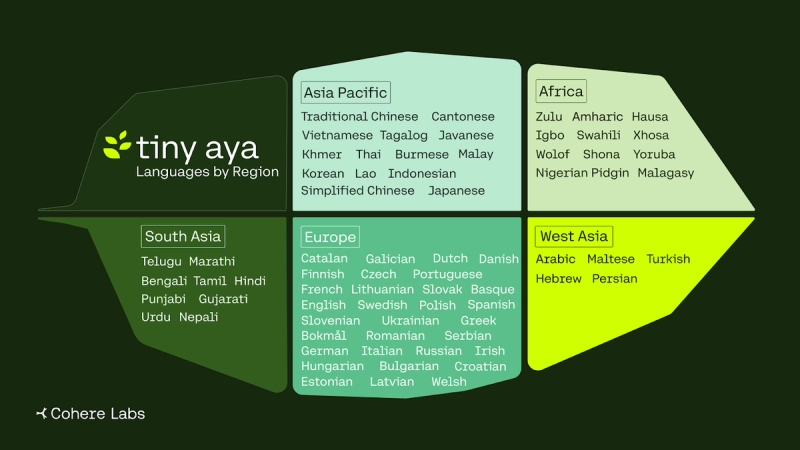
Tiny Aya는 70개 이상의 언어 간 학습을 가능하게 하는 공유 다국어 기반 기술 위에 구축되었습니다. 이 기반 위에서, 우리는 광범위한 다국어 기능을 유지하면서도 특정 언어 생태계 내에서 성능을 어떻게 강화할 수 있을지 탐구했습니다.
TinyAya-base는 지역 전반에 걸쳐 일관된 다국어 기반을 제공합니다. 특화 모델들은 이 기반을 확장하여 아프리카, 남아시아, 아시아·태평양 등 특정 언어 커뮤니티에 더욱 집중하면서도, 해당 주요 지역 외에서도 강력한 성능을 유지합니다.
이러한 접근 방식을 통해 각 모델은 더 강력한 언어적 기반과 문화적 뉘앙스를 갖출 수 있으며, 결과적으로 대상 커뮤니티에 더 자연스럽고 신뢰할 수 있는 시스템으로 구현됩니다. 동시에 모든 Tiny Aya 모델은 광범위한 다국어 지원 기능을 유지하여, 추가적인 최적화 및 연구에 유연하게 활용할 수 있는 기반이 됩니다.
그 결과, 지역별 특화 모델로 구성된 체계적인 모델 패밀리가 탄생했습니다:
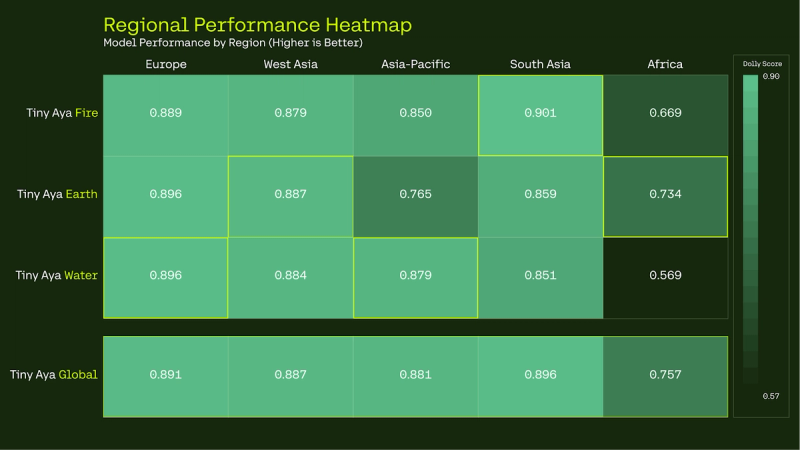
- TinyAya-Earth: 아프리카 및 서아시아 지역 언어에 최적화
- TinyAya-Fire: 남아시아 언어에 최적화
- TinyAya-Water: 아시아·태평양 및 유럽 지역에 최적화
이 모델들은 글로벌 균형을 맞춘 기본 옵션과 지역 특화 모델을 모두 제공하여, 연구자와 개발자가 자신의 사용 사례에 맞는 최적의 언어 지원 범위를 선택할 수 있도록 합니다.
지금 Tiny Aya를 체험해 보세요
Tiny Aya는 현재 오픈 웨이트 모델로 제공됩니다. 사용자는 다양한 방법으로 Tiny Aya 모델 패밀리를 탐색하고 활용할 수 있습니다:
- Hugging Face Space에서 즉시 체험해 보세요 또는 Cohere 플랫폼에서 이용 가능합니다.
- 로컬 배포 및 연구를 위해 Hugging Face 및 Kaggle에서 모델 가중치를 다운로드할 수 있습니다.
- Tiny Aya의 학습 전략, 종합 평가 및 설계 결정 사항을 상세히 설명한 상세 기술 보고서에서 더 자세한 내용을 확인하세요.
- Tiny Aya를 활용해 개발을 시작해 보시겠어요? Expedition Tiny Aya에 대해 자세히 알아보세요. 이는 Tiny Aya 모델 제품군을 활용해 새로운 프로젝트를 추진할 수 있도록 설계된 멘토 지원 다단계 연구 챌린지입니다.
*TinyAya-Base는 암하라어, 아랍어, 바스크어, 벵골어, 불가리아어, 버마어, 광동어, 카탈로니아어, 중국어(간체 및 번체), 크로아티아어, 체코어, 덴마크어, 네덜란드어, 영어, 에스토니아어, 핀란드어, 프랑스어, 갈리시아어, 독일어, 그리스어, 구자라트어, 하우사어, 히브리어, 힌디어, 헝가리어, 이보어, 인도네시아어, 아일랜드어, 이탈리아어, 일본어, 자바어, 크메르어, 한국어, 라오어, 라트비아어, 리투아니아어, 말라가시어, 말레이어, 몰타어, 마라티어, 네팔어, 나이지리아 피진어, 노르웨이어(보크말), 페르시아어, 폴란드어, 포르투갈어, 펀자브어, 루마니아어, 러시아어, 세르비아어, 쇼나어, 슬로바키아어, 슬로베니아어, 스페인어, 스와힐리어, 스웨덴어, 타갈로그어, 타밀어, 텔루구어, 태국어, 터키어, 우크라이나어, 우르두어, 베트남어, 웨일스어, 월로프어, 코사어, 요루바어, 줄루어를 포함한 70개 이상의 언어를 지원합니다.
Tiny Aya: 모델 규모와 다국어 성능의 조화 (2026), 저자: Alejandro R. Salamanca, Diana Abagyan, Daniel D’souza, Ammar Khairi, David Mora, Saurabh Dash, Viraat Aryabumi, Sara Rajaee, Mehrnaz Mofakhami, Ananya Sahu, Thomas Euyang, Brittawnya Prince, Madeline Smith, Hangyu Lin, Acyr Locatelli, Sara Hooker, Tom Kocmi, Aidan Gomez, Ivan Zhang, Phil Blunsom, Nick Frosst, Joelle Pineau, Beyza Ermis, Ahmet Üstün, Julia Kreutzer, Marzieh Fadaee. https://arxiv.org/abs/2603.11510


