









오늘, Cohere의 연구 부문인 Cohere For AI는 23개 언어에서 탁월한 성능을 발휘하며 다른 주요 오픈 웨이트 모델들을 능가하는 고성능 다국어 모델 패밀리인 Aya Expanse를 발표하게 되어 기쁘게 생각합니다.
당사는 다국어 연구에 대한 지속적인 헌신과 다국어 AI 기술의 발전을 가속화하기 위해, Kaggle과 Hugging Face에서 이용 가능한 80억 및 320억 파라미터의 오픈 웨이트 모델로 Aya Expanse를 출시합니다. 80억 파라미터 모델은 전 세계 연구자들이 더 쉽게 혁신적인 성과를 거둘 수 있도록 돕고, 320억 파라미터 모델은 최첨단 다국어 성능을 제공합니다.
Aya Expanse는 LLM의 고품질 언어 커버리지를 확장하는 중요한 단계입니다. 2년 전 Aya 이니셔티브를 처음 시작한 이후, 당사는 119개국 3,000명 이상의 연구자들과 협력하여 최첨단 다국어 연구를 확장해 왔습니다. 여기에는 5억 1,300만 개의 예제로 구성된 현재까지 최대 규모의 다국어 데이터셋 컬렉션인 Aya 컬렉션과 다국어 성능 및 안전성에 대한 핵심 평가 세트를 출시하는 것이 포함되었습니다. 또한 101개 언어를 지원하는 현재까지 가장 포괄적인 다국어 모델인 Aya-101을 출시했습니다.
다국어 연구의 성과 조명
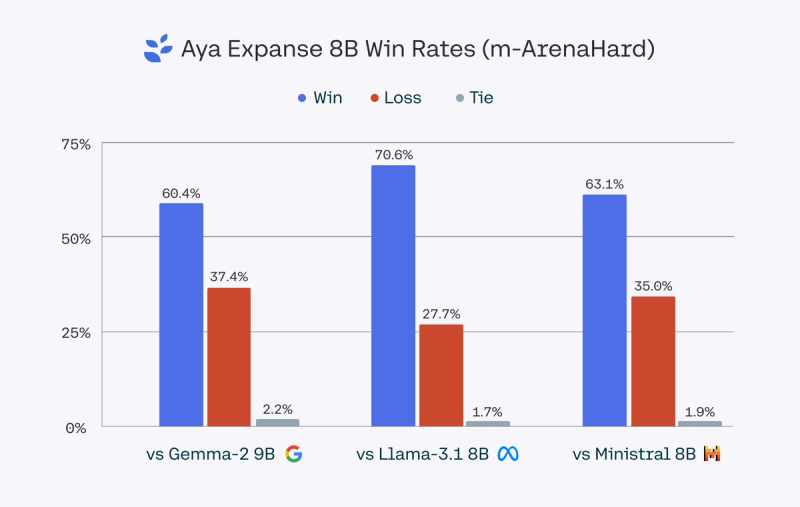
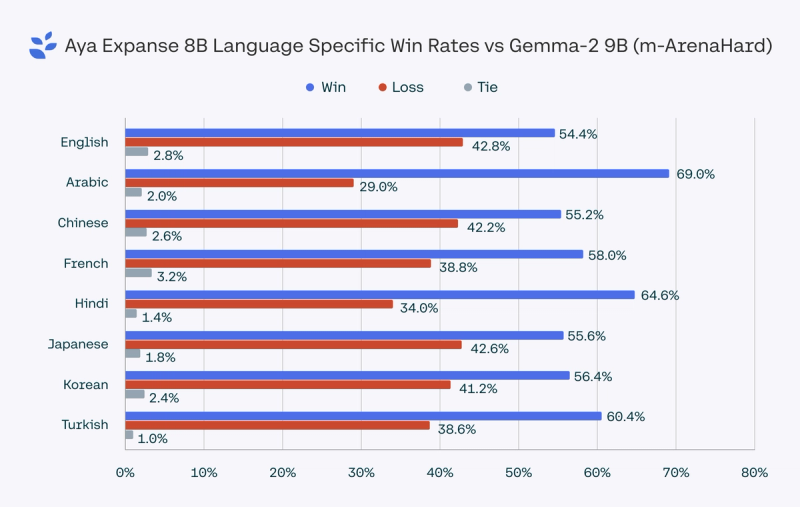
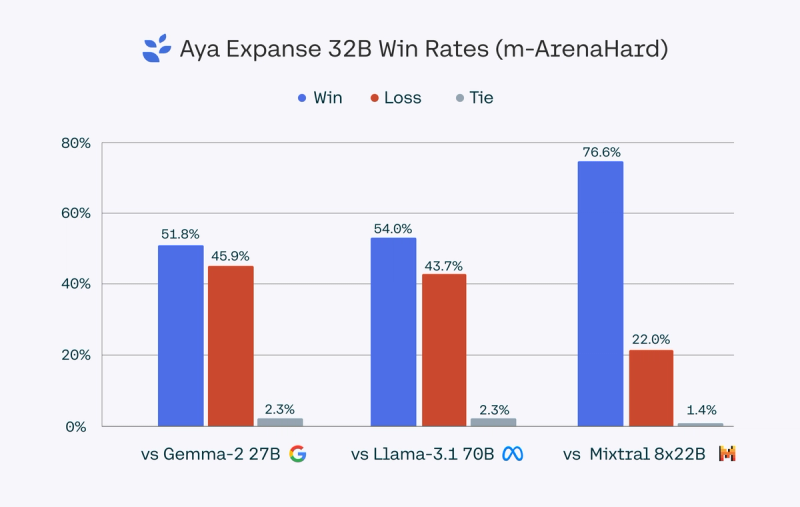
더 넓은 범위에서, Aya Expanse 32B는 Gemma 2 27B, Mistral 8x22B, 그리고 모델 크기가 2배 이상 더 큰 Llama 3.1 70B를 능가하며 다국어 성능의 새로운 기준을 세웠습니다. 또한 Aya Expanse 8B를 출시했으며, 이 모델은 Gemma 2 9B, Llama 3.1 8B, 그리고 최근 출시된 Ministral 8B와 같은 동일 파라미터 클래스의 주요 오픈 웨이트 모델들을 60.4%에서 70.6%에 이르는 승률로 앞지릅니다.
Aya Expanse의 개선 사항은 머신러닝 혁신의 핵심 구성 요소를 재검토함으로써 AI가 전 세계 다양한 언어를 지원하는 방식을 확장하는 데 지속적으로 집중한 결과입니다. 지난 몇 년간의 연구 과제는 언어 격차 해소에 집중해 왔으며, 현재 성과에 결정적인 역할을 한 몇 가지 획기적인 진전이 있었습니다: 데이터 차익 활용(data arbitrage), 일반적인 성능 및 안전성을 위한 선호도 학습, 그리고 마지막으로 모델 병합(model merging)이 그것입니다. 아래에서 이 연구 내용을 자세히 소개합니다.
데이터가 부족한 언어에 대한 합성 데이터 기술 발전. 합성 데이터(전문 모델 또는 '교사' 모델이 다른 모델을 학습시키기 위해 생성한 데이터)의 활용은 LLM 개발의 핵심 요소가 되었습니다. 특히 모델 학습을 위한 데이터 소스가 고갈됨에 따라 그 중요성이 더욱 커졌습니다. 하지만 다국어 데이터, 특히 저자원 언어의 경우 우수한 교사 모델 사례가 부족하여 합성 데이터를 활용하는 데 추가적인 어려움이 있습니다.
우리는 합성 데이터에 과도하게 의존할 때 발생하는 모드 붕괴 또는 '의미 없는 문장' 생성을 방지하기 위해 '데이터 차익 활용(data arbitrage)'이라는 새로운 데이터 샘플링 전략을 제안했습니다. 데이터 차익 활용은 서로 다른 기술을 배우기 위해 여러 선생님을 찾는 인간의 학습 방식에서 영감을 얻었습니다. 피아노를 배우고 싶다면 피아노 선생님을 찾고, 제빵을 배우고 싶다면 제빵 전문가를 찾는 것과 같습니다. 우리는 동일한 철학을 AI에 적용하여, 데이터 분포에 따라 서로 다른 '교사' 모델을 전략적으로 선택함으로써 다국어 기능에 적합한 합성 데이터를 생성합니다.
모델을 글로벌 선호도에 맞게 조정. 선호도 학습은 모델 학습의 마지막 단계에서 사용되며, 인간의 피드백을 활용하여 모델이 고품질 출력물을 생성할 수 있도록 유도합니다. 우리는 이를 AI 모델 학습의 '마지막 화룡점정'이라고 생각합니다. 하지만 선호도 학습과 안전성 조치는 종종 서구 중심 데이터셋에 만연한 유해성에 과적합되는 경향이 있습니다. 문제는 이러한 안전 프로토콜이 다국어 환경으로 확장되지 못하는 경우가 많다는 점입니다. 우리의 연구는 서로 다른 문화적, 언어적 관점을 고려하여 선호도 학습을 대규모 다국어 환경으로 확장한 최초의 사례 중 하나입니다. 이를 통해 일반적인 성능과 안전성 모두에서 큰 향상을 이루었습니다.
다양한 환경에서의 모델 병합. 다국어 성능 향상을 위한 우리의 혁신적인 성과 중 마지막 단계는 모델 병합(model merging)에 관한 연구입니다. 이는 각 단계에서 여러 후보 모델의 가중치를 결합하여 더 높은 다재다능성과 성능을 구현하는 것입니다.
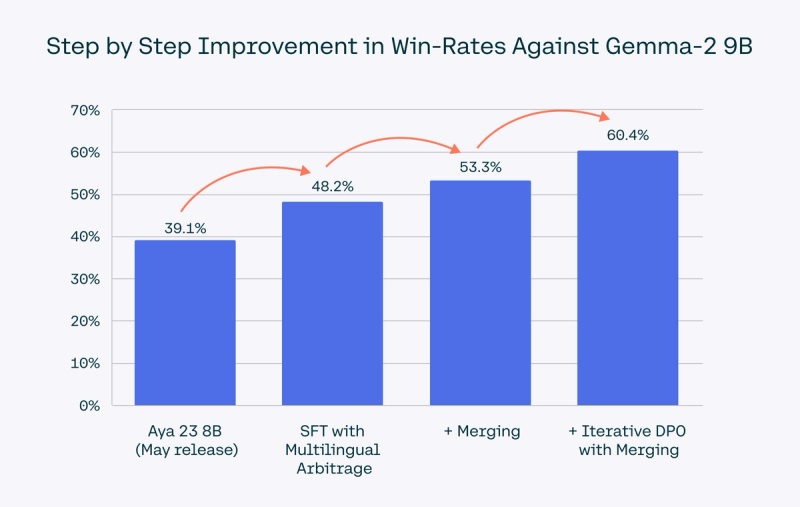
동급 최고의 다국어 모델을 구축하기 위해 저희의 연구 성과를 집약했습니다.저희는 Aya Expanse를 위해 이 모든 기술을 하나의 학습 레시피로 통합했습니다. 데이터 차익 활용부터 모델 병합 및 다국어 선호도 최적화에 이르는 각 기술은 단계별 성능 향상을 가능하게 하며, 결과적으로 동일한 파라미터 규모의 다른 선도적 모델들 대비 상당한 성능 우위를 달성했습니다. Gemma 2 9B와 비교했을 때, Aya Expanse 8B는 60.4%의 승률을 기록하며 다국어 LLM 성능 면에서 해당 클래스에서 새로운 지평을 열었습니다.
다국어 분야의 최첨단 기술 수준으로 확장
지난 1년 동안 저희가 개발한 모든 알고리즘적 혁신은 Aya Expanse에 통합되어 모델 규모가 커짐에 따라 성능이 확장되며 최첨단 수준의 성능을 구현합니다. 이러한 잠재력을 활용하기 위해 저희는 데이터 차익 활용, 선호도 학습, 모델 병합을 결합한 동일한 학습 레시피를 적용했습니다. 소형 모델과 마찬가지로, 이 레시피는 성능의 상당한 향상을 이끌어냈습니다. Aya Expanse 32B는 Gemma 2 27B, Mistral 8x22B, 그리고 훨씬 더 큰 규모의 Llama 3.1 70B보다 우수한 성능을 보이며, 23개 언어 전반에 걸쳐 51.8%에서 76.6%에 이르는 페어와이즈 승률을 기록했습니다.
이러한 결과는 소형 언어 모델을 넘어 다국어 분야에서 저희 연구의 영향력을 입증하며, 대규모 다국어 성능의 새로운 최첨단 기준을 제시합니다.
함께하기
8B 및 35B 모델의 오픈 웨이트 공개와 더불어, 저희는 다국어 AI 발전을 가속화하기 위해 광범위한 연구 생태계와 적극적으로 협력하고 있습니다. 저희의 연구 지원금 프로그램에 신청하세요, 또는 기관 간 협력을 촉진하기 위해 컴퓨팅 리소스와 전문 지식을 제공하는 저희의 차기 연구 코호트에 참여하세요.
Aya는 더 뛰어난 다국어 성능과 안전성을 실현하려는 저희의 지속적인 노력의 일환입니다. 저희 연구에 대해 여기에서 자세히 알아보세요, 그리고 저희와 함께하시길 고려해 보세요.
Aya Expanse 모델은 현재 연구자와 개발자가 Cohere API 플랫폼, Kaggle, 그리고 Hugging Face에서 이용하실 수 있습니다.
감사의 말
이 성과는 Cohere For AI와 Cohere 팀 모두의 엄청난 노력의 결실입니다. 또한 이번 릴리즈에 참여한 전 세계 220명의 언어 앰배서더로 구성된 연구 커뮤니티에도 깊은 감사를 표합니다. 성함은 가나다순으로 아래에 기재되어 있습니다:
메흐메트 에므레 악불루트 (터키/터키), 사메르 아트라 (네덜란드어, 아랍어/네덜란드), MUHDIN AWOL (영어/에티오피아), 켄자 벤키라네 (아랍어, 프랑스어/모로코), 만 반누샬리 (힌디어, 영어/인도), 이사벨라 비칼류 프라제토 (프랑스어, 포르투갈어/브라질, 프랑스), 다닐로 보이코 (우크라이나어/우크라이나), 사브리나 부마이자 (아랍어/알제리), 사무엘 카야위자야 (인도네시아어/인도네시아), 사무엘 카야위자야 (인도네시아어, 영어/인도네시아), 에미르한 첼릭 (터키어/튀르키예), 라이언 찬 (이탈리아어, 영어/영국), 오렐리앙-모건 클로드 (프랑스어/프랑스), 우르술라 체르빈스카 (폴란드어, 프랑스어/프랑스, 폴란드), 조아나 다 마타 (포르투갈어/브라질), 응우옌 다트 (베트남어/베트남), 마나스비 다와네 (힌디어/인도), 아칸크샤 데브카르 (힌디어/인도), 샤라드 두왈 (영어/네팔), 압델잘릴 엘 마조디 (아랍어/모로코), 샤파그 파다에이 (페르시아어/이란), 닐 페르난데스 (독일어, 일본어, 힌디어/캐나다), 실비아 페르난데스 (스페인어, 영어/아르헨티나), 하미드레자 가데르 (페르시아어, 네덜란드어/이란, 네덜란드), 마누엘 굴라오 (포르투갈어/포르투갈), 바삼 구티 (아랍어, 튀니지 방언/튀니지), 마리아 그란두리 (스페인어/스페인), 미겔 게레로 (스페인어/스페인), 시데시 군잘 (힌디어/인도), 모하메드 함디 (아랍어, 영어/이집트), 하페드 히치리 (아랍어, 프랑스어/튀니지), 누 호앙 안 쿠인 (일본어, 베트남어/일본, 베트남), 카일 하워드 (영어, 스페인어/미국), 현지원 (한국어/대한민국), 조셉 마빈 임페리얼 (필리핀어/필리핀), 부린 인타춘 (일본어/일본), 라이언 주네조 (영어, 힌디어/캐나다), 후안 훈케라스 (스페인어/아르헨티나), 카르틱 레디 칸줄라 (영어, 힌디어/미국, 인도), 알버트 카오 (중국어/대만), 모르테자 카샤니 (페르시아어/이란), 아흐메드 칼레드 (아랍어/이집트), 니하리카 칸나 (힌디어, 펀자브어/인도), 디피카 쿨라르 (힌디어/미국, 인도), 크리스토퍼 클람 (독일어/독일), 나자르 코후트 (우크라이나어/우크라이나), 알키스 쿠두나스 (이탈리아어, 그리스어/이탈리아, 그리스), 디아나 코자체크 (독일어, 우크라이나어/독일), 카트리나 로런스 (영어, 프랑스어, 독일어/캐나다), 제임스 레온 (스페인어/에콰도르), 리자정 (중국어/중국, 영국), 니콜로 로도 (이탈리아어/이탈리아), 단테, 푸온 록 (중국어, 영어/홍콩), 이로 말타 (그리스어, 독일어/그리스, 독일), 하라스 만수르 (우르두어/파키스탄), 바브닉 민하스 (힌디어/인도), 샤차르 미르킨 (히브리어), 로아 모하메드 (아랍어/요르단), 이양 난 (중국어/중국), 스리 하르샤 넬라투루 (힌디어, 독일어/인도, 독일), 예카테리나 노비코바 (영어, 러시아어/캐나다), 로니 오바이드 (아랍어, 영어/시리아), 올림피아 오티에노 (영어/케냐), 에네스 외즈괴즐러 (터키어/터키), 야부즈 알프 센처 외즈투르크 (터키어/터키), 카를로스 파티뇨 (스페인어/콜롬비아), 제비시 푸르베이 (영어, 힌디어/네팔), 마리아 키하노 헤수룸 (스페인어/콜롬비아), 스와티 라즈왈 (힌디어, 영어/미국), 디디 람사란 친 (스페인어, 영어/베네수엘라), 디비야라즈 라나 (힌디어, 영어/미국), 아디티아 레트난토 (인도네시아어/인도네시아), 로드리고 리베이루 고메스 (포르투갈어/브라질), 에스라 살레 (영어, 아랍어/캐나다), 로샨 산토시 (힌디어/인도, 미국), 드리슈티 샤르마 (힌디어, 스페인어/인도, 스페인, 라틴 아메리카 국가), 킨자 셰이크 (우르두어/파키스탄), 아디티아 슈리바스타바 (힌디어, 영어/인도, 아일랜드), 비베크 실림칸 (힌디어, 영어/인도), 마르야나 스켄둘리 (영어, 이탈리아어/알바니아), 소함 소나르 (힌디어, 마라티어/인도), 귀르칸 소이칸 (터키어/튀르키예), 데이비드 스티븐 (포르투갈어/브라질), 앤서니 수세브스키 (영어/캐나다), 아드리안 시미착 (폴란드어/폴란드), 조앤 탄 (영어, 중국어/싱가포르), 퀜틴 타르디프 (프랑스어/프랑스), 아미드 테일러 (영어, 독일어/미국, 독일), 요르고스 찰리키디스 (그리스어/그리스), 로만 팀치우 (우크라이나어/우크라이나), 무함마드 사드 우딘 (독일어/독일), 루이 울머 (프랑스어/프랑스), 순다르 스리파다 V. S. (영어/미국), 프레디 바거스 (영어, 스페인어/미국), 블라드 바실레스쿠 (루마니아어/루마니아), 카란 베르마 (영어, 힌디어/인도), 헨리 보 (베트남어/베트남), 민 치엔 부 (일본어, 베트남어/일본, 베트남), 히에우 부 (베트남어/베트남), 아즈민 투시크 와시 (영어, 힌디어, 아랍어, 스페인어/방글라데시), 워런 윌리엄스 (영어/미국), 조셉 윌슨 (프랑스어/캐나다), 구스티 위나타 (인도네시아어/인도네시아), 에게 야쿠트 (터키어, 영어/튀르키예), 에라이 야파즈치 (터키어/터키), 타하 야신 (아랍어, 프랑스어/모로코), 세르한 일마즈 (터키어/터키), 한나 유힘렌코 (우크라이나어/우크라이나), 마이크 장 (네덜란드어/네덜란드).


